4.3 检查点 (Checkpoints) 与状态持久化
4.3 检查点 (Checkpoints) 与状态持久化
进程挂了怎么续
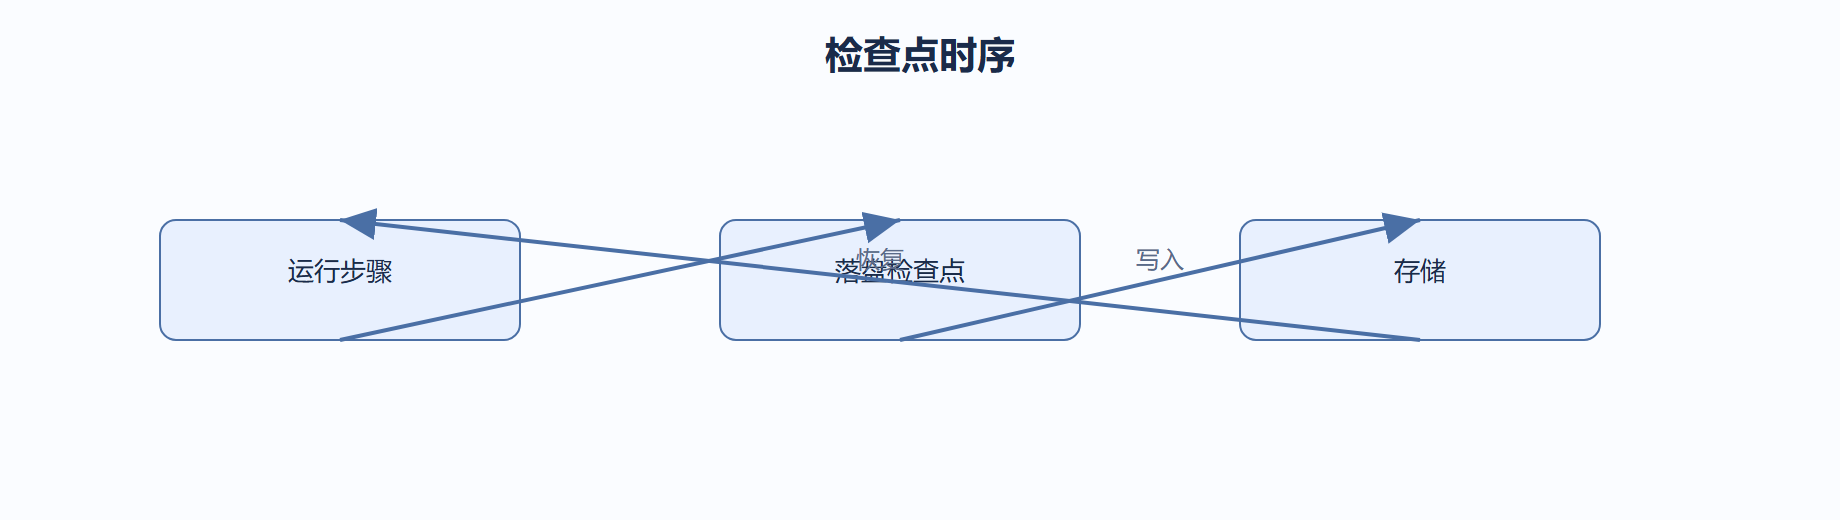
本节在全册位置:持久化是第四章核心。检查点是每次状态更新后的快照,存进 MemorySaver(内存)或 Sqlite/Postgres(持久)。同一 thread_id 的多次 invoke 共享状态,进程重启也能接着跑。我们把检查点视为「把长任务变成可恢复任务」的开关。
机制:thread_id 与快照栈
compile(checkpointer=saver) 后,每次 invoke 必须带 config={"configurable": {"thread_id": ...}}。每个 thread_id 对应一条运行轨迹,含多个检查点(按步)。get_state 取最新,get_state_history 遍历历史,可 fork 从某历史点分叉。类比物理:thread_id 像实验编号,检查点像每次观测的胶片。没有 thread_id,检查点就不知道归哪个轨迹。
from langgraph.checkpoint.memory import MemorySaver from langgraph.graph import StateGraph, START, END from typing import TypedDict class S(TypedDict): n: int def a(s: S): return {"n": s["n"] + 1} b = StateGraph(S) b.add_node("a", a) b.add_edge(START, "a") b.add_edge("a", END) saver = MemorySaver() g = b.compile(checkpointer=saver) cfg = {"configurable": {"thread_id": "demo"}} print(g.invoke({"n": 0}, cfg)) # {'n': 1} print(g.invoke({"n": 0}, cfg)) # {'n': 2} 状态跨调用累积 print(g.get_state(cfg).values) # 最新快照
# 持久化换成 SQLite,进程重启仍可续 from langgraph.checkpoint.sqlite import SqliteSaver with SqliteSaver.from_conn_string("checkpoints.db") as saver: g = b.compile(checkpointer=saver) g.invoke({"n": 0}, cfg) # 这是量产级智能体与自然原型的分界点
案例:长任务断点续跑
背景:生成研报要十分钟,中途容器被调度走,用户不想从头等。
操作:每步检查点落库,重启后用同一 thread_id invoke,从断点继续。
结果:用户无感,不必从头生成,成本与体验都改善。
解读:检查点让「长任务」变成「可恢复任务」,是量产前提,也是合规审计的基础。
变式:配合 fork 可从历史某步试不同结尾,做 A/B 生成,不用重跑前面所有步骤。
工程清单
-
同一 thread_id 的多次 invoke 共享状态,进程重启也能续,thread_id 标识一条运行轨迹。
-
get_state_history 可遍历历史快照,支持从某历史点 fork 分叉,做 A/B 生成不需重跑。
-
MemorySaver 内存、Sqlite/Postgres 持久,按是否需要跨进程选,接口一致。
常见误区
忘带 config 里的 thread_id,每次 invoke 都从空白开始,检查点形同虚设;thread_id 是持久化的总开关,漏了它前面所有设计都落空。
三种 checkpointer 的选型表
checkpointer 的选择直接决定「能恢复到什么程度」,从开发到生产按需升级:
| 实现 | 存储 | 重启可续 | 适用 |
|---|---|---|---|
| MemorySaver | 进程内存 | 否 | 本地调试、单进程测试 |
| SqliteSaver | SQLite 文件 | 是 | 单机小规模、原型转量产 |
| PostgresSaver | PostgreSQL | 是 | 多实例、并发、生产标配 |
选型要点:MemorySaver 一旦进程退出状态全丢,只配开发期用;SqliteSaver 单机够用、零运维;PostgresSaver 支持多实例共享检查点库,横向扩展时是唯一靠谱的选择。三者的接口完全一致,从 MemorySaver 切到 PostgresSaver 只需要换一行构造代码,图与节点一行不改——这是把接口抽象做好的红利。
检查点 API 三件套
配合检查点常用的三个 API,用途各不相同,别混用:
state = g.get_state(config) # 取最新快照,看当前进度 history = g.get_state_history(config) # 遍历历史快照,按时间倒序 g.update_state(config, {"draft": "改"}) # 直接覆盖某一步的状态,测试/纠错用
get_state_history 返回的是按时间倒序的检查点序列,每个快照带 ts 时间戳和 next 字段(接下来要执行谁)。update_state 是在不重跑的情况下直接改状态,常用于测试里伪造中间态,或人工修正后从修正点继续。把「读最新、遍历历史、主动改」三件事分清楚,调试和测试的速度会快很多。
检查点的体积控制
检查点每次状态更新都落一份快照,体积直接决定写入速度与存储成本,三招控制:
- 状态瘦身:只留跨节点数据,大文本用 id 替代(第四章第一节已讲)。
- 通道裁剪:低频大字段可以不在每次快照都落盘,按通道配置持久化策略。
- 生命周期:定期清理旧 thread,给检查点库设保留期,避免无限膨胀。
# 通道级控制:大字段只存引用或排除出快照 # 具体开关在 compile 的 checkpointer 配置里声明 g = b.compile(checkpointer=saver, store=...) # 可配 store 分层存储
判断「哪条通道重」用上一节的可观测性手段:从 get_state_history 里比较相邻快照的字段变化量,变化大又频繁的通道就是主要开销。先瘦最大的那一条,收益通常立竿见影。