6.3 性能优化
6.3 性能优化
图还能更快吗
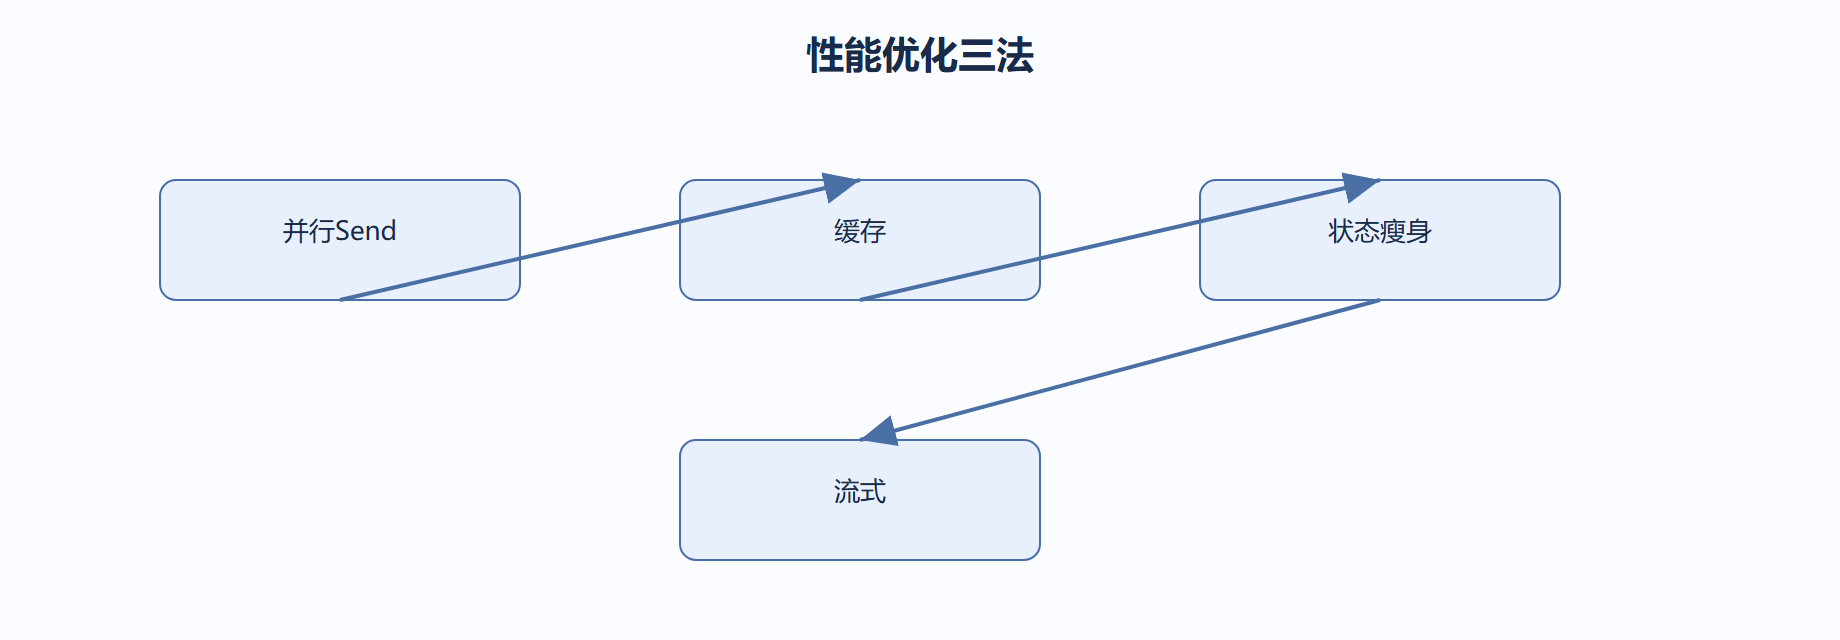
本节在全册位置:性能瓶颈多在三处——节点内同步 IO、重复模型调用、超大状态序列化。对应解法是并行(Send)、缓存、精简状态与用流式降低首字延迟。我们把优化当「先量后改」,没数据不动手。
优化:并行、缓存、瘦身
无依赖节点用 Send 并行(见 3.5);工具结果加缓存避免重复调用;状态只留必要字段减小检查点;首字延迟用 messages 流式掩盖。对超长循环,考虑把多轮合并成批处理。类比物理:优化像给管路加旁通、去弯头、缩口径。并行是免费午餐,但有 IO 时才免费。
# 缓存工具结果,避免重复外呼 from functools import lru_cache @tool @lru_cache(maxsize=128) def search(q: str): return _real_call(q) # 并行无依赖节点 from langgraph.graph import Send def split(s): return [Send("worker", {"x": i}) for i in range(5)] # 扇出要加并发上限,防止打垮下游
# 精简状态:只存 id 不存全文 class S(TypedDict): doc_ids: list # 而非 doc_texts # 状态瘦身是性价比最高的优化,往往被忽视
案例:串行改并行
背景:三个独立检索串行跑,累计 3 秒,用户体验明显卡顿。
操作:用 Send 扇出到三个 worker 并行。
结果:总耗时降到约 1 秒,取最慢而非求和。
解读:无依赖就别串行,图的并行是免费午餐(有 IO 时),但记得加并发上限。
变式:加并发上限,防止扇出把下游打挂,性能与稳定要一起考虑。
工程清单
-
无依赖节点用 Send 并行,工具结果加缓存避免重复外呼,状态只留必要字段减小检查点。
-
首字延迟用 messages 流式掩盖,超长循环考虑把多轮合并成批处理。
-
并行是免费午餐但有 IO 时才免费,扇出要加并发上限防止打垮下游。
常见误区
把三个独立检索串行跑,总时长取求和而非最慢,白白多等;无依赖就别串行,但并发上限要和稳定一起考虑,否则性能好了下游崩了。
流式降低首字延迟
用户感知的「快」往往是首字延迟,而非总时长;用消息流式把生成边生成边吐,体感立刻改善。
# stream_mode="messages":逐 token 流出 for chunk, meta in g.stream(input, cfg, stream_mode="messages"): if chunk.content: print(chunk.content, end="", flush=True) # 两者叠加,体感与真实都快
| 优化手段 | 作用层面 | 收益 |
|---|---|---|
| Send 并行 | 生成 | 总时长↓ |
| 工具缓存 | 外呼 | 调用↓ |
| 状态瘦身 | 序列化 | 检查点↓ |
| 流式 | 呈现 | 首字↓ |
⚠️ 常见坑:只在总时长上优化却忽略首字,用户仍觉得卡;流式改动小、体感强,常是性价比最高的第一刀。
💡 关键直觉:并行与流式解决不同问题——并行省真时间,流式省感知时间,上线前两者都要有。
优化前的测量脚本
「先量后改」不是口号,落成一段可复用脚本才有意义。测量目标只有一个:找出总耗时里占比最大的节点。
# 用检查点历史拆解各节点耗时 def profile_run(g, input, cfg): snaps = list(g.get_state_history(cfg)) rows = [] for prev, cur in zip(snaps[1:], snaps[:-1]): dt = float(cur.ts) - float(prev.ts) if cur.ts else 0 rows.append((cur.next, round(dt, 3))) rows.sort(key=lambda r: -r[1]) for name, dt in rows[:5]: print(name, dt, "s")
跑三次取中位数再下结论,避免单次抖动误导。测量结果出来先做「二八分」:把最大的那个节点的时间搞明白,是模型调用、IO 还是序列化。这三类问题的解法完全不同,用测量先定位类别,再选手段。
模型调用层的三个优化
模型调用通常是智能体图的头号耗时来源,三个方向按收益排序:
- 减少调用次数:合并相似请求、复用上下文、能缓存的缓存。
- 缩短单次调用:换更快模型、精简 prompt、限制输出长度。
- 并发化调用:多路独立请求并行发起,总时长取最慢不取求和。
# 语义缓存:相同问题不再调模型 _cache = {} def ask(q): if q in _cache: return _cache[q] ans = model.invoke(q) _cache[q] = ans return ans
缓存要带失效策略与命中统计,否则要么数据过期、要么命中率不可见。并发化的前提是请求间无依赖,且下游能承受并发——这两条都满足,模型层的并行才有收益。
检查点写入的隐藏成本
状态大、快照频繁时,检查点写入会成为隐形瓶颈。症状是「单个节点不快,但整体偏慢」,因为每步都有一笔序列化 + 落库开销:
| 手段 | 做法 | 收益 |
|---|---|---|
| 状态瘦身 | 只留跨节点字段 | 每次快照变小 |
| 通道裁剪 | 大字段不进快照 | 落库变快 |
| 批处理 | 少步多量替代多步少量 | 减少快照次数 |
| 异步写 | 检查点异步化 | 主线程不被拖 |
# 快照次数与状态大小同时下降,写入成本线性改善 # 例:把 10 次小步合并成 2 次大步,快照从 10 次降到 2 次
排查检查点是否拖慢:把 checkpointer 换成 MemorySaver 对比耗时,差异明显就是落库开销。生产里 PostgresSaver 的写入也要盯连接池,连接排队比序列化更常见。性能优化收尾时,把「测量前后对比」记录下来,每次优化是否有效一目了然。
扇出并发的上限控制
Send 并行是免费午餐,但并发数不设上限,最坏情况是「性能好了、下游崩了」。控制并发有两条路:入口处限制一次扇出的总量,或用信号量限制同时执行的工具调用。实际项目里两层一起用最稳:总量上限防单次请求失控,信号量防并发请求叠加。设上限时看一眼下游的真实吞吐,取它的七成当阈值,既能吃饱又留余量。加了上限后一定要回归测一次高峰流量,确认没有把并行收益吃光。