6.4 声学超材料与智能声学
6.4 声学超材料与智能声学
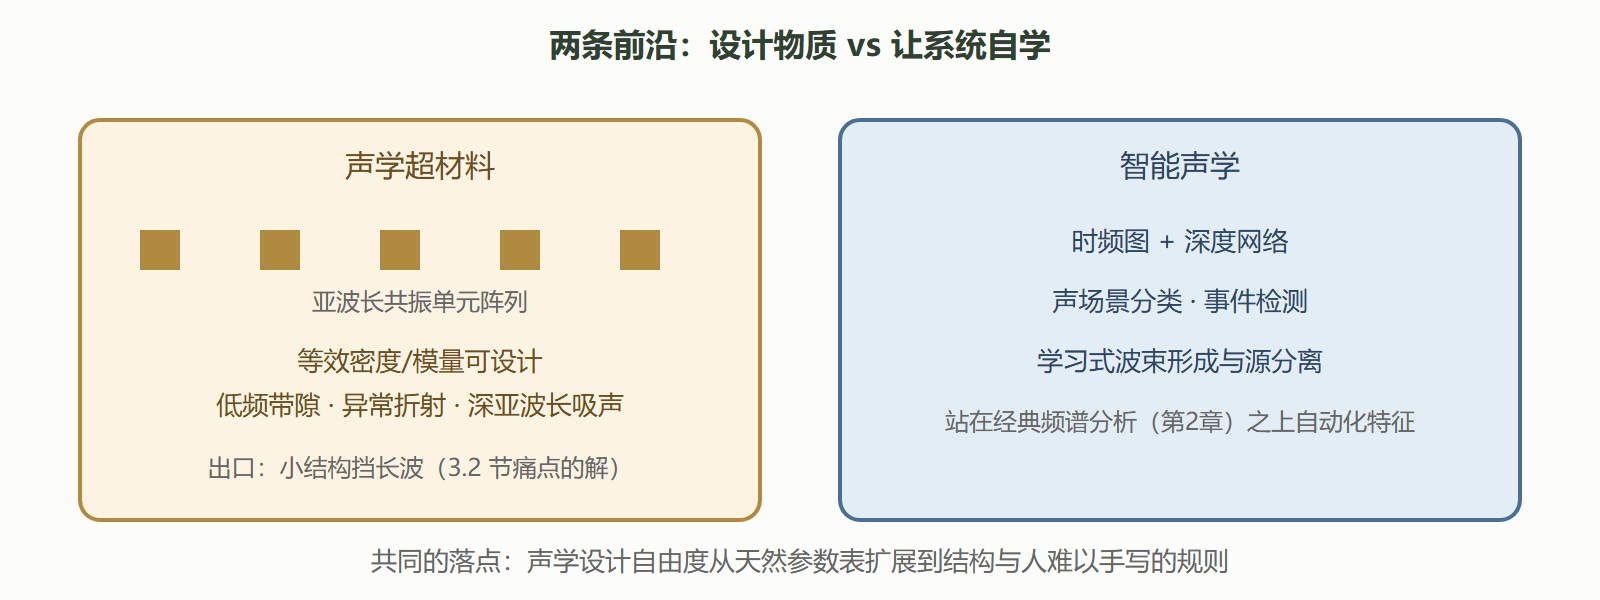
声学超材料以亚波长周期或共振单元重写等效密度与体积模量,制造带隙、负折射与异常吸声;智能声学用机器学习完成声场景分类、源定位与端到端语音增强。两条前沿共同把声学从"选材料"推进到"设计物质"与"让系统自己学"。
全册最后一节。前五章的材料库、算法库、仿真链都建立在一个前提上:参数表里有什么就用什么。超材料打破参数表,机器学习打破"规则由人写"——证据链的最新两环。
布拉格带隙与局域共振
周期结构对波有一个普遍纪律:当周期长度接近半波长,不同单元的散射波相消干涉,某些频段无法传播——带隙。声子晶体靠布拉格散射造带隙,但周期必须半波长量级, audible 低频意味着米级结构,不实用。2000 年提出的局域共振声学超材料改变游戏:在基体中埋入局域共振单元(如铅球包软胶层),单元在自身共振频率附近剧烈反相振动,等效参数在该频段变负或剧变,几十毫米的结构就能挡住几百赫兹的声波——"小结构挡长波",突破了布拉格限制。亥姆霍兹共振器阵列(3.2 节)的深腔吸声、薄膜型超材料的低频吸声,都是同一思想的不同装法。
import numpy as np def lorentz_eff(f, f0=300.0, gamma=0.08, frac=0.6): """单共振单元的等效质量密度(Lorentz 模型,归一化)""" f = np.asarray(f, float) return 1 - frac*f0**2/(f**2 - f0**2 + 1j*gamma*f0*f) f = np.array([150, 250, 290, 300, 320, 400, 600]) rho_eff = lorentz_eff(f) print("频率(Hz) 等效密度实部") for fi, r in zip(f, rho_eff): tag = " <- 负等效密度" if r.real < 0 else "" print(f"{fi:6d} {r.real:+7.2f}{tag}") # 150 +0.30 # 250 +1.14 # 290 +7.86 <- 接近共振,参数发散 # 300 -0.13 <- 负等效密度 # 320 -2.29 <- 负等效密度 # 400 +0.59 # 600 +0.82 # 共振频率上方一段频带内等效密度为负:波在其中无法携带实数波矢 —— 带隙。
负等效密度(或负体积模量,甚至双负)区间就是带隙——波方程在这些频段没有实数解,声被结构性反射。用亚波长单元做到这一点,意味着地铁隔声屏、变压器降噪可以摆脱"厚度换低频"的宿命(3.2 节的痛点在此看到出口),代价是带隙窄、损耗与鲁棒性问题仍在攻关。
机器学习进入声学的三条路
声场景分类与事件检测:从时频图出发,把卷积网络的图像识别能力直接搬给声谱——城市噪声地图自动标注、设备故障听诊、鸟类声学监测,输入端与第2章的取证工具完全同源。传统+学习混合阵列信号处理:用网络学习波束形成权重或掩蔽,在混响与噪声里分离目标声源,比经典 MVDR(5.2 节)更抗模型失配。端到端语音增强:输入带噪波形,输出去噪波形,网络隐式学会了噪声的统计规律——代价是黑箱化,工程落地仍要靠客观指标(PESQ、STOI)与人听评测双重把关。
import numpy as np # 声场景特征的"手工 vs 学习"对照:MFCC(经典)的骨架极简复现 def mfcc_energy(sig, fs, n_filt=20): frame = sig*np.hanning(len(sig)) spec = np.abs(np.fft.rfft(frame))**2 f = np.fft.rfftfreq(len(sig), 1/fs) # 三角滤波器组:低频密、高频疏(mel 尺度,模仿临界频带,呼应第2章) edges = 700*(10**(np.linspace(0, np.log10(1 + (fs/2)/700), n_filt+2)-1)) edges = np.interp(edges, [0, fs/2], [0, len(f)-1]).astype(int) energy = [np.sum(spec[edges[i]:edges[i+2]]) for i in range(n_filt)] return 10*np.log10(np.maximum(energy, 1e-12)) rng = np.random.default_rng(3) fs, t = 16000, np.arange(16000*0.5)/16000 voice_like = np.sin(2*np.pi*180*t) + 0.5*np.sin(2*np.pi*900*t) + 0.1*rng.standard_normal(len(t)) fan_like = 0.3*rng.standard_normal(len(t)) + 0.2*np.sin(2*np.pi*120*t) e1, e2 = mfcc_energy(voice_like, fs), mfcc_energy(fan_like, fs) print(f"语音样例低频段/高频段能量比:{np.mean(e1[:5])-np.mean(e1[-5:]):+.1f} dB") print(f"风扇样例低频段/高频段能量比:{np.mean(e2[:5])-np.mean(e2[-5:]):+.1f} dB") # 两类声源在 mel 滤波器组能量上轮廓分明 —— # 人工特征已经能分;深度模型做的事是把这个"特征设计"自动化并推向极限。
(输出数值随随机种子浮动,两类样例的谱轮廓差异稳定。)这段代码的意义在于看清连续性:mel 滤波器组模仿听觉临界频带(第2章),MFCC 是它的压缩表示——机器学习不是推翻经典声学,而是站在频谱分析五十年积累上把特征设计自动化。
图:声学超材料与智能声学的两条前沿路径
⚠️ 常见坑:把超材料当成"万能隔声棉"——带隙窄、角度敏感、样品一致性难保证;把神经网络当成"免建模"——数据分布外性能崩塌是常态,声学域知识(特征、物理约束)仍是泛化的骨架。
本节要点回顾
- 布拉格带隙需要半波长周期;局域共振超材料以亚波长单元在共振附近造负等效参数,小结构挡长波
- 负等效密度/模量区间即带隙:波方程无实数解,声被结构性反射
- 机器学习三条路:声场景识别、学习式波束形成、端到端增强;输入端与经典频谱同源
- mel 滤波器组模仿临界频带:学习模型是经典声学特征工程的自动化延伸
- 两条前沿的落点一致:扩展设计自由度,但物理约束与数据边界仍是裁判
全册至此收束:从声压的一个帕斯卡起伏,到设计物质与训练系统——声音的证据链,环环可验证。