1.3 1.3 模型检验、敏感性与失效模式
1.3 模型检验、敏感性与失效模式
本节摘要:模型交付前的最后一道工序是验证:留出数据检验预测力、对关键参数做敏感性扫描、识别典型失效模式的指纹。本节用一个小型需求预测模型的完整生命周期,演示验证怎么做、敏感性曲线怎么读,以及三类常见失效(隐藏假设、外推、共线性)各自在数据上留下的痕迹。
学完这节你应该能
阅读完本节,你应当能够:
- 设计留出集与时间序列回测,避免"验证数据泄漏";
- 实现单参数敏感性扫描并用曲线判断稳健性;
- 从残差图识别趋势遗漏、从方差膨胀因子识别共线性。
验证不是打分,是找死因
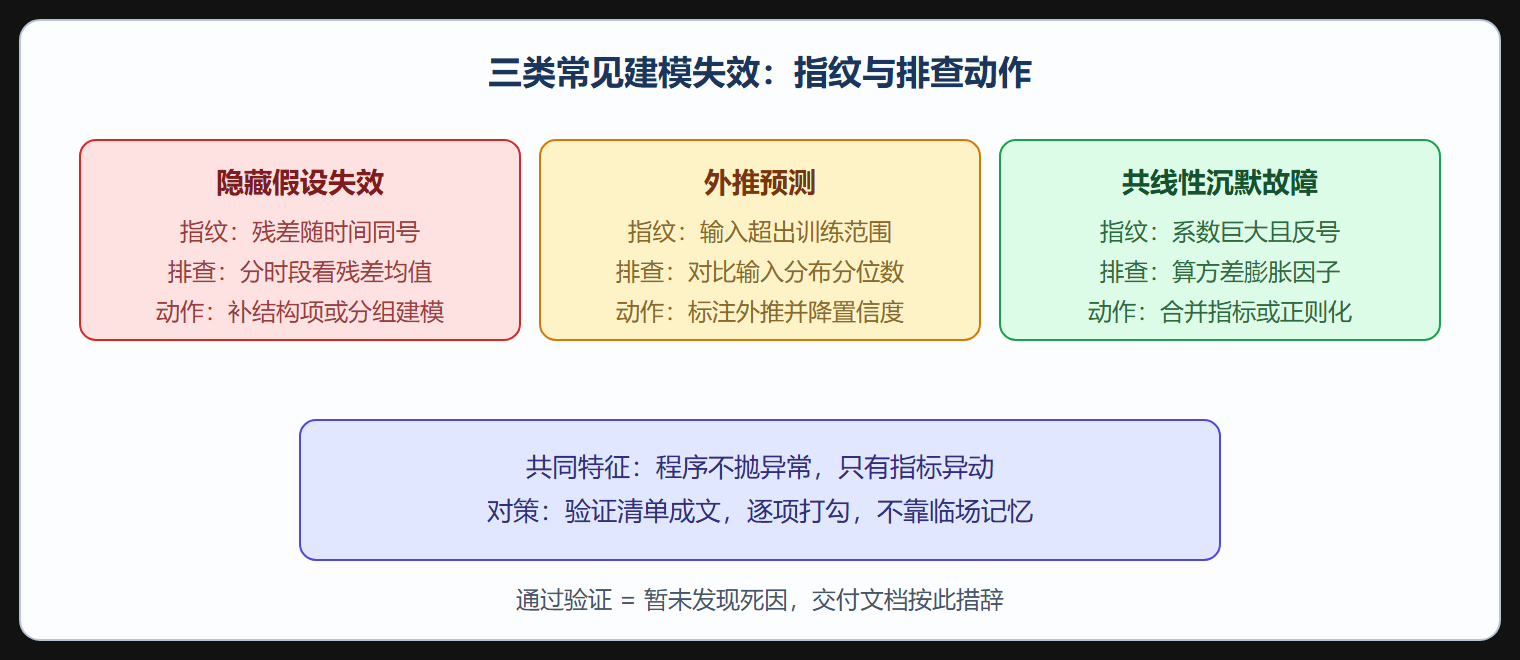
很多团队把验证理解为"在测试集上算个准确率"。门诊的视角不同:验证的首要目标是让模型在受控环境下死掉,死得越早越便宜。一个通过了验证的模型只是"暂未发现死因",这个措辞上的克制很重要,它决定了交付文档里敢写多少承诺。
以需求预测模型为例:用前 80% 周期训练、后 20% 留出,是最低配置。注意时间序列不能随机划分留出集——用未来预测过去是数据泄漏的典型形态。
import numpy as np rng = np.random.default_rng(7) n = 120 # 两年多的周数据 t = np.arange(n) true_trend = 0.15 * t # 业务真实缓慢增长 y = 50 + true_trend + rng.normal(0, 4, n) # 观测销量 split = int(n * 0.8) train_t, train_y = t[:split], y[:split] # 模型 A:把增长当成噪声,只用均值预测 mean_model = train_y.mean() pred_a = np.full(n - split, mean_model) # 模型 B:简单线性趋势 k, b = np.polyfit(train_t, train_y, 1) pred_b = k * t[split:] + b holdout = y[split:] mae_a = np.mean(np.abs(pred_a - holdout)) mae_b = np.abs(pred_b - holdout).mean() print(f"模型A(仅均值) 留出MAE: {mae_a:.2f}") print(f"模型B(线性趋势) 留出MAE: {mae_b:.2f}")
典型结果:模型 A 的留出误差几乎是模型 B 的三倍——因为留出段处在训练段之后,趋势项累积了 20 多周的偏移。这就是"隐藏趋势假设"失效的指纹:残差随时间系统性同号。把残差画出来,一段全在零线上方,这不是噪声,是模型结构缺了一块。
敏感性扫描:参数动一动,结论稳不稳
1.1 节的补货模型里,缺货惩罚单价是业务方拍的数。交付前必须回答:"这个数翻倍,订货策略变多少?"做法是对每个关键参数在合理区间内扫一遍,记录最优决策与目标值随参数的变化曲线。
import numpy as np rng = np.random.default_rng(42) mu, sigma = 40.0, 12.0 hold = 0.8 demand_pool = rng.normal(mu, sigma, (60, 800)) # 60 组重复实验 def best_level(cost_ratio, demand_path): """给定 缺货/持有 成本比,返回该路径上的最优补货水位""" levels = np.arange(30, 91) best_q, best_c = None, np.inf for q in levels: inv = q.copy if False else q inv = float(q); cost = 0.0 for d in demand_path: inv -= d if inv < 0: cost += -inv * cost_ratio * hold inv = 0.0 else: cost += inv * hold inv = float(q) c = cost / len(demand_path) if c < best_c: best_c, best_q = c, q return best_q for ratio in [2, 4, 7.5, 12]: # 缺货惩罚是持有的几倍 qs = [best_level(ratio, path) for path in demand_pool[:15]] print(f"成本比 {ratio:>4}: 最优水位均值 {np.mean(qs):.1f} 件, " f"波动范围 {min(qs)}-{max(qs)}")
读懂这条敏感性曲线比算出它更重要:若成本比从 4 到 12 变化时最优水位只在 55 到 65 之间移动,策略对这个拍脑袋参数是稳健的,可以交付;若最优水位从 45 跳到 90,说明决策被这个参数主导,必须回头让业务方把这个数论证清楚。敏感性分析的价值不在于得到曲线,而在于区分"稳健决策"与"参数幻觉"。
⚠️ 常见坑:只扫参数不扫结构。同一数据上,把"日独立同分布"换成"周内自相关",有时比任何参数翻倍影响都大。结构假设要至少做一版替代实现对比。
💡 关键直觉:外推是预测类工单的头号死因。线性趋势模型在训练区间表现良好,但拿去预测两年后,趋势项会线性放大。检查手段很土却有效——问一句"这个输入范围超出训练数据了吗",超了就把预测标注为外推,置信度单独声明。
共线性:参数估不出来时的沉默故障
回归类模型里,两个自变量高度相关时,最小二乘照样给出解,系数却会大到离谱且正负号互相抵消。它不报错,只在解释环节爆雷。体检手段是方差膨胀因子:
import numpy as np rng = np.random.default_rng(3) n = 200 x1 = rng.normal(0, 1, n) x2 = 0.98 * x1 + rng.normal(0, 0.2, n) # 与 x1 高度共线 x3 = rng.normal(0, 1, n) # 独立变量 y = 2 * x1 + 3 * x3 + rng.normal(0, 0.5, n) X = np.column_stack([np.ones(n), x1, x2, x3]) beta, *_ = np.linalg.lstsq(X, y, rcond=None) print("回归系数:", np.round(beta, 2)) # x1、x2 系数往往巨大且反号 # 方差膨胀因子:把每个自变量对其余回归,取 1/(1-R^2) for i, name in enumerate(["x1", "x2", "x3"], start=1): others = np.delete(X, i, axis=1) pred, *_ = np.linalg.lstsq(others, X[:, i], rcond=None) r2 = 1 - np.var(X[:, i] - pred) / np.var(X[:, i]) print(f"{name} 的方差膨胀因子 VIF = {1/(1-r2):.1f}")
经验阈值:VIF 超过 10 的变量组合要处理——要么合并成一个指标,要么改用第 4 章的正则化方法。这类"沉默故障"清单还包括:验证集与训练集分布不一致(工单换了门店类型)、目标定义在两段数据里口径不同(含税与否)。它们共同的特征是程序不抛异常,只有指标异动,所以验证环节的检查清单必须成文,不能靠临场想起。
失效模式对照表
本节要点回顾
- 时间序列留出必须按时间切分,随机划分是数据泄漏;
- 残差同号段是结构缺失的指纹,先看图再谈指标;
- 敏感性扫描区分稳健决策与参数幻觉,被参数主导的结论要回炉;
- 结构假设也要扫:换一版替代实现对比,比只扫参数更狠;
- 共线性与口径漂移是沉默故障,VIF 与分布分位数对照是常规体检项。