2.1 2.1 矩阵分解工具箱
2.1 矩阵分解工具箱
本节摘要:矩阵分解把一个复杂变换拆成一串简单变换的乘积,是线性代数计算的核心动作。本节比较 LU、QR、特征分解、SVD 四类分解的功能定位、计算代价与适用病情,用条件数量化"解能不能信",并给出一张选型表与求解器切换实验。
学习目标
阅读完本节,你应当能够:
- 说出四类分解各自回答的数学问题;
- 用条件数预判线性系统解的误差放大倍数;
- 在数值实验中对比直接法与分解复用的性能差异。
为什么非要分解
解一次 thousand 阶线性方程组,高斯消元本身就要做上亿次浮点乘加。但如果右端项会变(比如同一套结构模型受不同载荷),反复消元是巨大浪费。LU 分解的意义就在这里:消元过程只做一次,得到下三角 L 与上三角 U,之后每个新右端项只需两次三角回代,代价从立方级降到平方级。这是"一次分解、多次回代"的工程模式的鼻祖。
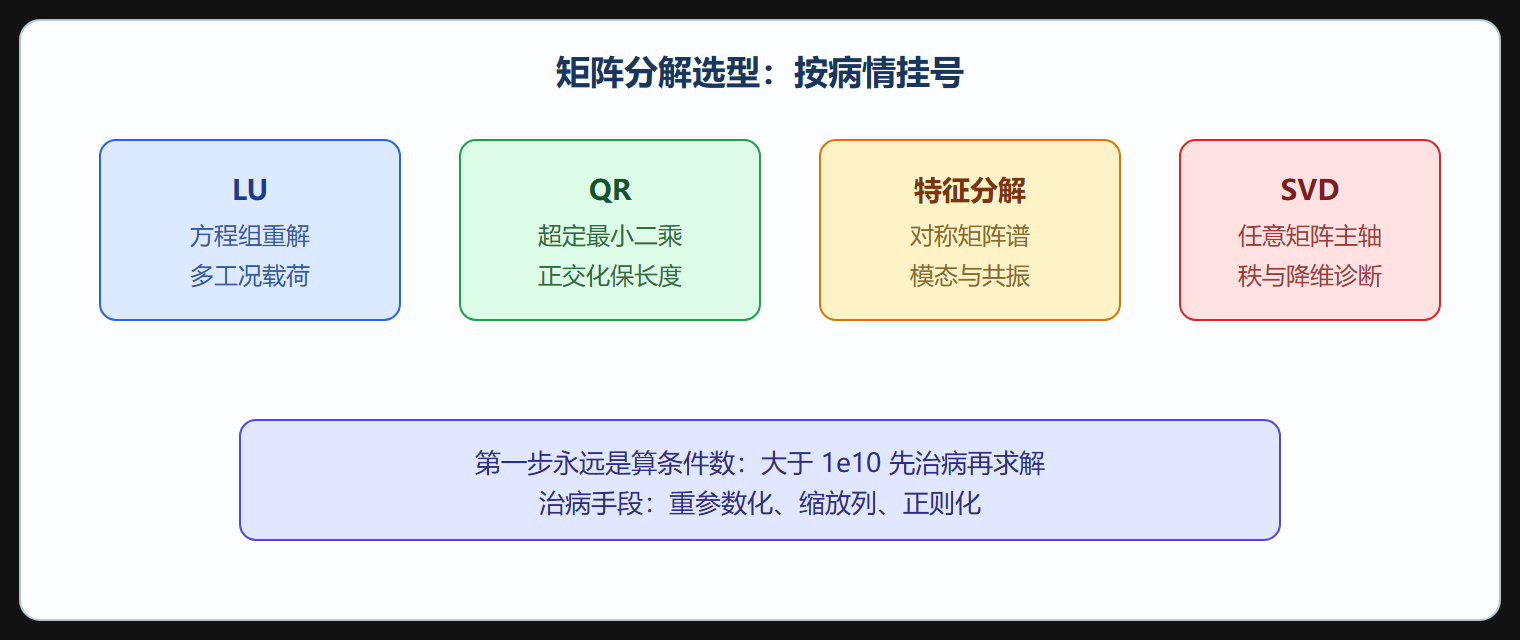
四类分解各答一问:LU 答"方程组怎么解得快";QR 答"一组列向量怎么正交化",这是最小二乘的主力;特征分解答"对称矩阵沿哪些方向只做纯伸缩";SVD 答"任意矩阵把单位球压成什么椭球",主轴方向就是奇异向量。工单来了先问病情再选刀:
| 分解 | 适用对象 | 回答的问题 | 典型工单 |
|---|---|---|---|
| LU | 一般方阵 | 方程组快速重解 | 结构刚度多载荷工况 |
| QR | 任意高矩阵 | 超定最小二乘 | 传感器标定 |
| 特征分解 | 对称方阵 | 谱与振动模态 | 共振频率分析 |
| SVD | 任意矩阵 | 数值秩与主轴 | 降维、数据压缩、病态诊断 |
条件数:解的体检指标
分解之前先看条件数。它度量输入扰动被放大到输出的倍数:条件数 10 的 12 次方的系统,双精度带来的 10 的负 16 次方相对误差会被放大到 10 的负 4 次方——解的第四位有效数字已经不可信。下面这段代码构造一个希尔伯特矩阵( notoriously 病态),观察解随阶数的崩坏过程:
import numpy as np from scipy.linalg import lu_factor, lu_solve def hilbert(n): """n 阶希尔伯特矩阵,元素为 1 除以 行列之和""" return 1.0 / (np.arange(1, n+1)[:, None] + np.arange(n)[None, :]) for n in [4, 8, 12]: H = hilbert(n) x_true = np.ones(n) b = H @ x_true # 构造精确右端项 x_num = np.linalg.solve(H, b) # 数值解 cond = np.linalg.cond(H) err = np.max(np.abs(x_num - x_true)) print(f"n={n:2d} 条件数 1e{np.log10(cond):.1f} 最大误差 {err:.2e}")
跑一遍就能看到:n 到 12 时误差已经到百分位量级。此时任何"解出来是 1.02 所以基本正确"的结论都站不住——条件数大,解就不是解,是噪声的放大器。处理手段要么换模型(第 8 章的正则化),要么把问题重参数化让矩阵自然良态。
LU 的"一次分解多次回代"用科学计算库的封装最顺手:
import numpy as np from scipy.linalg import lu_factor, lu_solve rng = np.random.default_rng(0) A = rng.standard_normal((600, 600)) + 600 * np.eye(600) # 保证可解 loads = [rng.standard_normal(600) for _ in range(20)] # 20 个工况 # 路线一:每个右端项都完整求解 import time t0 = time.perf_counter() x1 = [np.linalg.solve(A, b) for b in loads] t_direct = time.perf_counter() - t0 # 路线二:LU 一次分解,多次回代 t0 = time.perf_counter() lu, piv = lu_factor(A) x2 = [lu_solve((lu, piv), b) for b in loads] t_lu = time.perf_counter() - t0 print(f"逐次求解 {t_direct*1000:.1f} ms vs LU复用 {t_lu*1000:.1f} ms") print("两者解一致:", np.allclose(np.array(x1), np.array(x2)))
二十个工况时差距已经明显,工况数上到几百(结构分析、电力潮流的日常规模),"分解复用"与"重复消元"就是可用与不可用的区别。
⚠️ 常见坑:在迭代法收敛判据里用绝对残差代替相对误差。病态系统残差可以很小而误差巨大,判据必须把条件数算进去,或改用第 5 章的迭代残差监控。
💡 关键直觉:把 QR 想成"给一组斜着搭的脚手架找正交骨架"。格拉姆-施密特过程逐列扣除已在方向上的分量,剩下的就是正交列——最小二乘之所以偏爱 QR,是因为正交变换不改变向量长度,误差不会被变换本身放大。
四类分解的选型地图
补一课:正定与楚列斯基
对称正定矩阵(第 6 章会反复遇到这类目标函数)有一个专属快刀:楚列斯基分解,把矩阵拆成下三角乘它的转置,成本约为 LU 的一半,且数值稳定性更好。判断正定性不必真做分解——特征值全正、或顺序主子式全正、或对任意非零向量二次型取正值,三个判据任选。工程上最常见的正定来源就是转置自乘:任意矩阵乘自己的转置必半正定,加一个小正则项就严格正定——这正是最小二乘正规方程与岭回归的矩阵构造,也是它在 2.2 节反复露面的原因。
import numpy as np rng = np.random.default_rng(1) M = rng.standard_normal((40, 20)) A = M.T @ M + 1e-3 * np.eye(20) # 转置自乘加正则:正定 L = np.linalg.cholesky(A) print("重构误差:", np.max(np.abs(L @ L.T - A))) print("A 的最小特征值:", np.linalg.eigvalsh(A).min().round(6))
本节要点回顾
- 分解即流水线:复杂变换拆成简单变换的乘积,LU 拆消元、QR 拆正交化、SVD 拆主轴;
- 一次分解多次回代是大规模多工况计算的基本省钱姿势;
- 条件数先行:超过 10 的 10 次方,先重参数化或正则化,别急着求解;
- QR 保长度的特性让它成为最小二乘的首选路径;
- SVD 最通用:任何矩阵都能做,代价也最高,病情不明时它是最后的检查手段。