5.1 5.1 误差分析与数值稳定性
5.1 误差分析与数值稳定性
本节摘要:数值计算的三种误差——数据误差、截断误差、舍入误差——以不同方式污染结果;算法稳定性决定这些误差被放大还是被抑制。本节复现"相近数相减"的相消灾难与一元二次求根公式的经典翻车,演示公式重排如何起死回生,并厘清条件数(问题属性)与稳定性(算法属性)的分工。
学习目标
阅读完本节,你应当能够:
- 区分三种误差来源并说出各自的传播特征;
- 识别并修复相消误差与求和顺序问题;
- 用"问题条件数"与"算法稳定性"双维度定位数值故障。
三种误差,三种脾气
数据误差是输入本身带的(测量噪声、历史数据口径问题),算法再好也甩不掉;截断误差是用有限过程近似无限过程时自带的(泰勒展开只取有限项、迭代只跑有限步);舍入误差是浮点硬件把每个数映射到最近可表示数时产生的。前一种属于问题,后两种属于算法与机器。
三种误差的脾气不同:截断误差随步长减小而减小(有阶可循),舍入误差随运算次数增加而累积(步长减小时运算次数增加,两者此消彼长,总误差呈 U 形曲线——"步长越小越好"是错觉)。下面用一个最简单的数值微分复现这个 U 形:
import numpy as np f = np.exp x0 = 1.0 true_deriv = np.exp(1.0) print("步长 中心差分误差") for h in [1e-1, 1e-4, 1e-7, 1e-10, 1e-13, 1e-16]: approx = (f(x0 + h) - f(x0 - h)) / (2*h) err = abs(approx - true_deriv) print(f"{h:.0e} {err:.3e}")
误差从 10 的负 3 次方一路降到 10 的负 11 次方附近,然后调头向上,到 10 的负 16 次方步长时彻底崩坏——分子是两个几乎相等的数相减,有效数字在相减中同归于尽,除以极小的 h 只是把灾难放大。最优步长在中间某处,靠中心差分(误差阶从一阶升到二阶)与步长选择技巧平衡两头。
经典翻车现场:求根公式
一元二次方程的求根公式人人会用,数值上却是带病代码。判别式开根后与分母相减,相近数相减偷走有效数字:
import numpy as np def quad_naive(a, b, c): """教科书公式:直接套用""" d = np.sqrt(b*b - 4*a*c) return (-b + d) / (2*a), (-b - d) / (2*a) def quad_stable(a, b, c): """稳定版本:先算大根,再用韦达定理反推小根""" d = np.sqrt(b*b - 4*a*c) q = -0.5 * (b + np.sign(b) * d) return q / a, c / q # 病例:两个根相差悬殊 a, b, c = 1.0, -1e8 + 1.0, 1.0 r1n, r2n = quad_naive(a, b, c) r1s, r2s = quad_stable(a, b, c) prod_true = c / a # 两根之积应等于 c/a print(f"朴素版: 根 {r1n:.6g}, {r2n:.6g}, 积 {r1n*r2n:.6g}") print(f"稳定版: 根 {r1s:.6g}, {r2s:.6g}, 积 {r1s*r2s:.6g}") print(f"真值参考: 积应为 {prod_true:.6g}")
朴素版的大根基本正确,小根的有效数字几乎全灭——积检验直接暴露伤情(朴素版积约为零,稳定版精确还原)。修复思路是普适的:避免相近数相减,改用恒等变形(韦达定理把小根换成积除以大根)。这个思路在后文的统计量计算(方差的单遍公式问题)、坐标变换(极坐标小角度)里反复出现。
求和顺序是另一个隐形坑。浮点加法不满足结合律,一亿个数从小到大加与从大到小加,结果可以差出有效数字:
import numpy as np rng = np.random.default_rng(0) data = rng.random(10_000_000) * 1e-8 + 1.0 # 大数加小扰动 naive = 0.0 for x in data[:100_000]: # 顺序累加(截短演示) naive += x import math kahan = math.fsum(data[:100_000]) # 补偿求和 print(f"顺序累加: {naive:.10f}") print(f"补偿求和: {kahan:.10f}") print(f"参考真值: {data[:100_000].sum():.10f}")
数组库的求和用了成对累加策略,精度比裸循环好;对精度敏感的聚合用补偿求和函数最省心。
条件数与稳定性:病人体质与医生手法
问题条件数衡量"输入的相对扰动被问题本身放大多少"——它是问题的属性,换算法不变。算法稳定性衡量"算法是否引入额外的放大"——它是算法的属性。一次数值计算的最终误差大致是:数据误差乘条件数,再乘算法的稳定因子。条件数大的问题(病态问题)用什么算法都难受,只能换问题提法(如正则化);稳定的算法在良态问题上能逼近机器精度。
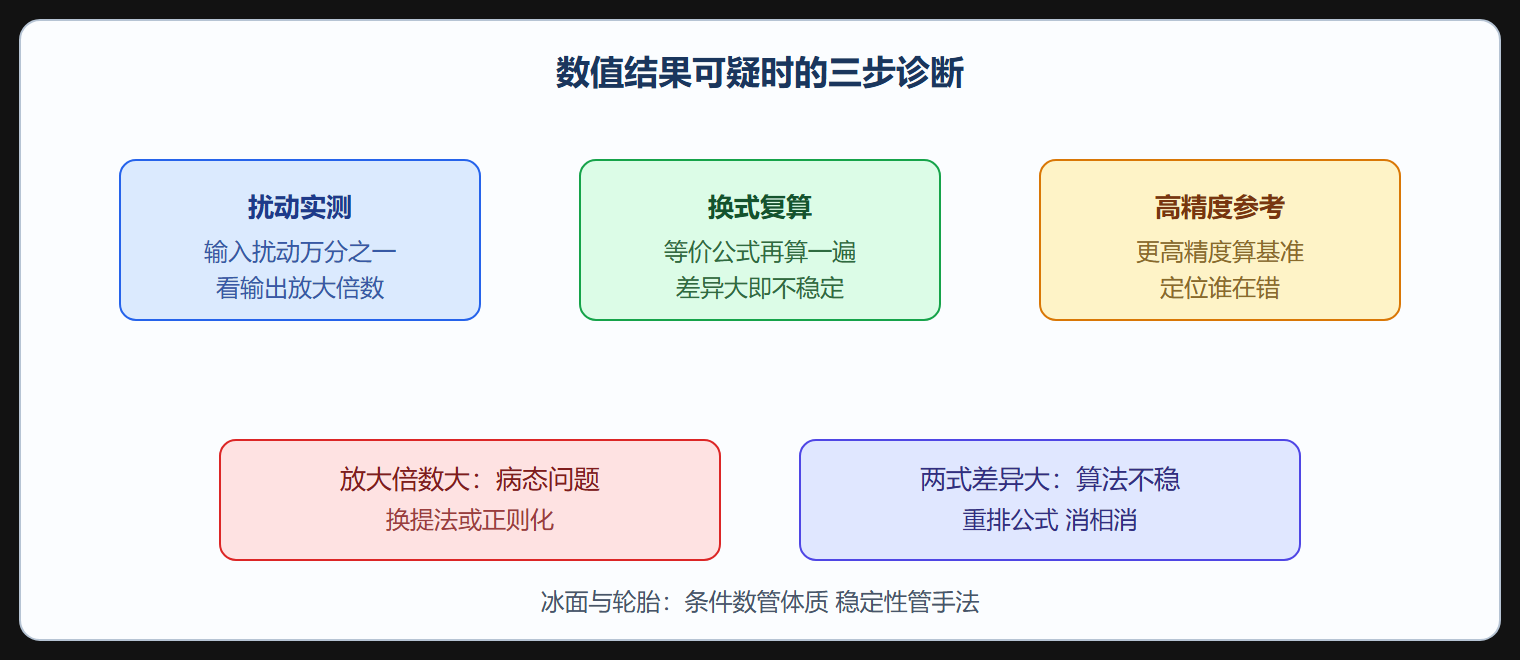
诊断口诀:结果可疑时,先做三件事——把输入扰动万分之一重跑一遍看输出变化(实测条件数)、换一个等价公式重算(检验稳定性)、用高精度算参考值(定位谁在错)。三步下来,"是病人体质还是医生手法"基本分明。
⚠️ 常见坑:拿双精度复算单精度的流水线代码做"验证"。两者共享同一套病态结构,错误高度相关,互相印证不出问题。验证要换算法或换提法,不是换精度。
💡 关键直觉:把每个数值程序想象成在冰面上开车——条件数是冰面的滑度,稳定性是你的轮胎。滑面上换好轮胎有用但有限;路面本身滑(病态),该换路(重参数化、正则化)而不是换胎。
误差诊断流程
本节要点回顾
- 三误差源:数据误差属问题、截断与舍入属算法和机器,脾气各异;
- 步长 U 形曲线:截断与舍入此消彼长,存在最优步长而非越小越好;
- 相近数相减是有效数字杀手,韦达定理式的恒等变形是标准解法;
- 求和顺序影响精度,敏感聚合用补偿求和;
- 条件数与稳定性分工:病态换提法,不稳换公式,先分清再动手。