6.1 6.1 凸优化与 KKT 条件
6.1 凸优化与 KKT 条件
本节摘要:凸性是优化问题的体质分界线:凸问题上任何局部最优都是全局最优,梯度类方法有了收敛保证。本节讲凸集与凸函数的判据、无约束优化的驻点条件,然后进入带约束的核心——KKT 条件:它既是解的"验收章",其对偶变量还是资源稀缺度的标价。全程配一个产能分配工单。
学习目标
阅读完本节,你应当能够:
- 用两点中点判据和海塞矩阵半正定性判断凸性;
- 写出带不等式约束问题的 KKT 条件并验证给定解;
- 把对偶变量解读为约束的影子价格用于决策。
凸性:没有坑的世界
函数凸的定义朴素:图像上任意两点的连线不低于函数本身——中点的函数值不超过函数值的中点。等价判据(二阶可微时):海塞矩阵处处半正定。凸优化的定义随之而来:凸目标函数、凸可行域(线性等式与凸不等式约束)。
凸性的算法学意义是决定性的:局部最优即全局最优,任何"下山算法"找到的坑就是唯一的坑。非凸问题(神经网络损失、整数规划可行域)则遍布局部最优,算法只能保证找到"某个"坑,好坏要看初始化的运气与算法的技巧。建模阶段能把问题写成凸形式,等于把求解难度降了一个量级——这是比挑选算法更根本的优化技能。
常见凸函数要认得:线性函数、二次型(海塞正定时)、负对数、指数、范数。保凸运算:凸函数加正权重、凸函数取最大值、凸函数的仿射复合仍是凸。判断口诀:"目标与约束都过安检,问题就安全。"
import numpy as np def is_convex_quadratic(Q): """二次目标 xQx 的凸性 = Q 半正定,用最小特征值检验""" eig = np.linalg.eigvalsh((Q + Q.T) / 2) return eig.min() >= -1e-10, eig.min() rng = np.random.default_rng(4) M = rng.standard_normal((5, 5)) print("随机阵做 Q(不定):", is_convex_quadratic(M)) print("转置自乘加单位阵:", is_convex_quadratic(M.T @ M + np.eye(5)))
产能分配工单与 KKT 条件
工单:两条产线共一台公用设备,可用工时一千二百。产线一单位工时利润四百、耗公用设备两小时;产线二单位工时利润三百、耗一小时。另有产线一的原料上限五百工时。问各产线安排多少工时利润最大。
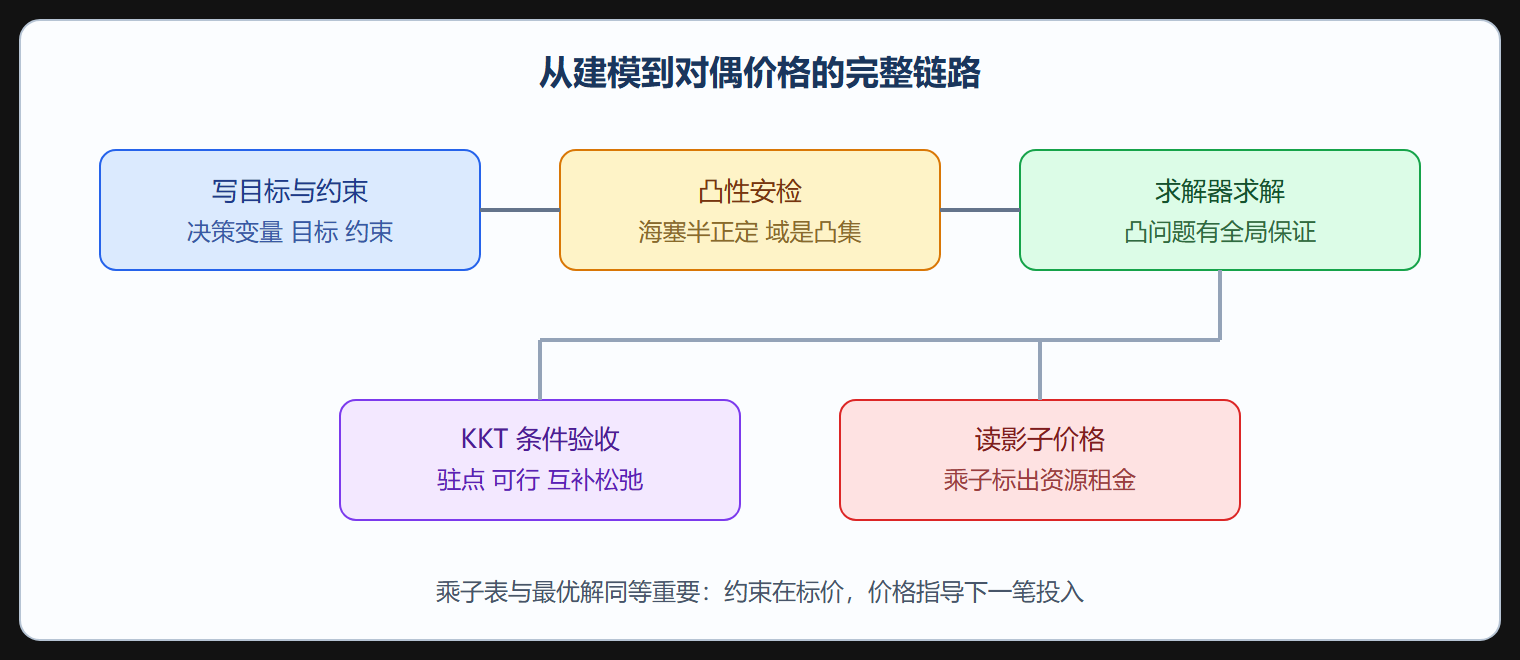
决策变量 x1、x2,线性目标下这个例子其实是线性规划——但故意用 KKT 来解,因为它同时展示 KKT 的机制与对偶价格。约束写成小于等于零的标准形后,拉格朗日函数是目标减去乘子乘约束。KKT 条件四件套:驻点(拉格朗日梯度为零)、原始可行、对偶可行(不等式乘子非负)、互补松弛(乘子乘约束为零:约束不紧则乘子为零,乘子为正则约束必紧)。
import numpy as np from scipy.optimize import linprog # 最大化 400x1+300x2 转化为最小化负目标 c = [-400, -300] A_ub = [[2, 1], [1, 0]] # 公用设备工时、产线一原料 b_ub = [1200, 500] res = linprog(c, A_ub=A_ub, b_ub=b_ub, bounds=[(0, None)]*2, method='highs') x = res.x print(f"最优工时: 产线一 {x[0]:.0f}, 产线二 {x[1]:.0f}") print(f"最大利润: {-res.fun:,.0f} 元") # 对偶变量(影子价格)随解一并返回 print("影子价格:", np.round(res.ineqlin.marginals, 2))
最优解落在两个约束的交点上。影子价格的读法是本节最值钱的一行:公用设备约束的乘子约 300,含义是设备工时每多一小时,利润多三百元——如果市场上有租金低于三百元每小时的同类设备,租就是赚的。原料约束乘子约 100:原料每多一单位只带来一百元,优先级立刻排出。对偶变量把"约束"翻译成"价格",是 KKT 条件送给管理者的礼物。
互补松弛的验证手工做一遍有感觉:若最优解处某约束有松弛(严格不等号),其乘子必为零——"不 binding 的约束不标价"。反之乘子为正的约束一定恰好取等。这个"非此即彼"的结构在整数规划的松弛、支持向量机的稀疏性(第 8 章)里反复现身。
无约束凸优化:梯度与牛顿
无约束时 KKT 退化为驻点条件:梯度为零。数值上用迭代逼近:梯度下降沿负梯度走,牛顿法用海塞矩阵校正方向(二阶收敛但每步贵)。凸性保证两者的收敛定理成立——这就是"体质好"的算法学兑现。
import numpy as np def grad_descent(grad, x0, lr=0.1, tol=1e-9, max_iter=5000): """梯度下降:沿负梯度固定步长迭代""" x = np.asarray(x0, float) for k in range(max_iter): g = grad(x) if np.linalg.norm(g) < tol: break x = x - lr * g return x, k # 凸二次目标:f = 0.5 xQx - bx, 梯度 = Qx - b rng = np.random.default_rng(8) Q = np.array([[6, 1], [1, 4]]) b = np.array([1, 2]) x_opt, iters = grad_descent(lambda x: Q @ x - b, [0, 0]) print(f"梯度下降 {iters} 步 -> {np.round(x_opt, 6)}") print("解析解(Q逆b):", np.round(np.linalg.solve(Q, b), 6))
条件数对梯度下降的影响在这里眼见为实:把 Q 的两个特征值差距拉大,迭代数成比例上涨——这正是第 5 章"预条件降条件数"思想在优化里的翻版。牛顿法用海塞逆预条件,一步到位(二次目标),代价是要算二阶信息。
⚠️ 常见坑:把非凸问题硬套凸求解器并相信输出。求解器返回的是"收敛到驻点",不是"全局最优"的承诺;非凸问题上报结果必须声明局部性,并用多起点重启交叉验证。
💡 关键直觉:KKT 乘子是"约束的租金"。读优化结果时,别只看最优解本身,把乘子表一起读出来——哪条约束在标价、标价多少,往往比解本身更影响下一步的商业动作。
凸优化工作流
本节要点回顾
- 凸性是体质:局部最优即全局最优,建模范式优先写成凸形式;
- 判据在手:中点不等式、海塞半正定、保凸运算三件工具;
- KKT 四件套:驻点、原始可行、对偶可行、互补松弛,解的验收章;
- 对偶变量即影子价格:约束松则乘子零,乘子正则约束紧;
- 条件数决定梯度法步数,牛顿用二阶信息预条件,一阶二阶各有所长。