2.3 2.3 图与网络的谱分析
2.3 图与网络的谱分析
本节摘要:矩阵不止能装表格,还能装网络。把关系图写成邻接矩阵与拉普拉斯矩阵后,线性代数的全套工具立刻可用:第二小特征向量(Fiedler 向量)给出图的"最自然二分",特征值谱揭示社区结构与连通性。本节从一张部门协作网络工单出发,实现谱二分并解释为什么它有效。
动手前的能力清单
阅读完本节,你应当能够:
- 在邻接矩阵、度矩阵、拉普拉斯矩阵之间自由换算;
- 说出拉普拉斯矩阵最小特征值恒为零的原因与连通性的谱判据;
- 用 Fiedler 向量对网络做谱二分,并判断切分质量。
工单:谁和谁真的在一起着工
一张三十来人的跨部门项目协作网络,节点是人,边是过去三个月的直接协作记录。管理者的疑问很实际:这批人表面上分属三个组,实际协作是不是也按组来的?有没有"桥接者"被切在两个圈子之间?这类问题不涉及任何微积分,纯粹是结构问题——而结构问题的标准代数化身就是矩阵。
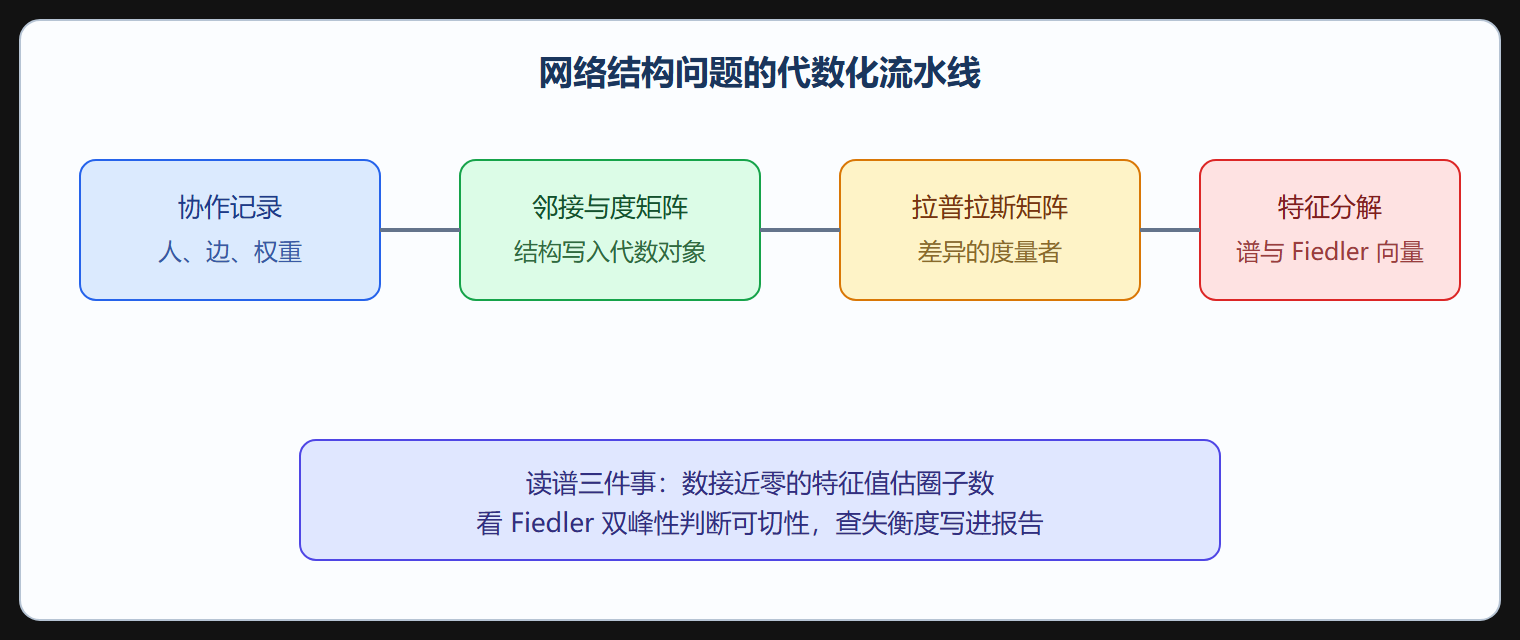
三种矩阵各司其职:邻接矩阵 A 的第 i 行 j 列为 1 表示 i 与 j 有边;度矩阵 D 是对角阵,对角元是每个节点的连接数;拉普拉斯矩阵 L 等于 D 减 A。拉普拉斯看似抽象,其实有一个极好的性质:对任意向量 x,x 转置乘 L 乘 x 等于所有边两端的 x 值之差的平方和的一半。换句话说,L 是"差异的度量者"——想让这个二次型小,就得让每条边两端的取值尽量接近。
谱二分:让差异度量替我们切图
把每个节点配一个实数标签 y,要求"边两端的 y 尽量相同",同时 y 不能是常数(否则全零,没有信息)。数学表述为:最小化 y 转置 L 乘 y,约束 y 转置 y 等于一且 y 与全一向量正交。这个约束优化问题的解恰好是 L 的第二小特征向量——Fiedler 向量。按它的正负号把节点分成两堆,就是谱二分:被切过的边两端差异被显式计量,切分位置自动落在"最松的接缝"上。
import numpy as np def laplacian(edges, n): """从边表构造拉普拉斯矩阵""" A = np.zeros((n, n)) for i, j in edges: A[i, j] = A[j, i] = 1.0 return np.diag(A.sum(axis=1)) - A, A # 两个稠密簇 + 一条弱连接的协作网络 rng = np.random.default_rng(9) n = 24 c1, c2 = list(range(12)), list(range(12, 24)) def dense(group, p=0.7): out = [] for a in range(len(group)): for b in range(a + 1, len(group)): if rng.random() < p: out.append((group[a], group[b])) return out edges = dense(c1) + dense(c2, p=0.6) + [(3, 15), (7, 20)] # 两条跨簇弱边 L, A = laplacian(edges, n) eigvals, eigvecs = np.linalg.eigh(L) # 对称矩阵专用特征分解 fiedler = eigvecs[:, 1] # 第二小特征向量 part_a = [i for i in range(n) if fiedler[i] < 0] part_b = [i for i in range(n) if fiedler[i] >= 0] cross = sum(1 for i, j in edges if (i in part_a) != (j in part_b)) print("前四个特征值:", np.round(eigvals[:4], 3)) print(f"谱二分结果: 一侧 {len(part_a)} 人 / 另一侧 {len(part_b)} 人") print(f"被切断的协作边数: {cross} / 总边数 {len(edges)}")
典型输出:前两个特征值接近零(两个簇意味着近似两个连通分量),二分把两个工作圈干净切开,被切断的只有那两条弱边。特征值里藏着连通性:严格连通的图最小特征值为零且仅一个零;近似解耦的集团会表现出"多个接近零的特征值"。数一数接近零的特征值个数,就能估出网络里有几个实质上的圈子——这比任何画图工具都客观。
进一步,把每个节点按 Fiedler 向量取值排序后观察其分布:如果是双峰形状,说明网络天然二分;如果是一条平滑曲线,说明结构是渐进过渡的,强行二分会割伤大量边。
import numpy as np # 接上例:评估切分质量的两个指标 def cut_quality(fiedler, edges): sign = np.sign(fiedler) cut = sum(1 for i, j in edges if sign[i] != sign[j]) within = len(edges) - cut balance = abs(sum(sign > 0) - sum(sign < 0)) / len(sign) return cut, within, balance cut, within, balance = cut_quality(fiedler, edges) print(f"切断 {cut} 条, 保留 {within} 条, 两侧规模失衡度 {balance:.2f}") print("Fiedler 取值分布(分位数):", np.round(np.quantile(fiedler, [0, .25, .5, .75, 1]), 3))
失衡度接近零说明两侧规模相当;分位数表则替代直方图快速判断双峰性。真实组织网络往往一大一小,谱二分照切不误,但报告里要把失衡度写出来——"把三人小组从三十人大群中切出去"和"对半劈"是完全不同的组织学结论。
⚠️ 常见坑:把邻接矩阵而不是拉普拉斯矩阵拿去做特征分解。邻接谱也能提供信息(比如正则树的谱半径),但"切图看第二小特征向量"这条定理是拉普拉斯专属,矩阵拿错了结论就全错了。
💡 关键直觉:Fiedler 向量是给每个节点发的"温度计读数"。同温区的人协作密,温度差大的两端切开会疼(边被切断)。谱二分本质上是找温度梯度最大、切断代价最小的位置下刀。
从表格矩阵到网络矩阵
本节要点回顾
- 拉普拉斯二次型度量"边两端取值差异",是谱图理论的物理直觉入口;
- Fiedler 向量是约束最小化的解析解,按其符号切图即谱二分;
- 接近零的特征值个数估计实质圈子数,连通性有谱判据;
- 切矩阵别拿错:二分定理属于拉普拉斯,不属于邻接矩阵;
- 失衡度与双峰性必须随结论一起交付,谱方法给切法,组织含义要人解读。