8.1 8.1 机器学习的数学骨架
8.1 机器学习的数学骨架
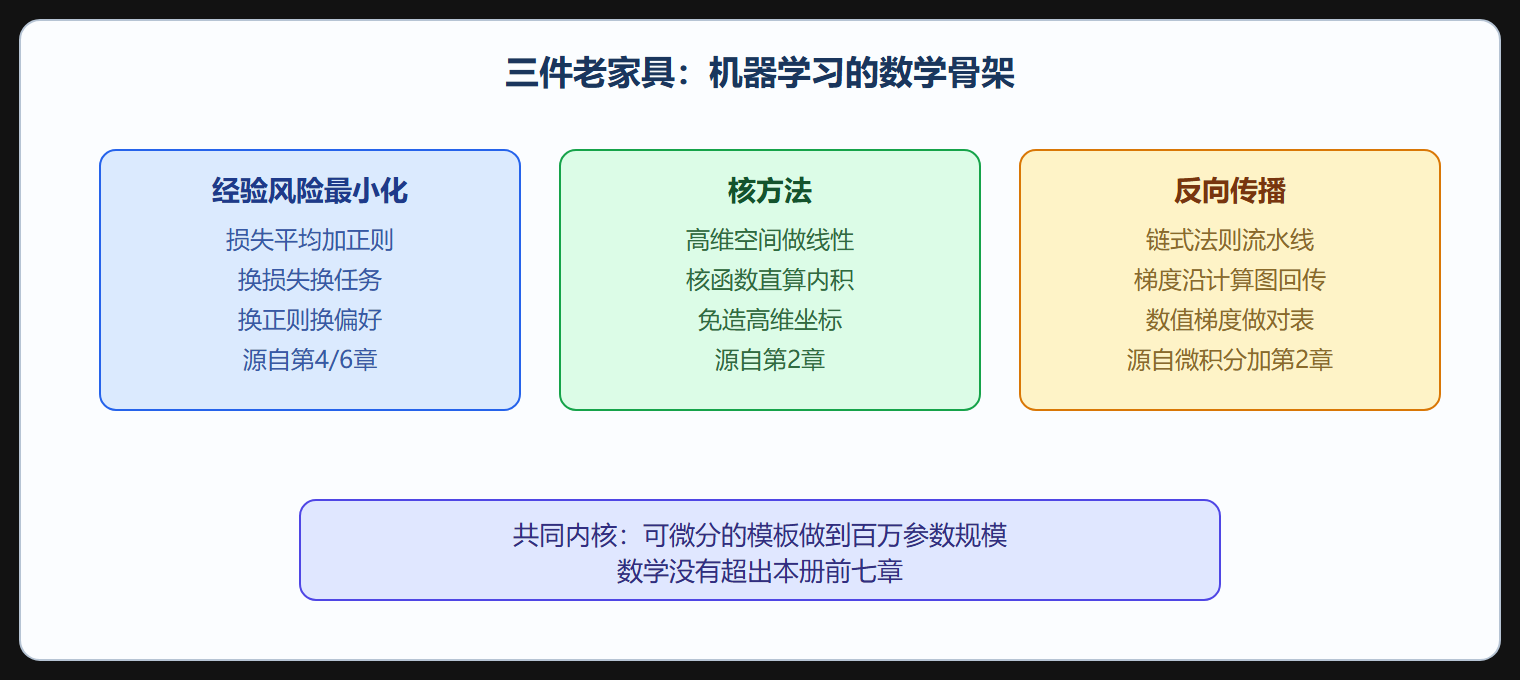
本节摘要:机器学习的时髦外壳下是三件老家具:经验风险最小化(第 4 章的统计推断加第 6 章的优化)、核方法的升维几何(第 2 章的线性代数)、反向传播的链式法则(微积分)。本节把三件家具各装一遍最小可跑版本,说明"调包"与"懂数学"的差距在故障排查时兑现。
学习目标
阅读完本节,你应当能够:
- 写出经验风险最小化框架并实现最小二乘与感知机的统一形式;
- 解释核技巧"在高维空间做线性"的几何机制;
- 手写一个两层数值梯度的神经网络训练循环。
学习即优化:经验风险最小化
监督学习的标准提法只有一行:最小化"损失在数据上的平均"加正则项。损失度量单条预测的疼感(回归用平方、分类用铰链或交叉熵),平均到全数据集就是经验风险,正则项(第 4 章的岭与套索)压制过拟合。选不同的损失与正则,就得到从最小二乘到支持向量机的整个家族——它们是同一个模板的不同填空。
import numpy as np rng = np.random.default_rng(31) X = rng.standard_normal((200, 3)) w_true = np.array([1.5, -2.0, 0.5]) y = np.sign(X @ w_true + 0.1*rng.standard_normal(200)) # 铰链损失 + L2 正则 = 线性支持向量机的目标 def erm_objective(w, b, lam=0.01): margins = y * (X @ w + b) hinge = np.maximum(0, 1 - margins).mean() return hinge + lam * np.sum(w**2) # 数值梯度下降(换 scipy.optimize 更快, 此处看清结构) def train(lam=0.01, lr=0.1, epochs=300): w, b = np.zeros(3), 0.0 eps = 1e-6 for _ in range(epochs): grads_w, grad_b = np.zeros(3), 0.0 for i in range(3): wp = w.copy(); wp[i] += eps wm = w.copy(); wm[i] -= eps grads_w[i] = (erm_objective(wp, b, lam) - erm_objective(wm, b, lam)) / (2*eps) gb1 = erm_objective(w, b+eps, lam); gb0 = erm_objective(w, b-eps, lam) grad_b = (gb1 - gb0) / (2*eps) w -= lr * grads_w; b -= lr * grad_b return w, b w_hat, b_hat = train() acc = np.mean(np.sign(X @ w_hat + b_hat) == y) print(f"学到的权重 {np.round(w_hat, 2)}(真值 {w_true})") print(f"训练准确率 {acc:.1%}")
学到的权重与真值同号同量级。这个模板的普适性是它统治的原因:换损失函数就换任务类型,换正则就换归纳偏好,优化器是可插拔的引擎。深度学习无非把这个模板套在"参数是百万级权重、特征由网络自己学"的场合——模板没变,变的是规模。
核方法:不升维的升维
线性方法处理不了"环形分布"这类数据——内圈一类、外圈一类,任何直线都切不开。解法看似粗暴:把点映射到高维空间(比如加一维"到原点距离的平方"),在高维里它们就线性可分了。核技巧的精妙在于:算法只需要内积,而高维内积可以用原空间的核函数直接算出来,永远不必真的构造高维坐标。
import numpy as np rng = np.random.default_rng(17) n = 120 r = np.where(rng.random(n) < 0.5, 0.3, 1.0) # 两个同心环 theta = rng.random(n) * 2 * np.pi X = np.column_stack([r*np.cos(theta), r*np.sin(theta)]) y = np.where(r < 0.5, 1.0, -1.0) def kernel(x, z, gamma=1.0): """高斯核:两点距离的负指数""" return np.exp(-gamma * np.sum((x - z)**2)) # 核近邻分类:待测点与训练点的核相似度加权投票 def kernel_predict(x_new, k=5): sims = np.array([kernel(x_new, xi) for xi in X]) top = np.argsort(-sims)[:k] return np.sign(np.sum(y[top] * sims[top])) acc = np.mean([kernel_predict(X[i]) == y[i] for i in range(n)]) print(f"核近邻训练准确率 {acc:.1%}") # 对照:直接用线性分类 w = np.linalg.lstsq(np.column_stack([X, np.ones(n)]), y, rcond=None)[0] acc_lin = np.mean(np.sign(np.column_stack([X, np.ones(n)]) @ w) == y) print(f"线性分类准确率 {acc_lin:.1%}(同心环切不动)")
线性法在同心环上近乎瞎猜,核方法轻松满分。几何直觉:高斯核等价于把点抬到无穷维空间,在那里任何局部团块都能被超平面分开。代价是核矩阵的规模随样本数平方增长,大数据集上核方法的平方内存墙正是它让位于神经网络的历史原因之一。
反向传播:链式法则的流水线化
神经网络训练的唯一微积分知识点是链式法则:复合函数的导数等于各层导数的乘积。反向传播就是把链式法则从输出层往输入层逐层回传的流水线安排——每层只需本地存一个雅可比,梯度沿计算图反向流动。用数值梯度验证手写反传是行业标准动作(梯度检查):
import numpy as np rng = np.random.default_rng(0) n, d, h = 60, 2, 8 X = rng.standard_normal((n, d)) y = rng.standard_normal(n) W1, b1 = rng.standard_normal((d, h))*0.3, np.zeros(h) W2, b2 = rng.standard_normal(h)*0.3, 0.0 def loss(W1, b1, W2, b2): """两层网络: 隐层双曲正切, 输出线性, 均方损失""" H = np.tanh(X @ W1 + b1) pred = H @ W2 + b2 return 0.5 * np.mean((pred - y)**2) # 反向传播(解析梯度) H = np.tanh(X @ W1 + b1) pred = H @ W2 + b2 delta = (pred - y) / n # 输出层误差 gW2 = H.T @ delta; gb2 = delta.sum() dH = np.outer(delta, W2) * (1 - H**2) # 穿过双曲正坦的导数 gW1 = X.T @ dH; gb1 = dH.sum(axis=0) # 数值梯度抽查 W1 的一个分量 eps = 1e-6; i, j = 0, 3 W1p = W1.copy(); W1p[i, j] += eps W1m = W1.copy(); W1m[i, j] -= eps num = (loss(W1p, b1, W2, b2) - loss(W1m, b1, W2, b2)) / (2*eps) print(f"反传梯度 {gW1[i, j]:.6f} vs 数值梯度 {num:.6f}") print(f"相对误差 {abs(gW1[i,j]-num)/abs(num):.2e}(<1e-6 即对表)")
两个梯度在小数点后六位一致——反传实现正确。深度学习框架的全部底层就是这段代码的自动化版本:前向搭计算图、反向走链式法则、优化器更新参数。第 6 章的凸优化理论在这里只剩残影(损失非凸、满地局部最优),但梯度下降的机械原理原封未动——理解了本节,深度网络在你的世界里就不再是魔法,是微积分加线性代数加自动化的工程机械。
⚠️ 常见坑:只看训练集指标就宣布模型成功。第 4 章的过拟合判据在这里同样生效且更剧烈(参数多、容量大),验证集与测试集的纪律是机器学习的第一门必修课。
💡 关键直觉:三件家具的共同名字叫"可微分的模板"。损失定义目标、模型定义假设空间、梯度指路——现代 AI 的全部秘密就是把这个结构做到百万参数、亿级数据的规模上,数学内核没有超出本册前七章。
机器学习三构件地图
本节要点回顾
- 经验风险最小化是统一模板:损失定任务、正则定偏好、优化器是引擎;
- 核技巧用核函数直算高维内积,绕开坐标构造,代价是平方内存墙;
- 反向传播即链式法则的流水线化,梯度检查是标准验收动作;
- 深度学习是规模:模板未变,参数从个位数涨到亿级;
- 验证纪律在参数爆炸的场合更加生死攸关,第 4 章的判据全部适用。