6.3 6.3 排队、博弈与多目标决策
6.3 排队、博弈与多目标决策
本节摘要:现实决策常常没有单一目标函数:顾客在排队、对手在博弈、指标在打架。本节用利特尔法则把排队系统的等待时间一行算清,用反应曲线求出双寡头定价博弈的纳什均衡,最后用帕累托前沿处理多目标冲突——前沿不给"最优",给"菜单",偏好由决策者注入。
学习目标
阅读完本节,你应当能够:
- 用利特尔法则与 M/M/1 公式估算平均队长与等待时间;
- 求解古诺产量博弈的反应曲线交点,验证纳什均衡性质;
- 生成双目标帕累托前沿,并解释"没有免费午餐"的权衡读法。
排队:一行公式管半个世纪
客服中心工单:平均每两分钟来一通电话(到达率每分钟 0.5),单个坐席平均每三分钟处理一通(服务率每分钟三分之一),问平均排队多长、顾客平均等多久。单队列单服务台的 M/M/1 模型给出闭式解:系统平均人数等于到达率除以服务率与到达率之差;平均逗留时间是它的倒数。而利特尔法则只用一行就把三个量焊死:系统平均人数等于到达率乘平均逗留时间。
import numpy as np lam = 0.5 # 到达率(人每分钟) mu = 1/3 # 服务率(人每分钟) rho = lam / mu # 利用率 L = rho / (1 - rho) # 系统平均人数 W = L / lam # 利特尔法则反解逗留时间 Wq = W - 1/mu # 减去服务时间得纯等待 print(f"利用率 rho = {rho:.2f}") print(f"系统平均人数 L = {L:.1f}") print(f"平均逗留 W = {W:.1f} 分钟, 其中排队 {Wq:.1f} 分钟") for lam2 in [0.55, 0.6, 0.65]: rho2 = lam2/mu; W2 = 1/(mu - lam2) print(f"到达率升到 {lam2}: 平均逗留 {W2:.1f} 分钟")
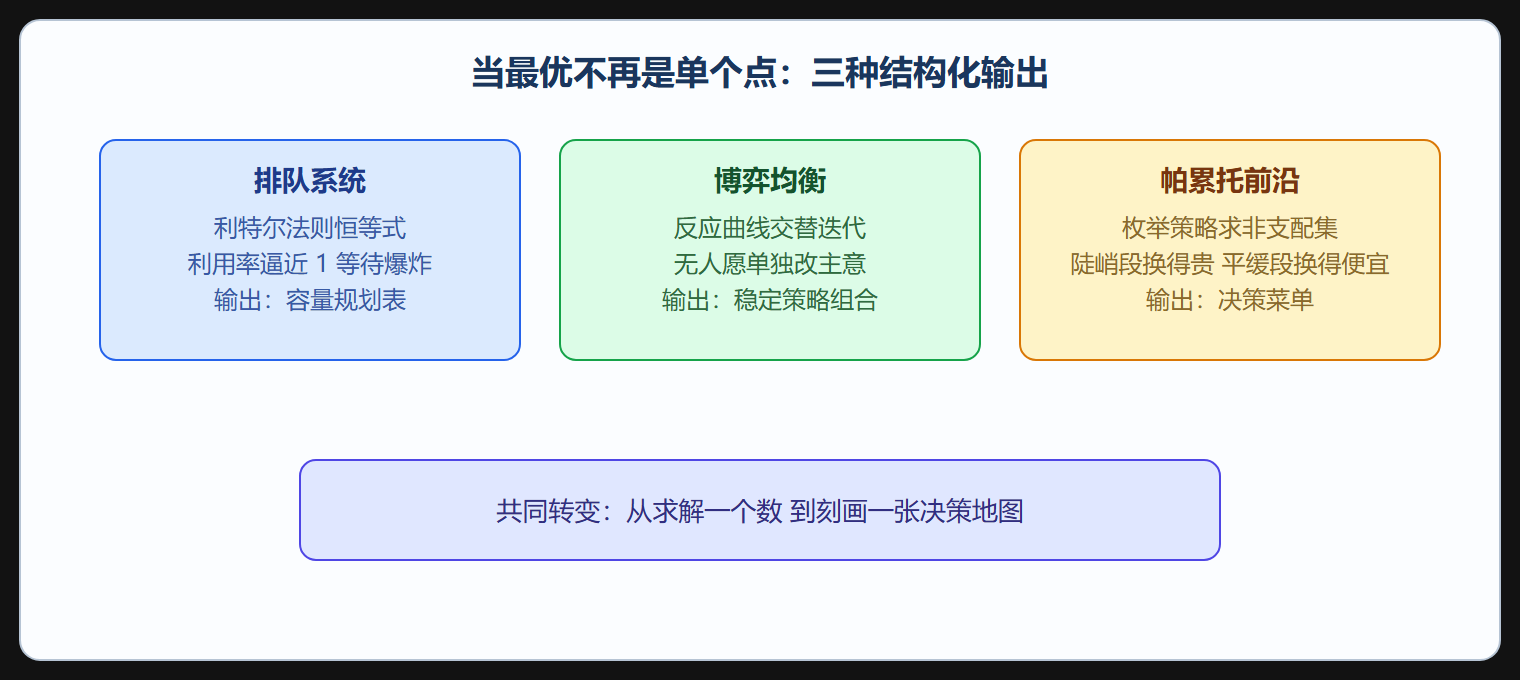
利用率 0.85 时逗留时间已约二十分钟,到达率再升一点,等待时间按非线性飙升——排队系统在接近满负荷时的等待爆炸是所有服务容量规划的母题。加坐席还是加阈值告警,先算这张表。利特尔法则的威力在于它对分布、对调度规则都不挑:只要系统稳态,"人数 = 到达率 × 逗留时间"铁定成立,它是排队论里最值得刻在脑子里的恒等式。
博弈:对手不是约束,是会动的
两家企业在同一市场定产量,市场价格由总产量决定(线性反需求),各自有单位成本。你多产一吨,价格下压,对手的利润受你影响——你的最优反应依赖对手的选择,反之亦然。纳什均衡是"谁单独改主意都不划算"的策略组合。
import numpy as np # 线性反需求: p = 60 - q1 - q2, 单位成本 c = 6 c = 6.0 def profit(q_own, q_other): p = 60 - q_own - q_other return (p - c) * q_own def best_response(q_other): """给定对手产量, 我方利润最大化的产量(驻点闭式解)""" return (60 - c - q_other) / 2 # 反应曲线迭代: 从任意起点交替最优响应 q1, q2 = 5.0, 5.0 for it in range(50): q1 = best_response(q2) q2 = best_response(q1) print(f"纳什均衡产量: 双方各 {q1:.2f}") print(f"均衡价格 {60 - q1 - q2:.2f}, 各得利润 {profit(q1, q2):.1f}") # 对照:两家合谋(卡特尔)最大化总利润 q_mono = (60 - c) / 2 / 1 # 合谋时总产量按单垄断者最优 print(f"合谋总产量 {q_mono:.2f}(各 {q_mono/2:.2f}), " f"各得利润 {profit(q_mono/2, q_mono/2):.1f}")
均衡处双方各产 18,各赚利润约 324;合谋时各产 13.5、各赚约 364——合谋利润更高但不是均衡(给定对方守约,自己偷偷增产更赚),这就是卡特尔内在的不稳定性,也是反垄断经济学的一块基石。反应曲线迭代是求纳什均衡最直观的数值方法,复杂博弈则要遍历策略空间或用第 8 章的强化学习视角(博弈即多智能体环境)。
多目标:前沿是菜单,不是答案
供应链工单的原始诉求(第 1 章那张四要素表)回来了:缺货要少、库存要省。这两个目标天然打架,不存在同时最优的解。帕累托前沿是所有"无法在不恶化一个目标的情况下改善另一个"的解的集合——它是一张菜单,点菜要靠决策者的偏好。
import numpy as np rng = np.random.default_rng(12) def evaluate(stock_level): """给定补货水位, 返回 (库存成本, 缺货次数) 双目标""" demand = rng.normal(40, 12, 3000) inv = stock_level - demand hold = np.clip(inv, 0, None).sum() * 0.8 short = (inv < 0).sum() return hold, short # 枚举一批可行策略, 生成目标空间中的点 points = np.array([evaluate(q) for q in np.arange(30, 95, 5)]) def pareto_front(pts): """保留不被任何其他点支配的点""" keep = [] for i, a in enumerate(pts): dominated = np.any([ np.all(b <= a) and np.any(b < a) for j, b in enumerate(pts) if j != i]) if not dominated: keep.append(i) return pts[keep] front = pareto_front(points) print("帕累托前沿策略(库存成本, 缺货次数):") for hold, short in front: print(f" 持有 {hold/1000:.0f}k 元, 缺货 {short:.0f} 次")
前沿的读法:曲线陡峭段表示"用一个目标换另一个很贵",平缓段是"便宜的交易"。决策支持系统的正确形态是把前沿摆出来让管理者选点,而不是替管理者定义权重后悄悄算一个"最优"。当然偏好明确时也可以标量化(加权合成单目标),但权重的敏感性(呼应 1.3 节)必须随之交付。
⚠️ 常见坑:用平均等待时间给服务系统定容量。平均值对长尾不敏感,而投诉恰恰来自尾部——百分之九十五分位等待时间才是体验指标,模拟(第 4 章)加经验分位数是标配组合。
💡 关键直觉:三个模型共享同一种思维转变——从"求解"到"刻画结构"。排队公式刻画等待如何随利用率爆炸,博弈均衡刻画稳定的策略组合,帕累托前沿刻画权衡的边界。数学输出的不是数字,是决策地图。
三种无单一最优的场景
本节要点回顾
- 利特尔法则对分布与规则不挑,是排队估算的第一工具;
- 利用率逼近 1 时等待非线性爆炸,容量规划必须留余量;
- 纳什均衡用反应曲线迭代可求,合谋高利润但结构不稳;
- 帕累托前沿输出菜单而非答案,权重注入要显式且带敏感性;
- 尾部分位数而非均值才是体验指标,模拟配经验分位数交付。