5.3 5.3 大规模稀疏线性求解
5.3 大规模稀疏线性求解
本节摘要:现代仿真工单的真正瓶颈几乎总在"解一个巨大的线性方程组"。当维度上到十万阶,稠密存储与直接分解全面告吹,出路是利用稀疏性:稀疏存储格式省内存,迭代法只做矩阵向量乘。本节实现雅可比与共轭梯度迭代,演示预条件的威力,并给出直接法与迭代法的选型判据。
学习产出
阅读完本节,你应当能够:
- 说出稠密方案在大规模问题上的三重障碍;
- 手写雅可比迭代与共轭梯度,解释后者的有限步终止性质;
- 判断什么时候需要预条件,以及怎么构造简单的预条件子。
工单:十万节点的热传导网络
芯片散热的电阻热网络模型:每个节点一个温度未知量,边是热阻。十万节点的网络意味着十万阶线性方程组。稠密方案的账单:存储要十万的平方乘八字节,约八十 TB;直接分解的浮点量级是十亿的平方——现有硬件免谈。但这个矩阵每行平均只有三五个非零元(每个节点只连着邻居),稀疏度超过百分之九十九点九。稀疏性就是生路:只存非零元,只算非零元。
三重障碍(内存、分解时间、分解引入的填充)在稀疏直接法里依然部分存在——分解过程会产生新的非零元(填充),需要巧妙排序压低填充。而迭代法干脆不解构矩阵:反复做矩阵向量乘(稀疏阵乘向量只与非零元个数成正比),让解序列自己收敛。
import numpy as np from scipy.sparse import diags, eye from scipy.sparse.linalg import spsolve, cg n = 50_000 # 一维热传导的典型三对角系统(保真演示,规模可在笔记本上跑) main = 2.0 * np.ones(n) off = -1.0 * np.ones(n - 1) A = diags([off, main, off], [-1, 0, 1], format='csr') b = np.ones(n) import time t0 = time.perf_counter() x_direct = spsolve(A.tocsc(), b) # 稀疏直接法 t_dir = time.perf_counter() - t0 t0 = time.perf_counter() x_cg, info = cg(A, b, rtol=1e-8) # 共轭梯度 t_cg = time.perf_counter() - t0 print(f"直接法 {t_dir*1000:.1f} ms, 共轭梯度 {t_cg*1000:.1f} ms") print(f"两解最大差异 {np.max(np.abs(x_direct - x_cg)):.2e}")
五万阶三对角问题上两者都在毫秒级——三对角是直接法的友好场景。真正的分水岭出现在二维三维网格:那里直接法的填充爆炸,迭代法的优势才拉开。
两种迭代:雅可比的朴素与共轭梯度的精妙
雅可比迭代把方程组按行拆开,每个未知量用自己的旧值更新自己:第 i 个分量的新值等于右端项减去其他变量贡献后再除以对角元。实现不到十行,但收敛有条件(对角占优或类似性质),收敛速度常常慢得让人失去耐心。
共轭梯度(CG)是针对对称正定矩阵的精妙设计:它维护一组互相"共轭"的搜索方向,每步在这些方向上做全局最优的步长选择,理论上有有限步终止——最多 n 步(精确算术下)得到精确解。实践价值不在于有限步终止,而在于误差随步数下降的速度与条件数挂钩:条件数越小收敛越快,好的预条件能把迭代数砍一个数量级。
import numpy as np def jacobi(A_dense, b, x0=None, tol=1e-8, max_iter=5000): """手写雅可比迭代:按行独立更新""" A = np.asarray(A_dense, float) d = np.diag(A) R = A - np.diag(d) x = np.zeros_like(b) if x0 is None else x0.copy() for k in range(max_iter): x_new = (b - R @ x) / d if np.max(np.abs(x_new - x)) < tol: return x_new, k x = x_new return x, max_iter def conjugate_gradient(A, b, tol=1e-10, max_iter=None): """手写共轭梯度(对称正定矩阵专用)""" n = len(b) x = np.zeros(n) r = b - A @ x p = r.copy() rs_old = r @ r for k in range(max_iter or 10*n): Ap = A @ p alpha = rs_old / (p @ Ap) x += alpha * p r -= alpha * Ap if np.sqrt(r @ r) < tol: return x, k + 1 rs_new = r @ r p = r + (rs_new / rs_old) * p rs_old = rs_new return x, max_iter or 10*n # 测试:带强对角的对称正定系统 rng = np.random.default_rng(2) n = 300 M = rng.standard_normal((n, n)) A = M @ M.T + 4 * np.eye(n) # 对称正定 b = rng.standard_normal(n) x_ref = np.linalg.solve(A, b) x_j, it_j = jacobi(A, b) x_c, it_c = conjugate_gradient(A, b) print(f"雅可比: {it_j} 步, 误差 {np.max(np.abs(x_j - x_ref)):.2e}") print(f"共轭梯度: {it_c} 步, 误差 {np.max(np.abs(x_c - x_ref)):.2e}")
同一系统上 CG 通常几十步收工,雅可比要么慢几个数量级、要么(不满足收敛条件时)干脆不收敛。CG 的每步成本与雅可比相当(一次矩阵向量乘加几次点积),快在步数。
预条件的思路:把原系统改写成"预条件子乘 A"的形式,等价但条件数更小。理想预条件子要"像 A 但好解"。工程常用的有对角预条件(把 A 的对角拎出来,一行代码)、不完全分解(做 LU 但丢弃填充)、多重网格(网格粗细层级间转移误差)。对角预条件虽土,对对角量级悬殊的系统立竿见影:
import numpy as np from scipy.sparse.linalg import cg from scipy.sparse import diags rng = np.random.default_rng(3) n = 2000 scale = np.logspace(0, 4, n) # 量级悬殊的对角 M = diags([rng.standard_normal(n-1), scale, rng.standard_normal(n-1)], [-1, 0, 1], format='csr') A = (M @ M.T).tocsr() b = np.ones(n) x1, _ = cg(A, b, rtol=1e-8) # 无预条件 from scipy.sparse.linalg import LinearOperator diag_inv = 1.0 / A.diagonal() pre = LinearOperator((n, n), matvec=lambda v: diag_inv * v) x2, _ = cg(A, b, M=pre, rtol=1e-8) # 对角预条件 print("预条件前后解一致:", np.allclose(x1, x2, atol=1e-5))
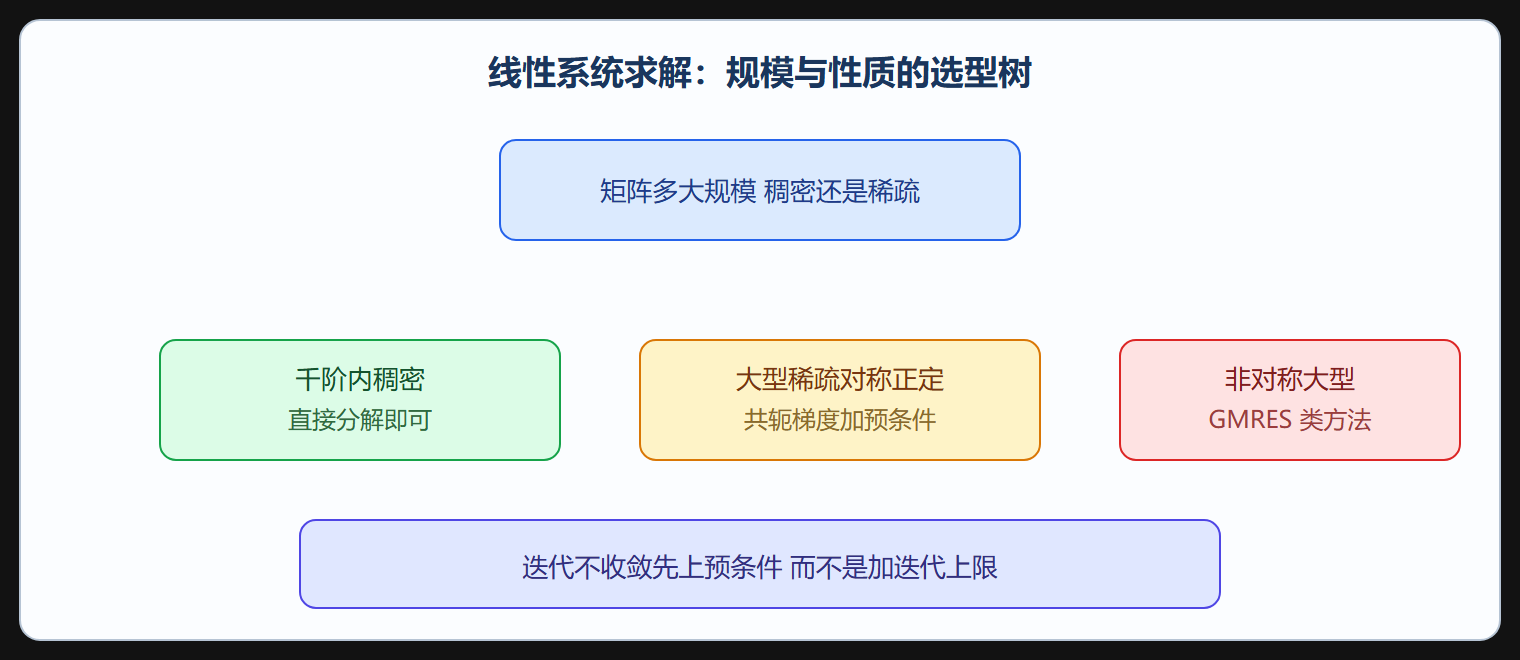
对角量级跨四个数量级时,加一行对角预条件常把迭代数砍掉大半。迭代不收敛时的第一反应应该是"上预条件",而不是"加迭代上限"。
⚠️ 常见坑:把对称正定求解器用到非对称或不定矩阵上。共轭梯度对矩阵性质有硬要求,用在错误对象上不是收敛慢,是可能安静地给出错误结果。非对称系统用广义极小残差法(GMRES)一类,先把矩阵性质验明再选求解器。
💡 关键直觉:迭代法的本质是"用矩阵向量乘这个便宜动作反复试探"。稀疏矩阵乘向量只与非零元个数同阶——所以一切迭代法的单步成本都很低,胜负全在收敛速度,而收敛速度由条件数(经过预条件修饰后)决定。
大规模求解选型
本节要点回顾
- 稀疏度即生路:只存非零元、只算非零元,十万阶从免谈变常规;
- 迭代法单步便宜(稀疏阵乘向量),胜负全在收敛步数;
- 共轭梯度吃对称正定性质换全局最优步长,条件数决定收敛速度;
- 预条件是收敛慢的标准解,对角版一行代码、不完全分解与多重网格逐级加码;
- 验明矩阵性质再选求解器,把 CG 用错对象会安静地出错。