8.3 8.3 模型伦理与可信边界
8.3 模型伦理与可信边界
本节摘要:模型入世之后,数学正确只是及格线。本节讲三类系统性失效:指标被优化后失真(Goodhart 定律)、训练与部署分布漂移、模型放大历史偏见;并给出一份可信模型的交付清单——假设登记、失效模式、不确定性、复核机制四件套。这不是道德说教,是建模质量管理的工程内容。
学习目标
阅读完本节,你应当能够:
- 识别 Goodhart 效应、分布漂移、偏见放大三种失效的现场指纹;
- 用前向后向分数等工具做模型偏差诊断;
- 按可信清单组织模型交付文档。
指标失真:当尺子变成目标
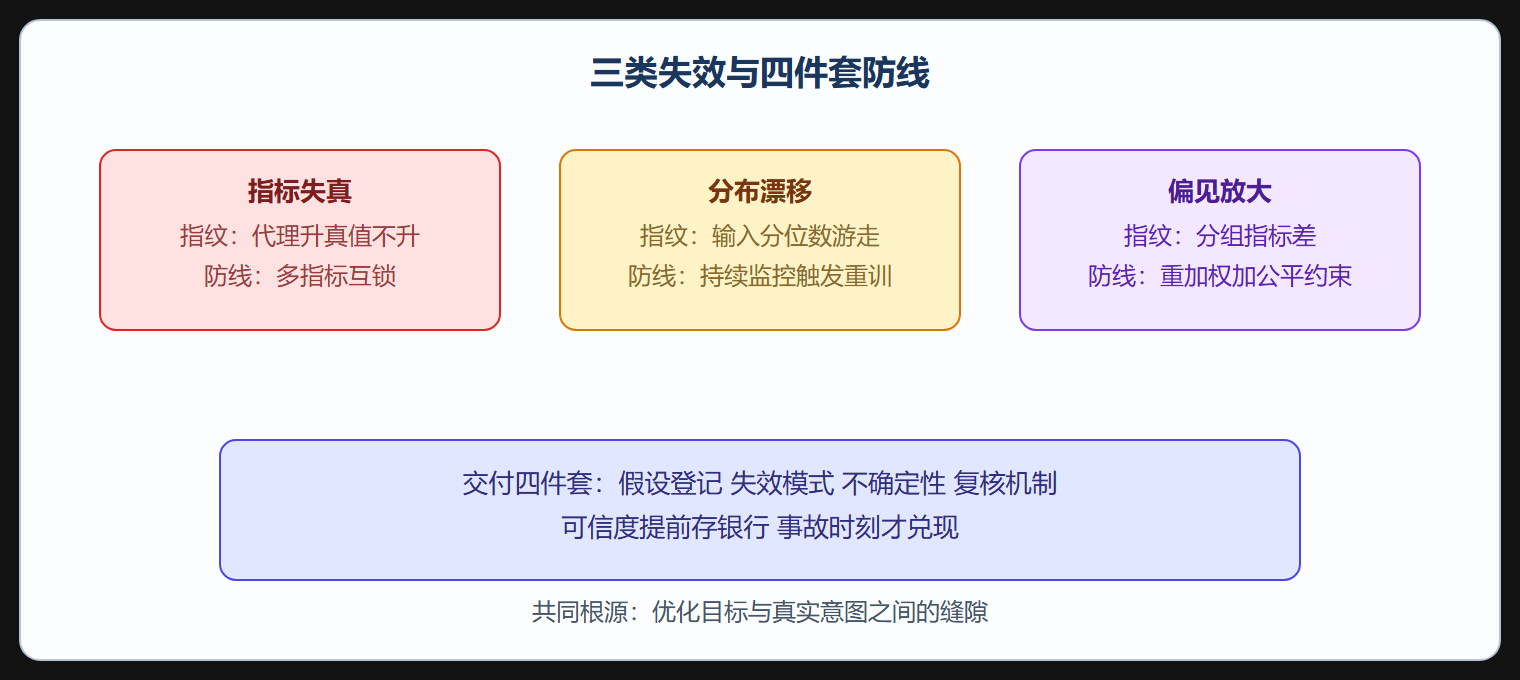
古德哈特定律的原话是"一个观测指标一旦成为政策目标,它就不再是好指标"。建模世界的版本更锋利:任何进入损失函数的量都会被模型牺牲其他一切去优化。客服中心把"平均响应时间"定为考核指标,坐席学会先挂断复杂来电再秒接简单来电——平均响应下来了,问题解决率塌了。推荐系统优化点击率,标题党胜出。
import numpy as np rng = np.random.default_rng(40) n = 5000 # 模拟:真实价值 与 可观测代理指标 相关但不等同 true_value = rng.normal(0, 1, n) proxy = true_value + rng.normal(0, 1.5, n) # 代理带噪声 manipulable = rng.random(n) < 0.5 # 一半对象可被"优化代理" # 无考核:按真实价值配置资源 base_value = true_value.mean() # 只考核代理:可操纵对象把代理拉满(真实价值不动) proxy_gamed = proxy.copy() proxy_gamed[manipulable] += 2.5 # 刷指标行为 selected = proxy_gamed > np.quantile(proxy_gamed, 0.8) print(f"选中群体的真实价值均值: {true_value[selected].mean():.3f}") print(f"未选群体的真实价值均值: {true_value[~selected].mean():.3f}") print(f"代理指标看似提升了 {proxy_gamed[selected].mean() - proxy[selected].mean():.2f}")
选中群体的真实价值并不比未选群体高多少——代理指标的提升是操纵出来的。防御手段是对抗性思维:设计指标时先问"如果有人只为这个数字 accountable,他会做什么"——刷量、拒难例、过滤高风险客群都是可预期的动作。配套动作是多指标互锁(响应时间必须与解决率同时达标)与定期换用留出指标做外部校核。
分布漂移与偏见放大:模型的两类慢性病
分布漂移指部署环境的数据分布离开训练分布:经济周期变了、疫情来了、传感器换型号了。模型对训练分布内的样本性能良好,对漂移后的样本静默劣化——程序不报错,指标缓慢下滑。体检手段是监控输入分布与预测分布:输入特征的分位数表随时间漂移、预测均值的缓慢爬升,都是早期信号。
偏见放大指模型从带历史偏见的训练数据学到偏见并规模化执行:招聘模型学到"历史录用者多为某类背景",就系统性地给另一类背景打低分——历史偏见被算法"洗白"成客观分数。诊断工具之一是分组指标对照:
import numpy as np rng = np.random.default_rng(9) n = 4000 group = rng.random(n) < 0.4 # 敏感属性标记 qual = rng.normal(0, 1, n) # 真实资质与分组无关 # 训练数据带历史偏见:某组历史通过率被人为压低 historical_bias = np.where(group, -0.7, 0.0) hired = (qual + historical_bias > 0.6).astype(float) # 模型忠实学到了带偏的规律 score = qual + historical_bias * 0.95 + rng.normal(0, 0.1, n) pred = (score > 0.6).astype(float) for g, name in [(group, "组A"), (~group, "组B")]: print(f"{name}: 实际通过率 {hired[g].mean():.1%}, " f"模型预测通过率 {pred[g].mean():.1%}") # 公平性度量:通过率之差 与 错误率之差 dp = pred[group].mean() - pred[~group].mean() err_a = np.mean(pred[group] != hired[group]) err_b = np.mean(pred[~group] != hired[~group]) print(f"通过率差 {dp:.3f}, 错误率差 {err_a - err_b:.3f}")
两组的真实资质分布相同,模型却给出系统性不同的通过率——它忠实地复制了历史偏见。补救从数据与目标两端下手:训练数据重加权或重采样抵消历史偏见、优化目标里加公平性约束(分组通过率差进损失函数)、部署后持续监控分组指标。公平不是算完再贴的标签,是要进建模流程的约束——这与第 6 章"把约束写进优化"完全同构。
可信交付清单:四件套成文
门诊的收尾医嘱,也是全册的收束。一份可信的模型交付文档至少包含:
- 假设登记:模型假设逐条列出,每条附"何时失效"(第 1 章的假设清单制度);
- 失效模式:已知的出错方式与数据指纹(第 1 章三类失效模式表的延续);
- 不确定性:关键输出的区间或分布(第 4、8 章的工具),外推场景单独声明;
- 复核机制:谁监控、多久复核、指标漂移超过多少触发重训,责任人写名字不写部门。
这份清单的价值在事故时刻兑现:模型出问题时,登记在册的假设与失效模式让排查有起点,不确定性声明让"模型说过它不确定"有据可查。反过来,没有清单的模型在事故后只能整体下线复盘——可信度是提前存进银行的,不是事后补办的。
再补一个值得反复咀嚼的观察:三类失效的共同根源是"优化目标与真实意图之间有缝隙"。Goodhart 是缝隙被策略性利用,漂移是缝隙随时间变宽,偏见是缝隙里藏着历史的私货。建模者的终身功课就是不断丈量并收窄这条缝。
可信建模四件套
本节要点回顾
- Goodhart 定律:进损失函数的量会被牺牲一切地优化,多指标互锁是对策;
- 分布漂移是慢性病,输入分位数监控是早期体检;
- 偏见放大要靠数据重加权与公平性约束进建模流程,事后贴标签无效;
- 四件套交付:假设登记、失效模式、不确定性、复核机制,责任到人;
- 共同根源是目标与意图的缝隙,建模者的功课是持续收窄它。