4.4 统计推断与贝叶斯
4.4 统计推断与贝叶斯:从数据下判决
本节摘要:统计推断研究如何用有限样本对总体下结论,三大工具是点估计、区间估计、假设检验;贝叶斯学派则把参数当随机变量、用数据更新信念。本节走完一次完整的 A/B 测试流程——从样本量规划到 p 值解读,实现朴素贝叶斯分类器,澄清 p 值与置信区间两大高频误读,并对比频率派与贝叶斯派的世界观差异与和解。
一场真实的法庭:A/B 测试
产品经理说"新版按钮点击率提升了"。这句话要成立,需要一套完整的推断流程:设计(样本量多大才够)、估计(提升幅度是多少)、检验(提升是真实还是噪声)、决策(误差代价不对称时怎么选)。背景设定:旧版点击率 10%,新版预期提到 11%——1 个百分点的差异,直觉听不出名堂,统计要说清"多大概率是真信号"。
第一步,样本量规划。检测 1 个百分点差异(显著性水平 0.05、功效 0.8)所需样本量由公式给出:
import math def required_sample(p1, p2, alpha=0.05, power=0.8): # 两比例检验的样本量公式(正态近似,双侧) z_alpha = 1.96 # alpha=0.05 的双侧分位数 z_beta = 0.84 # power=0.8 的分位数 p_bar = (p1 + p2) / 2 num = (z_alpha * math.sqrt(2 * p_bar * (1 - p_bar)) + z_beta * math.sqrt(p1 * (1 - p1) + p2 * (1 - p2)))**2 return math.ceil(num / (p2 - p1)**2) n = required_sample(0.10, 0.11) print(n) # 约 14700 组:每组需要的用户数 # 差异越小,所需样本按平方反比暴涨——"再跑一周看看"往往是伪复制的开始
第二步,模拟实验并做检验(双比例 z 检验,用第 3 章中心极限定理作正态近似的合法性来源):
import random def ab_test(n, p_old, p_new, seed=7): random.seed(seed) clicks_old = sum(random.random() < p_old for _ in range(n)) clicks_new = sum(random.random() < p_new for _ in range(n)) p1, p2 = clicks_old / n, clicks_new / n pooled = (clicks_old + clicks_new) / (2 * n) se = math.sqrt(pooled * (1 - pooled) * 2 / n) # 合并标准误 z = (p2 - p1) / se return p1, p2, z p1, p2, z = ab_test(15_000, 0.10, 0.108) print(f"旧版 {p1:.4f} 新版 {p2:.4f} z={z:.2f}") # z 超过 1.96 即在 0.05 水平显著;模拟出的差异约 0.8 个百分点,z 在 2 左右
p 值的正确读法:在"新版无差异"的原假设下,出现当前或更极端数据的概率。它不是"新版更优为假的概率",也不是"结果由运气造成的概率"。这两个误读在论文与产品评审中出现的频率高得惊人。置信区间的读法同样严谨:"重复实验所得区间有 95% 会覆盖真实差异",而不是"真实值落在此区间的概率是 95%"(真实值不是随机变量——频率派立场上)。
频率派与贝叶斯派的对照
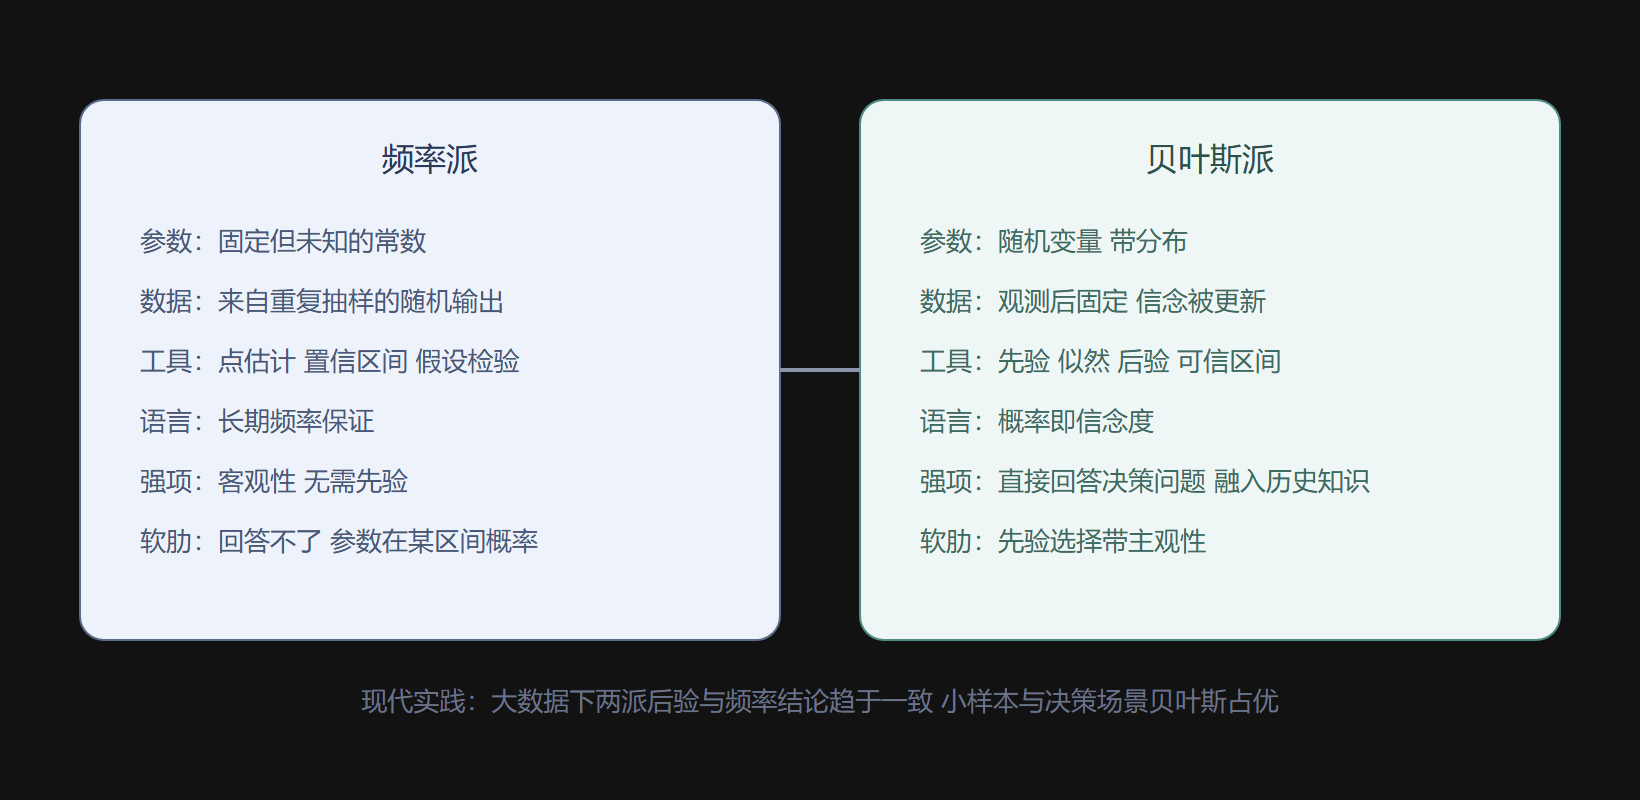
贝叶斯的看家应用:朴素贝叶斯分类器
垃圾邮件过滤是贝叶斯定理最著名的工业应用。朴素假设"特征(词)在给定类别下条件独立"——假设明显粗糙,但分类决策只需要后验的排序而非精确值,朴素假设下排序通常够用。几十行实现:
import math from collections import Counter, defaultdict class NaiveBayes: def fit(self, docs, labels): self.log_prior = {c: math.log(sum(l == c for l in labels) / len(labels)) for c in set(labels)} self.word_counts = {c: Counter() for c in set(labels)} self.total = {} for doc, lab in zip(docs, labels): self.word_counts[lab].update(doc) for c in self.word_counts: self.total[c] = sum(self.word_counts[c].values()) def predict(self, doc, vocab_size): scores = {} for c in self.log_prior: s = self.log_prior[c] denom = self.total[c] + vocab_size # 拉普拉斯平滑防零概率 for w in doc: s += math.log((self.word_counts[c][w] + 1) / denom) scores[c] = s return max(scores, key=scores.get) docs = [["免费", "中奖", "点击", "链接"], ["免费", "优惠", "限时"], ["会议", "纪要", "项目", "延期"], ["代码", "评审", "项目"]] labels = ["spam", "spam", "ham", "ham"] model = NaiveBayes(); model.fit(docs, labels) test = ["免费", "项目", "链接"] print(model.predict(test, vocab_size=10)) # 输出 spam:免费与链接的证据压过项目
对数化是数值工程的标配:大量小概率连乘会下溢到零,取对数变乘为加,一举解决。
误读清单与决策视角
除 p 值误读外,三条高频错误值得装进工具箱:多重比较——同时检验二十个指标,纯噪声也会有约 64% 概率出现至少一个"显著",须做校正;选择性停机——反复 peeking 数据一旦显著就停,实际显著性水平远超名义值(序贯检验或贝叶斯方法更稳);把显著当重要——大样本下微不足道的差异也会显著,效应量与置信区间比 p 值更有决策价值。统计的终点不是"有没有差异",而是"误差代价不对称时怎么行动":误杀一个真提升损失多少、上线一个假提升损失多少,期望损失最小才是决策准则。
⚠️ 给一条压舱的提醒:任何统计结论先问三件事——样本怎么来的、检验了多少个假设、区间有多宽。三问答完,大部分"惊人发现"自动降级。
本节要点回顾
- 推断三件套:点估计给单值、置信区间给范围、假设检验给判决,各有准确读法;
- 样本量按差异平方反比增长,A/B 测试的"再跑几天"多半是设计失误的遮羞布;
- p 值是数据的极端程度,不是假设为真的概率;多重比较与选择性停机会悄悄膨胀假阳性;
- 贝叶斯把参数当随机变量,朴素贝叶斯分类器靠"只需排序不需精确"在工业界长青;
- 决策视角收尾:效应量与代价结构比显著性星号更接近真实问题。
离散与随机的装备配齐。下一章冲向现实世界:建模、微分方程、数值方法与优化——数学的工程主战场。