5.1 数学建模方法论
5.1 数学建模方法论:翻译现实
本节摘要:数学建模是把现实问题翻译成数学结构、求解、验证、再迭代的过程。本节给出建模五步法与"假设登记表"工具,用人口增长的三个模型(指数、逻辑斯蒂、带迁移)做完整案例展开——每个模型的背景、推导、求解、数据验证与失效边界,最后给出模型复杂度与解释力的取舍经验。
为什么"套公式"不算建模
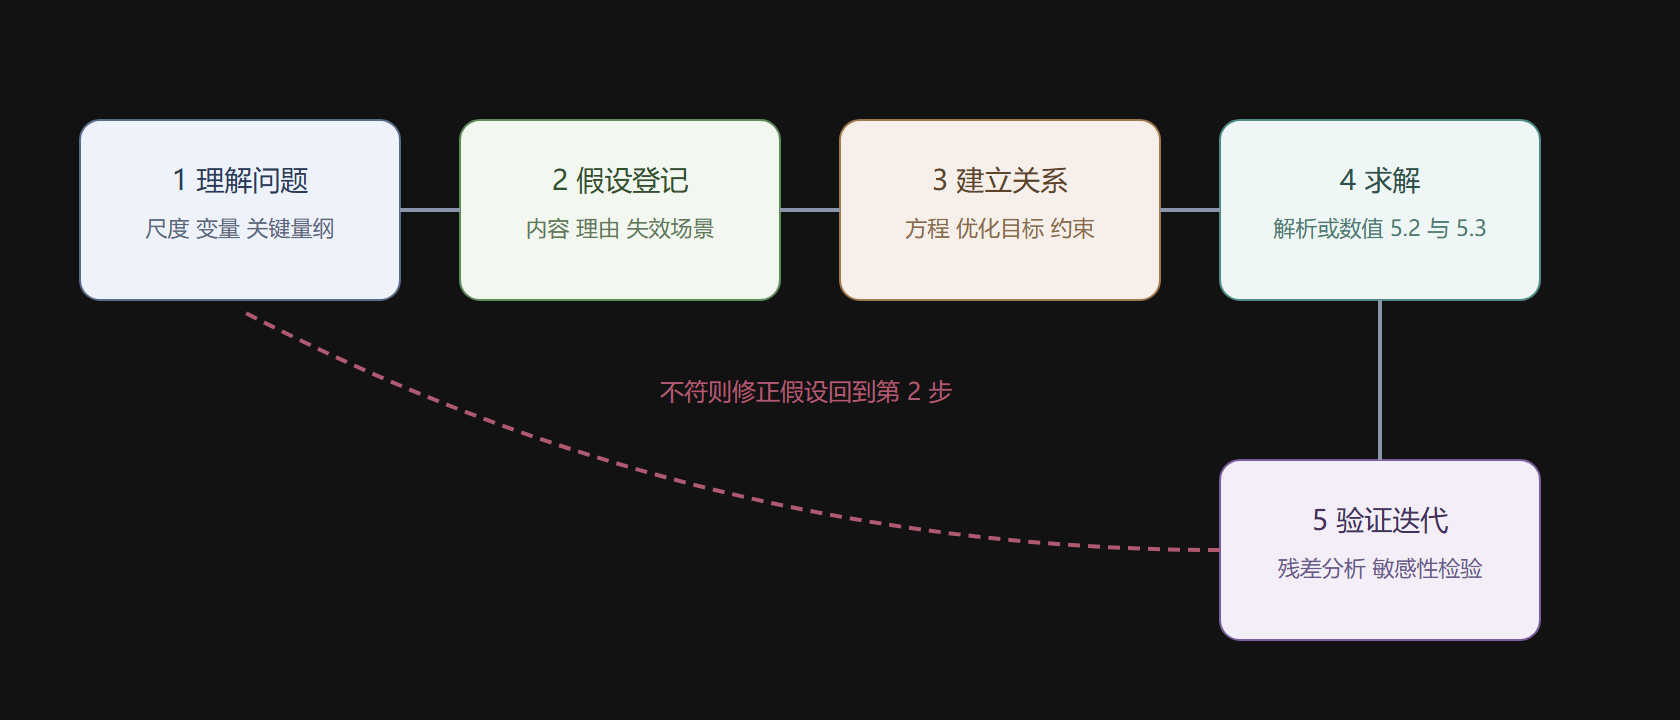
新手建模的典型症状是直接套现成公式,跳过了两个最关键的步骤:声明假设与对照数据验证。马尔萨斯 1798 年断言人口按几何级数增长,模型简洁有力,但两百年数据证明它只在短周期、资源充裕时近似成立——没有环境容纳量上限的模型,长期必然爆炸。建模的专业性恰恰体现在对失效边界的自知。完整流程五步:理解问题与确定尺度、引入变量与假设、建立关系(方程或优化目标)、求解、验证与迭代。其中假设是最值得花时间的一栏,推荐用"假设登记表"管理:每条假设写清内容、理由、预期失效场景。
| 模型 | 核心假设 | 增长形态 | 适用窗口 | 失效场景 |
|---|---|---|---|---|
| 指数增长 | 资源无限、增长率恒定 | 爆炸 | 短期、低密度 | 长期、资源紧张 |
| 逻辑斯蒂 | 环境容纳量 K 固定 | S 形趋于 K | 封闭种群中期 | 技术改变 K、迁移 |
| 带迁移项 | 与外界有流入流出 | 趋于修正平衡 | 开放城市、岛屿 | 迁移率本身波动 |
三个模型的完整推演
**模型一:指数增长。**设人口 P 的变化率与人口成正比,dP/dt = rP。分离变量积分得 P(t) = P(0)e^{rt}。双倍时间约为 0.69/r——增长率 2% 时约 35 年翻倍,这条换算至今是人口统计的口算工具。
**模型二:逻辑斯蒂。**引入容纳量 K,增长率随拥挤线性下降:dP/dt = rP(1 - P/K)。解析解是一条 S 形曲线,拐点恰在 K/2——"过半后增速放缓"的普适规律。数值与符号双验证:
import sympy as sp t = sp.symbols('t') P = sp.Function('P') r, K, P0 = 0.5, 1000, 50 sol = sp.dsolve(sp.Derivative(P(t), t) - r * P(t) * (1 - P(t) / K), P(t), ics={P(0): P0}) print(sol) # 输出逻辑斯蒂闭式解 P(t) = K / (1 + (K/P0 - 1)*exp(-rt)) # 数值对照:在几个时间点读出人口占比 P_expr = sol.rhs for yr in [0, 5, 10, 20, 30]: print(yr, float(P_expr.subs(t, yr))) # S 形爬升:50 -> 279 -> 764 -> 997 -> 1000 # 拐点在 P = K/2 = 500 附近,对应 t 约 6.5:增速由升转降的分水岭
**模型三:带迁移。**城市人口还受迁入率 m 的影响:dP/dt = rP(1 - P/K) + m。平衡点从 K 移到新的稳定值,求解一个二次方程即得。三个模型构成一条"复杂度阶梯":每上一级,多解释一类现象,也多引入一个待估参数——参数越多,拟合越好看,外推越危险(过拟合的数学版本,第 6 章 AI 一节会再遇到)。
import math def logistic_with_migration(t, r=0.4, K=1000, m=20, P0=100, steps=100000): # 无解析简单形式时用数值积分(欧拉法,5.3 节主角在此预告登场) dt = t / steps P = P0 for _ in range(steps): P += (r * P * (1 - P / K) + m) * dt return P for yr in [0, 10, 30, 100]: print(yr, logistic_with_migration(yr)) # 输出:100 -> 约 500 -> 约 700+ -> 稳定在约 720:迁移抬高平衡点 # 平衡点满足 rP(1-P/K)+m = 0,即二次方程的较大根——解析与数值互证
建模流程与验证回路
验证不是走过场
验证环节的专业做法有三层。残差分析:模型预测减去实测值,残差应无规律波动;残差随时间放大说明缺了一个状态变量。敏感性检验:把参数扰动 ±10%,看输出变化多少——对参数高度敏感的模型,参数估计误差会被放大到结论里。量纲检查:方程两边量纲必须一致,这条零成本的自查能拦下一半的低级建模错误。以逻辑斯蒂模型为例做敏感性:
def peak_time(r, K, P0): # 逻辑斯蒂达到某个目标占比的时间对 r 的敏感性(数值微分) target = 0.9 * K t, dt, P = 0.0, 1e-3, P0 while P < target: P += r * P * (1 - P / K) * dt t += dt return t h = 1e-4 sens = (peak_time(0.5 + h, 1000, 50) - peak_time(0.5 - h, 1000, 50)) / (2 * h) print(f"d(peak_time)/dr ≈ {sens:.1f}") # 输出约 -18:增长率提高 0.01,到达 90% 容纳量的时间提前约 0.18 单位 # r 的测量误差直接映射为时间预测误差——报告结论时必须带上这层敏感性
💡 建模的老兵经验:先做最笨的模型。指数模型十分钟建完,它的残差会告诉你下一步该加什么结构;从复杂模型起步的人,永远不知道误差来自哪一层假设。
本节要点回顾
- 建模五步法中假设登记与验证迭代是最容易被跳过、也最值钱的环节;
- 三个 population 模型展示复杂度阶梯:每加一个参数,多解释一类现象、多一分过拟合风险;
- 逻辑斯蒂拐点在容纳量一半处,S 形增长是封闭系统的普适签名;
- 验证三层(残差、敏感性、量纲)构成模型的质检流水线,敏感性决定结论可信度的表述方式;
- 先笨后巧的建模次序,让误差来源始终可追溯。
模型的"保质期"管理同样属于方法论的一部分:任何模型都嵌在特定的参数区间与环境假设里,超出区间外推前必须重新核验假设登记表。逻辑斯蒂模型的容纳量在技术进步下会被抬高(绿色革命改写了粮食人口模型),迁移率在经济周期里波动(城市人口模型的结构断点)。成熟的建模者会给每个模型标注"可信区间"与"失效哨兵指标"——当哨兵指标越界,模型自动降级为参考而非依据。这套做法与软件的版本管理在精神上完全一致:模型是有版本的知识,不是一锤定音的真理。
模型立起来之后,下一节处理"随时间演化"这类模型的主角:微分方程与动力系统。