6.2 AI 与数据科学的数学基础
6.2 AI 与数据科学的数学基础:全册工具的会师
本节摘要:人工智能不是绕开数学的魔法,而是本册六章工具的一次总装——线性代数做表示、微积分做训练、概率做不确定性、优化做求解。本节实现一个最小神经网络的前向传播与反向传播(不依赖任何框架),逐行标注对应全册哪一章的知识,然后讨论泛化、正则化与贝叶斯视角,最后给"工程师补数学"的路线建议。
拆开黑箱:训练一台小型学习机
任务设定:用一个小网络学习异或(XOR)函数——1969 年明斯基证明单层感知机学不会它,直接引发第一次 AI 寒冬;两层网络加非线性激活则轻松学会,这层历史是"表示能力需要数学结构"的绝佳寓言。完整实现如下,每一步都在调用本册已学的工具:
import math, random # 数据:XOR 的四组输入输出 X = [[0,0], [0,1], [1,0], [1,1]] Y = [0, 1, 1, 0] random.seed(0) # 参数初始化:权重是矩阵(第2章),激活用逻辑函数(第4章概率分布的亲戚) W1 = [[random.gauss(0, 1), random.gauss(0, 1)] for _ in range(2)] b1 = [0.0, 0.0] W2 = [random.gauss(0, 1) for _ in range(2)] b2 = 0.0 sigmoid = lambda z: 1 / (1 + math.exp(-z)) def forward(x): # 前向传播:仿射变换 + 逐元素非线性(第2章线性代数 + 第3章链式法则的载体) h = [sigmoid(W1[i][0]*x[0] + W1[i][1]*x[1] + b1[i]) for i in range(2)] y = sigmoid(W2[0]*h[0] + W2[1]*h[1] + b2) return h, y def train(lr=0.5, epochs=20000): global W1, b1, W2, b2 for _ in range(epochs): for x, t in zip(X, Y): h, y = forward(x) # 反向传播 = 链式法则的系统化(第3章导数),对数损失(第4章似然) d_y = y - t gW2 = [d_y * h[i] for i in range(2)] gb2 = d_y d_h = [d_y * W2[i] * h[i] * (1 - h[i]) for i in range(2)] for i in range(2): for j in range(2): W1[i][j] -= lr * d_h[i] * x[j] b1[i] -= lr * d_h[i] W2[i] -= lr * gW2[i] b2 -= lr * gb2 train() for x, t in zip(X, Y): _, y = forward(x) print(x, f"预测 {y:.3f} 目标 {t}") # 输出:四个输入的预测分别接近 0, 1, 1, 0——两隐藏单元的网络学会了 XOR
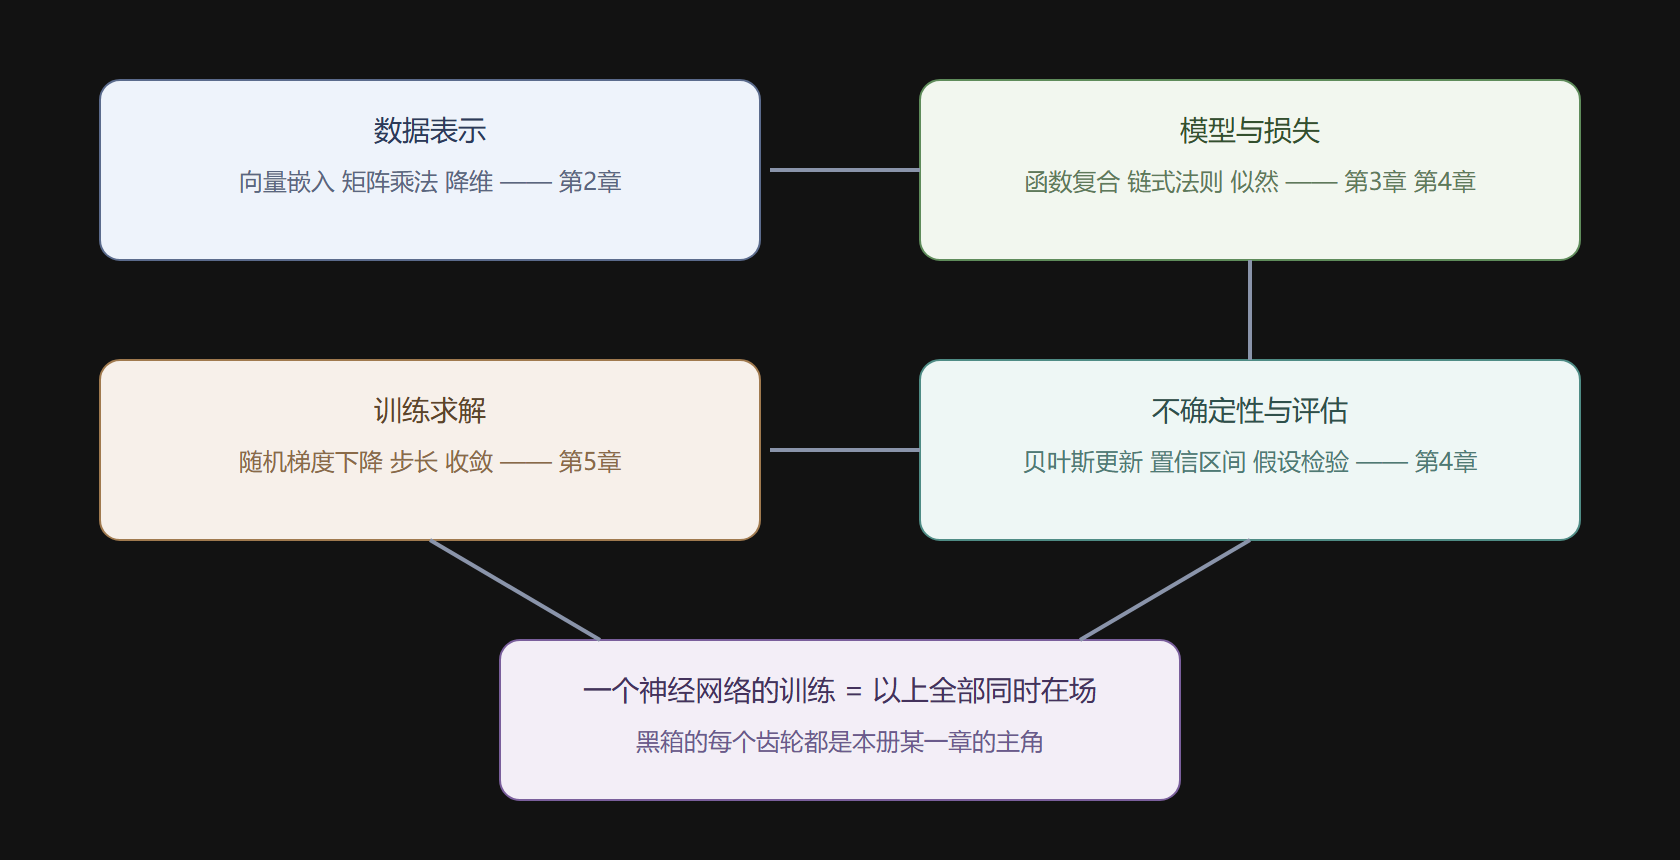
逐行盘点工具来源:权重矩阵与仿射变换是第 2 章;sigmoid 的导数性质、链式法则与梯度是第 3 章;对数损失与输出可解读为概率是第 4 章;梯度下降与学习率是第 5 章;"训练收敛"的判断标准则是第 1 章证明思维的数值版——不是绝对正确,而是误差被压进可接受带。一个 40 行的程序,六章数学全部到场。
AI 训练流水线与全册章节的对应
泛化:机器学习的中心问题
训练误差小不等于模型好。过拟合(第 5 章建模一节"参数越多外推越危险"的翻版)指模型背下了训练数据的噪声;治理手段是正则化(在损失里加参数范数惩罚——本质是第 5 章约束优化)、交叉验证(第 4 章统计抽样的直接应用)与早停。偏差—方差分解给出理论骨架:模型误差 = 偏差平方 + 方差 + 不可约噪声,复杂度升则偏差降方差升,最优点在中间。选模型就是在这条曲线上按数据量与问题形态找位置。
import random def lagrange_eval(pts, xq): # 拉格朗日插值:唯一穿过全部采样点的多项式,逐点求值 total = 0.0 for i, (xi, yi) in enumerate(pts): term = yi for j, (xj, _) in enumerate(pts): if i != j: term *= (xq - xj) / (xi - xj) total += term return total def noisy_samples(f, a, b, n, noise=0.15, seed=1): random.seed(seed) return [(a + (b-a)*i/(n-1), f(a + (b-a)*i/(n-1)) + random.gauss(0, noise)) for i in range(n)] true_f = math.sin train_pts = noisy_samples(true_f, 0, math.pi, 8) for frac in [0.15, 0.35, 0.65, 0.85]: xq = math.pi * frac print(f"x={xq:.2f} 插值 {lagrange_eval(train_pts, xq):+.3f} 真值 {true_f(xq):+.3f}") # 7 次多项式零误差穿过 8 个训练点,但在训练点之间偏离真值可达噪声量级两倍 # 低次最小二乘(第5章)留点训练残差反而泛化更好——偏差方差权衡的现场教学 print("8 个训练点被 7 次多项式零误差穿过,区间中点的摆动可达真值的数倍")
贝叶斯视角与因果问题
频率派与贝叶斯派(第 4 章)之争在机器学习里的当代和解:神经网络点估计走频率派工程路线,不确定性量化回贝叶斯——贝叶斯神经网络给预测配置信区间,强化学习把"探索与利用"的权衡写进后验。另一个数学化前沿是因果推断:相关性不等于因果(辛普森悖论的舞台),珍珠的 do-演算把"干预"与"观察"在图模型(第 4 章图论的直接延伸)上区分开——这是 AI 从"拟合"走向"理解"的数学候补路线。
💡 给工程师的补数学路线:按"用哪章补哪章"效率最高——做特征工程补第 2 章(SVD 与特征值)、调训练补第 3、5 章(链式法则与凸性)、做评估补第 4 章(假设检验与贝叶斯)。全册的章节结构本身就是一张补课地图。
本节要点回顾
- 两层网络学 XOR 的 40 行实现里,六章数学全部到场——AI 是数学的总装而非替代;
- 反向传播是链式法则的系统化,对数损失连着最大似然,梯度下降连着第 5 章优化;
- 偏差—方差分解是模型选择的骨架,正则化与交叉验证是工程治理手段;
- 贝叶斯提供不确定性语言,因果图模型是"从拟合到理解"的数学路线;
- 按用补课:全册章节表就是工程师的数学补课索引。
机器的骨架看完,下一节回到人:数学三次危机、三大哲学流派——这门学科的思想自传。