2.3 分布族图鉴:从二项到正态
2.3 分布族图鉴:从二项到正态
本节摘要:常见分布族是前人为典型随机机制定制的模板——计数成功次数用二项/泊松,等首次成功用几何,等间隔时间用指数,无偏好区间用均匀,多因叠加的结果用正态。本节逐个给出"生成机制 → 参数含义 → 典型场景"的选型档案,并用蒙特卡洛实验演示泊松近似与正态 68-95-99.7 规则。
看局选型:机制对了分布就对了
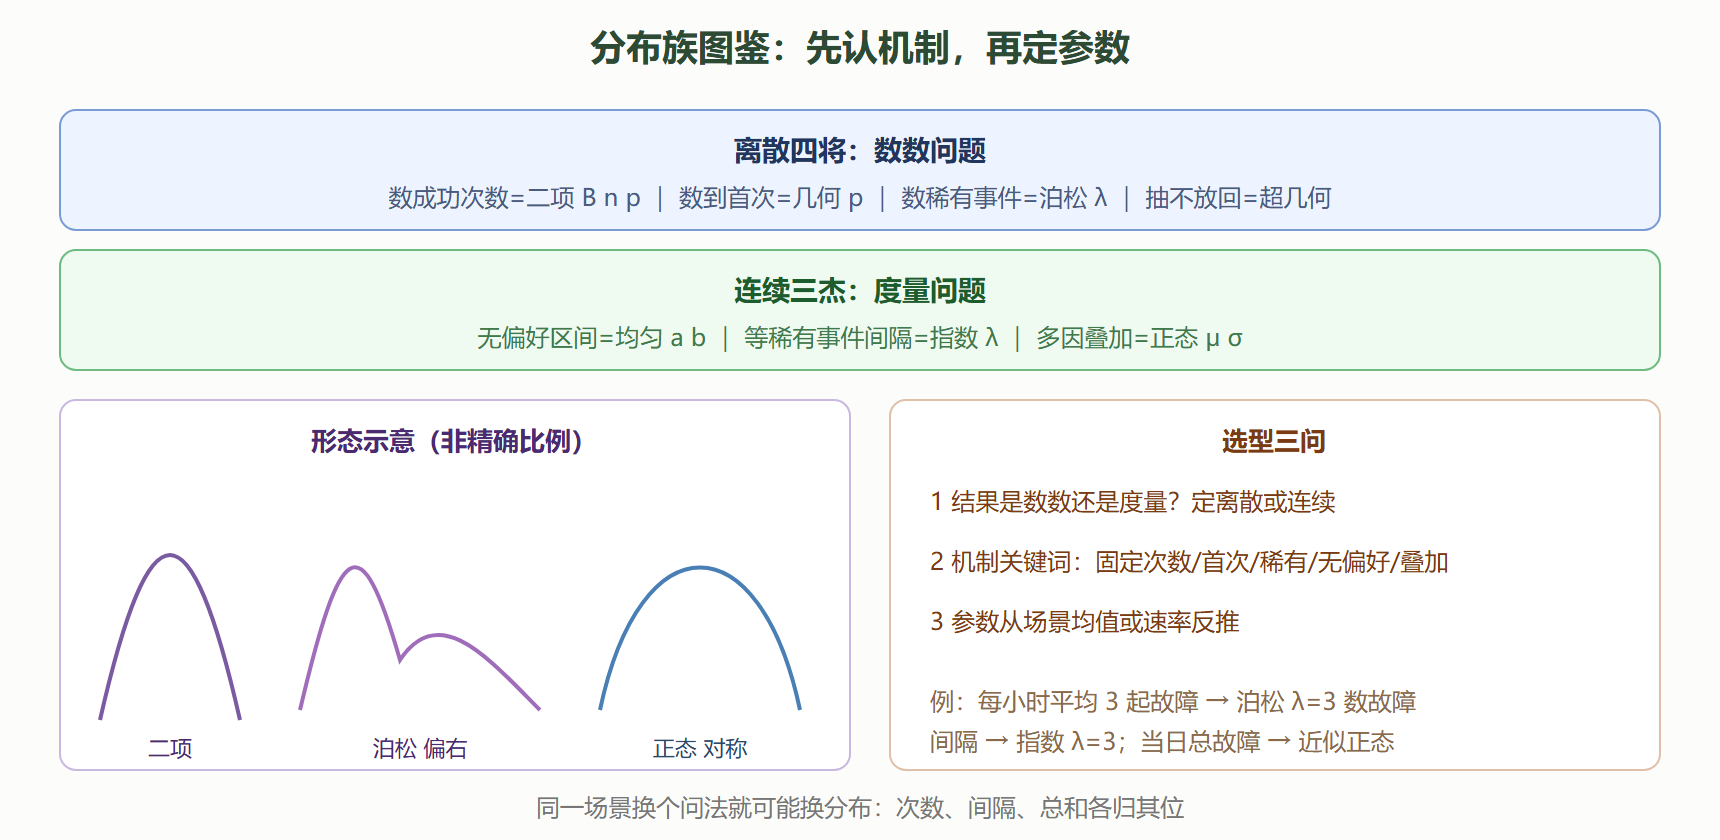
选分布不靠背表,靠识别"这个随机量是怎么被制造出来的"。六大件的制造机制一句话一个:
- 二项 B(n,p):独立重复 n 次伯努利试验,数成功次数。机制=固定次数、数成功。例:100 局轮盘押红赢的局数。
- 几何 G(p):独立重复直到首次成功,数试验次数。机制=数到首次。例:首次中彩前买了几注。
- 泊松 P(λ):单位时间/空间内稀有事件计数,二项在 n 大 p 小时的极限。机制=稀有事件计数。例:呼叫台一小时来电数、一页书的错字数。
- 均匀 U(a,b):区间内完全无偏好。机制=几何等可能。例:舍入误差。
- 指数 Exp(λ):相邻两个泊松事件的间隔时间。机制=等待稀有事件。例:器件寿命、两次故障间隔。
- 正态 N(μ,σ²):大量微小独立因素叠加,中心极限定理的产物。机制=多因叠加。例:测量误差、日产量波动。
参数含义要连着机制记:二项的 n 是次数、p 是单次胜率;泊松的 λ 是单位时间平均发生数;指数的 λ 是平均发生速率(平均等待 1/λ);正态的 μ 定中心、σ 定宽窄。选型时先问机制,再定参数,最后用数据校验——第三步留给第 8 章的拟合优度检验。
泊松近似:二项的稀有极限
二项 B(n,p) 在 n 大 p 小、np 适中时逼近泊松 P(np)。推导骨架:C(n,k)pᵏ(1−p)ⁿ⁻ᵏ 中令 p=λ/n,取极限得 e^(−λ)λᵏ/k!。实测一下这个近似的精度:
from scipy import stats n, p = 1000, 0.002 # np = 2 binom = stats.binom(n, p) pois = stats.poisson(n * p) for k in [0, 1, 2, 5, 8]: print(f"k={k} 二项精确 {binom.pmf(k):.6f} 泊松近似 {pois.pmf(k):.6f}" f" 相对差 {abs(pois.pmf(k)-binom.pmf(k))/binom.pmf(k):.2%}")
k=0 到 8 的各点上相对差在 0.1% 量级——稀有事件场景用泊松几乎无损。历史注脚:泊松分布 1837 年被正式发表前,1710 年阿巴思诺特和 1898 年波特凯维奇(普鲁士骑兵被马踢死人数的研究)已经在用它数"稀有死亡"。
正态:叠加的宿命
正态密度 f(x) = (1/√(2πσ²))·e^(−(x−μ)²/2σ²)。钟形、对称、由 μ 和 σ 完全决定。经验规则:±1σ 内约 68.3%,±2σ 约 95.4%,±3σ 约 99.7%。"六西格玛"质量管理名字的出处就是 3σ 与规格限的关系。用模拟把这三条数一遍,并演示"叠加趋于正态"的机制实验——把 12 个均匀 U(0,1) 相加减 6,形状立刻成钟:
import numpy as np rng = np.random.default_rng(9) z = rng.normal(0, 1, 1_000_000) print("落在 ±1σ: %.4f ±2σ: %.4f ±3σ: %.4f" % ((abs(z) < 1).mean(), (abs(z) < 2).mean(), (abs(z) < 3).mean())) # 叠加实验:12 个均匀之和(减去均值 6)近似正态 —— 早期模拟器的正态生成法 u_sum = rng.random((500_000, 12)).sum(axis=1) - 6 print("叠加后 均值 %.3f 方差 %.3f" % (u_sum.mean(), u_sum.var())) # 约 0 和 1 print("叠加后 |x|<2 占比 %.4f 对照正态 %.4f" % ((abs(u_sum) < 2).mean(), (abs(z) < 2).mean()))
叠加和落在 ±2 内的比例与真正态几乎一致——中心极限定理的预告片,第 5 章给正式定理。
图 2-3 六大分布族形态与选型路线
完整案例:呼叫台定员问题
某客服台来电服从泊松分布,平均每小时 3 起,每起通话时长独立。问"接下来一小时一起来电都没有"的概率与"第 3 起来电在两小时后才到"的概率:
from scipy import stats lam = 3 print("一小时零来电:", round(stats.poisson.pmf(0, lam), 4)) # e^-3 = 0.0498 # 来电计数 Poisson 3/小时 ⟹ 间隔 Exp 3/小时 ⟹ 首个间隔>2小时概率 print("首间隔超2小时:", round(stats.expon.sf(2, scale=1/lam), 4)) # e^-6 = 0.0025
一个问题牵出三个分布:计数是泊松、间隔是指数、长时间段的累计计数又可用正态近似——同一场景的不同问法对应不同分布,这是选型训练的核心一课。
补充:几何分布的无记忆表亲与超几何
几何分布还有一条常被忽略的性质:无记忆性。已买 10 注未中,从下一注起首次中奖的分布与从头开始完全相同——P(X>k+j | X>k) = P(X>j)。这与指数分布的无记忆性是离散/连续的镜像对,根源都是"独立重复里历史不提供信息"。超几何分布则对应"不放回抽样":N 件产品含 M 件次品,无放回抽 n 件,次品数服从超几何分布。当 N 很大时近似二项(抽不放回趋近有放回),第 4 章将看到它的负相关内核:
from scipy import stats # 超几何 vs 二项近似:N=1000 M=80 n=50 hyp = stats.hypergeom(1000, 80, 50) bin_ = stats.binom(50, 0.08) for k in [0, 3, 5, 8]: print(f"次品数={k}: 超几何 {hyp.pmf(k):.4f} 二项近似 {bin_.pmf(k):.4f}") # 几何分布无记忆性验证 g = stats.geom(0.25) print("P(X>5)=%.4f P(X>10)/P(X>5)=%.4f (应等于 P(X>5))" % (g.sf(5), g.sf(10)/g.sf(5)))
本节要点回顾
- 选型看机制:固定次数数成功、数到首次、稀有计数、无偏好、叠加,五类机制五族模板
- 泊松是二项的稀有极限:n 大 p 小且 np 适中时相对误差在千分量级
- 指数与泊松是同一枚硬币:计数用泊松、间隔用指数,λ 共享
- 正态是叠加的宿命:68-95-99.7 规则可被百万次模拟精确复现
- 参数连着机制:λ 是速率、1/λ 是平均等待、np 是期望成功数
- 问法决定分布:次数、间隔、总和在同一场景各归其位