1.1 浮点数表示与精度陷阱
1.1 浮点数表示与精度陷阱
本节摘要:IEEE 754 双精度浮点数用 64 位二进制近似实数,机器精度约为 2.2e-16。本节拆解浮点格式的三段式结构,解释 0.1 加 0.2 不等于 0.3 的根本原因,并盘点上溢、下溢、非规格化数这些表示层的常见陷阱。
案发现场:一道八成的工程师答不准的题
在 Python 里执行下面两行,结果是 True 还是 False?
print(0.1 + 0.2 == 0.3) # False print(0.1 + 0.2) # 0.30000000000000004
很多人知道答案,但追问一句"多出来的 4 从哪来"就卡住了。这不是 Python 的 bug,C、Java、JavaScript 全部如此,因为它们都遵守同一个标准:IEEE 754 二进制浮点。要读懂后续所有误差案件,必须先解剖这台机器的内部结构。
二、取代表示层的物证:64 位的分赃方案
一个 double 把 64 位分成三段:
- 符号位(1 位):0 正 1 负。
- 指数域(11 位):存"缩放倍数",用偏移码表示,偏移量 1023。
- 尾数域(52 位):存二进制有效数字,隐含首位 1(规格化数)。
于是任何非零浮点数都能写成 \pm m \times 2^{e} 的形式,其中 m 有 53 位二进制有效数字。关键在于:十进制的 0.1 换算成二进制是 0.000110011001100…无限循环,52 位尾数装不下,只能在最低位做一次舍入。存进来的实际值是:
from decimal import Decimal print(Decimal(0.1)) # 0.1000000000000000055511151231257827021181583404541015625
这个输出就是第一份正式物证:你以为在用 0.1 计算,其实从一开始就用错了数。0.1 + 0.2 的结果 0.30000000000000004,不过是两份初始偏差叠加运算舍入之后的总和。
动手把 1.0 的位模式拆开看:
import struct def dissect(x): bits = struct.unpack('>Q', struct.pack('>d', x))[0] sign = bits >> 63 exponent = (bits >> 52) & 0x7FF mantissa = bits & 0xFFFFFFFFFFFFF return sign, exponent, mantissa print(dissect(1.0)) # (0, 1023, 0):指数偏移 1023,尾数全零 print(dissect(0.1)) # (0, 1019, 2702159776422298):尾数是一长串 0011 循环的截断
三、机器精度:这套系统的最小刻度
浮点数在 1 附近最密集,相邻两个数的间隔叫机器精度,NumPy 里直接可查:
import numpy as np print(np.finfo(float).eps) # 2.220446049250313e-16
它约等于 2^{-52}。含义要读准:任何一次浮点运算的结果,都等于真实结果再附加一个相对误差不超过 eps/2 的扰动——前提是没有溢出和抵消。这给全书提供了一个天然的"噪声地板":凡是误差低于这个量级的差异,讨论它没有意义;凡是声称结果精确到 1e-18 的双精度程序,一定在撒谎。
一个直观实验——往 1.0 上加越来越小的量,看什么时候"加不动":
d = 1e-16 while 1.0 + d != 1.0: d /= 2 print(d) # 1.1e-16 左右,恰好是 eps 的一半
四、表示层的三个陷阱
图 1.1-1 浮点数轴上的密度分布示意
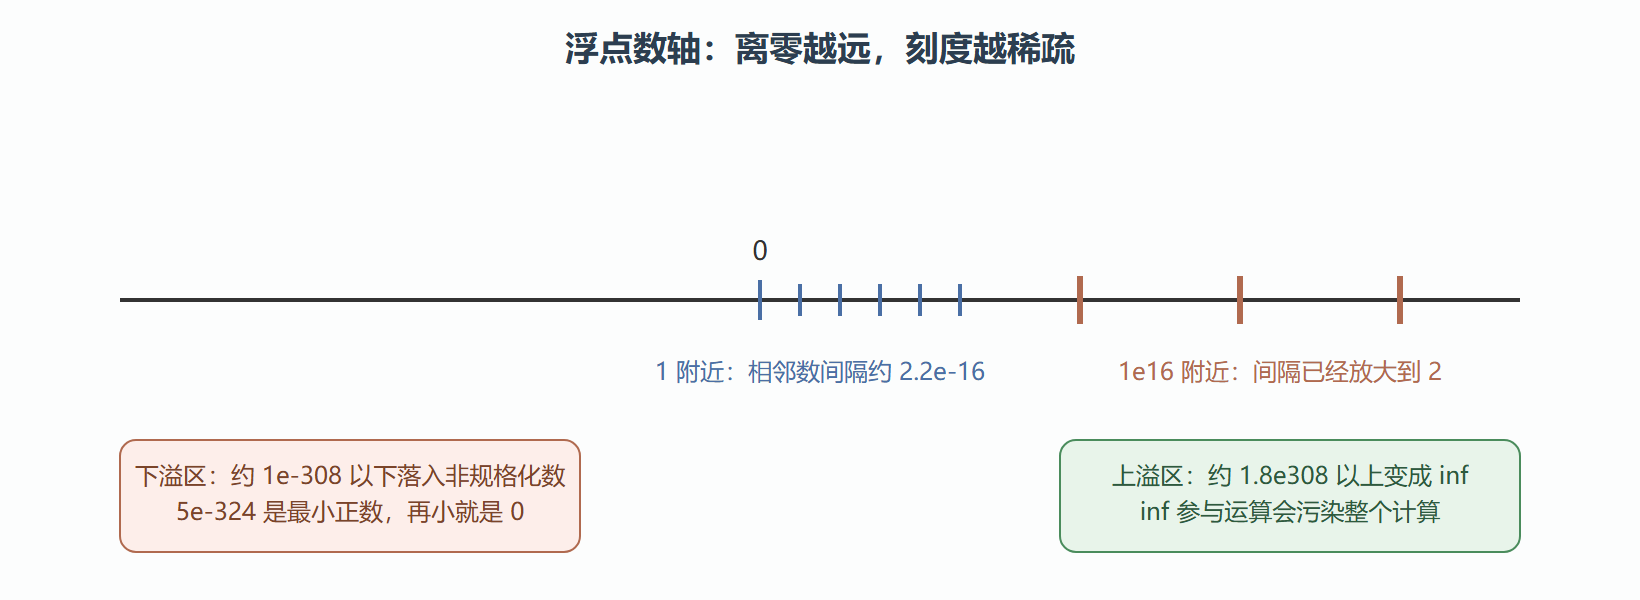
陷阱一:上溢与下溢。 超过约 1.8e308 变 inf,inf 会像油污一样扩散——inf - inf 得 nan,此后所有结果作废。小于约 1e-308 时进入非规格化数区间,精度断崖式下降,运算变慢。概率计算里大量小数相乘是下溢高发区,标准对策是取对数在对数域计算。
陷阱二:大数吃小数。 演示:
big = 1e16 print(big + 1 == big) # True,1 被完全吞掉
1e16 附近的刻度已经是 2,加 1 根本落在刻度缝里。累积求和时早期的大和会持续吞掉后面的小项,1.2 节展开此案。
陷阱三:十进制显示的糖衣。 Python 的 repr 只显示最短的能往返还原的二进制近似串,所以 print(0.1) 显示得干干净净。要看真相必须用 Decimal 或 x.hex()。很多对账误差拖了几个星期才发现,就是因为显示层把表示误差藏起来了。
⚠️ 常见坑:把浮点数当字典键或做相等比较。正确姿势是
abs(a - b) <= tol * max(abs(a), abs(b)),容差 tol 至少给几个 eps,且要结合问题本身的误差水平设定,而不是无脑用 1e-9。
五、延伸实战:金额计算为什么改用十进制
浮点陷阱的直接产业回应是 Decimal 类型:它以十进制存储、精确表示 0.1 这类小数,代价是慢十倍以上、且必须显式指定精度。观察同一个累加实验在两种类型下的表现:
from decimal import Decimal, getcontext getcontext().prec = 28 total_f = 0.0 total_d = Decimal(0) for _ in range(100): total_f += 0.1 total_d += Decimal("0.1") # 注意:必须用字符串构造 print(total_f == 10.0) # False print(total_d == Decimal("10.0")) # True
一个细节值得单独记档案:Decimal(0.1) 与 Decimal("0.1") 是两个不同的数——前者先把 0.1 按二进制舍入再转换,误差原样带进十进制世界。选型结论三条:科学与统计计算继续用 float(快、生态全);钱的账目用 Decimal 或整数分币;两者混用的接口边界是事故高发区,审计时要专门检查类型转换行。
结案陈词
表示层的结论可以压成三句话:浮点数是实数的有限采样,采样密度随远离零而骤降;0.1 类十进制小数在二进制里天然不精确,误差从存入那一刻就存在;任何比较都要带容差,任何"精确到 eps 以下"的说法都不成立。下一节让这块物证动起来——误差进入加减乘除之后,如何按固定法则繁殖和放大。