1.3 高精度算术与误差补偿
1.3 高精度算术与误差补偿
本节摘要:当改写公式仍不能满足精度要求时,有两类补救手段:一是算法层的不动用额外精度的补偿技术(Kahan 补偿求和),二是数据层的扩展精度(long double、math.fsum、mpmath 任意精度)。本节实现并实测这些方法,给出各自的开销与适用边界。
一、结案工具箱的分层
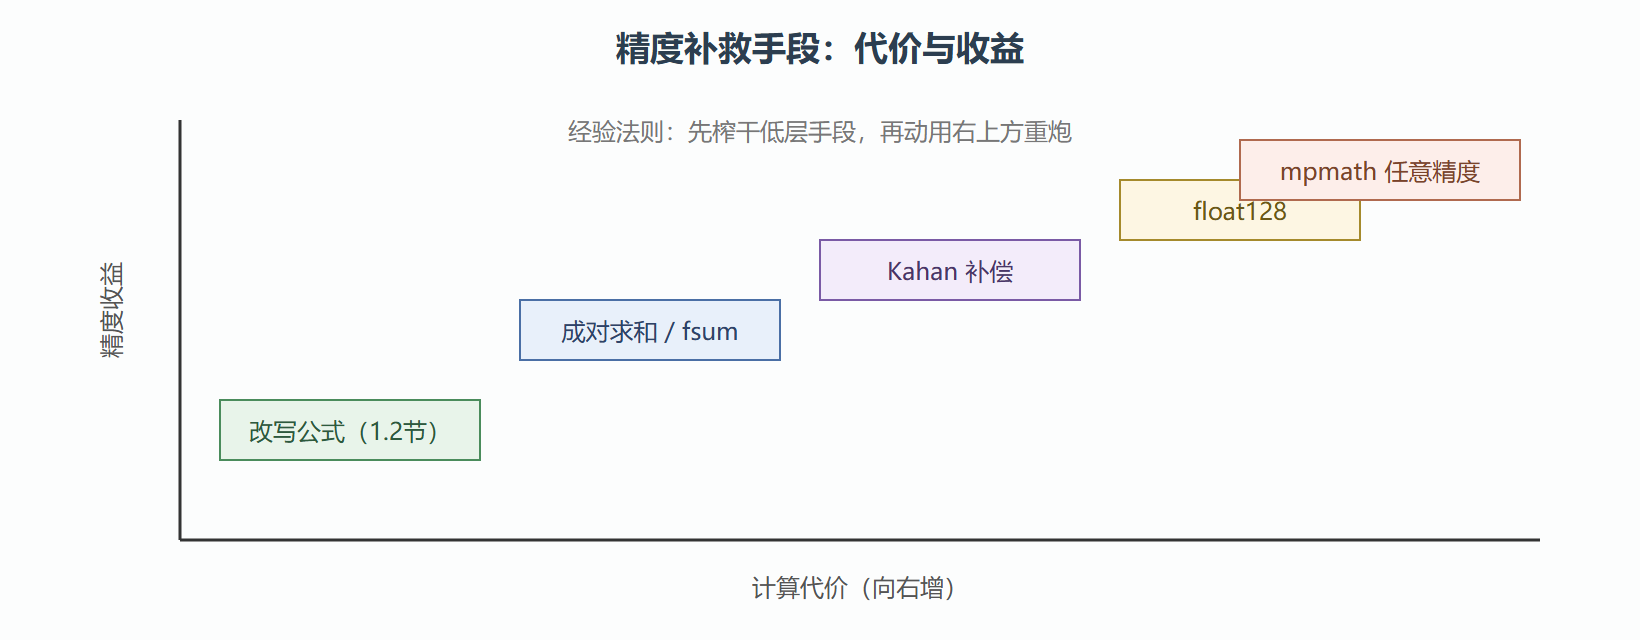
1.2 节的结论是"先改公式、再改顺序"。但有些场景两条路都堵死:金融系统要精确累加千万笔带小数的金额,物理仿真要在长时间积分里控制能量漂移,统计计算要在对数域累加大规模似然。此时工具箱剩下三层,按代价从小到大:
- 补偿算法:仍是 float64,用聪明的记账把舍入误差"找回来",速度损失 2–4 倍
- 精确舍入求和:标准库
math.fsum,内部用扩展精度累加,几乎不丢位 - 任意精度:mpmath / decimal,精度任意但要价高昂,慢 1–3 个数量级
二、Kahan 补偿:给舍入误差记一本流水账
朴素求和时,每次加法都会把"想加的量"与"实际加进去的量"之间的差额舍掉。Kahan 的思路朴素得漂亮:用一个变量 c 记住这个差额,下一次加法时先补上。
import numpy as np def kahan_sum(arr): s = 0.0 c = 0.0 # 补偿项:累积被舍掉的低位 for x in arr: y = x - c # 先把上一次欠的补回来 t = s + y # 实际加法(可能又产生新的舍入) c = (t - s) - y # 代数上恒为 0,浮点上恰好捕获本次舍入差额 s = t return s rng = np.random.default_rng(42) data = rng.uniform(1e12, 1e12 + 1, size=100000) # 大基数 + 小变化,最恶劣的求和场景 naive = 0.0 for x in data: naive += x ks = kahan_sum(data) ref = float(np.float128(0)) acc = np.float128(0) for x in data: acc += np.float128(x) ref = float(acc) print(f"朴素求和误差: {abs(naive - ref):.3e}") print(f"Kahan 误差: {abs(ks - ref):.3e}") print(f"fsum 误差: {abs(np.math.fsum(data) - ref):.3e}") # 典型输出:朴素 3e-2 量级,Kahan 与 fsum 在 1e-4 以下甚至全精度
解读:(t - s) - y 这一行在实数上恒等于零,但在浮点上,t 是舍入后的和,这个表达式恰好把本次被丢掉的低位提取出来存进 c。它不能消灭误差,但把"随机漂移"变成了"记账追讨"。注意 Python 的 math.fsum 通常比手写 Kahan 更准(它内部按分段扩展精度处理),工程中优先用 fsum 或 np.sum(成对求和),手写 Kahan 的价值在于理解机制和移植到不支持这些库的语言。
三、对数域:下溢的正解
概率连乘是下溢重灾区。1000 个 0.5 相乘得 9e-302 已经贴地,10000 个直接归零。取对数把乘法变加法:
import numpy as np p = np.full(20000, 0.6) prod = np.prod(p) # 0.0,下溢 logsum = np.log(p).sum() # 约 -10218.7,信息完整保留 # 恢复相对量级: print(np.exp(logsum)) # 仍然下溢为 0,但比较、归一化都在对数域完成 # SciPy 提供数值稳定的 log-sum-exp: from scipy.special import logsumexp logZ = logsumexp(np.log(p)) # 累加对数值的标准姿势
要点:对数域不只是防下溢,它还把 1.2 节的"求和顺序"问题一并继承过来——大规模对数累加同样应使用成对或补偿策略,logsumexp 内部已处理好减最大值的稳定性。
四、任意精度:重炮的射界
mpmath 允许指定十进制有效位数,适合"验证怀疑":当 float64 结果可疑时,用高精度算一遍当参考答案。
图 1.3-1 精度工具的代价收益图谱
from mpmath import mp, mpf, sqrt mp.dps = 50 # 50 位十进制精度 b, c = mpf(10)**8, mpf(1) disc = sqrt(b*b - 4*c) r_small = (-b + disc) / 2 # 即便高精度,直接算小根仍有轻度抵消 r_small_via_vieta = c / ((-b - disc) / 2) print(r_small_via_vieta) # 1e-8,50 位全精度 print(abs(r_small - r_small_via_vieta) < mpf(10)**(-40)) # 比较两种算法
边界要认清:高精度只是把 eps 缩小,条件数大的问题上它同样被放大吞噬——50 位精度遇到条件数 1e40 的问题照样全军覆没。mpmath 的正确定位是法庭上的复核鉴定,而不是日常生产线。
⚠️ 常见坑:以为把变量声明成 float128 或 mpmath 就一劳永逸。若中间环节(如 NumPy 的 C 层运算)把数据压回 float64,精度在接口处静默丢失。高精度必须贯穿整条计算链路才有意义。
五、案例收尾:给第一章结案
把三节串起来还原一个完整破案流程:某对账系统日报金额与流水差了几分钱。第一步(1.1)确认 0.01 元在二进制不精确,且累计百万笔后偏差可见;第二步(1.2)定位到朴素顺序累加放大了单向舍入;第三步(1.3)改用 math.fsum,偏差归零;若未来涉及利滚利的连乘,则预先规划对数域方案。没有一步需要"更高明的数学",需要的是知道误差在哪里产生、如何传播、用什么工具止血。
本节要点回顾
- Kahan 补偿:用代数上恒为零的表达式捕获每次舍入差额,误差从漂移变为记账,工程中优先
math.fsum - 成对求和:误差 O(log n),NumPy 默认策略,长数组求和不要手写循环
- 对数域:概率连乘的标准避险姿势,配合
logsumexp保证数值稳定 - 任意精度:用作参考答案的复核工具,慢 1–3 个数量级,且救不了病态问题
- 分层原则:改公式 → 换顺序/算法 → 补偿 → 扩展精度,代价递增,按需动用
第一章物证学到此结案。第二章进入线性系统案发现场,条件数将从定性直觉升级为定量判决。