3.3 梯度下降的锯齿病理
3.3 梯度下降的锯齿病理
本节摘要:梯度下降在病态(条件数大)目标函数上呈现锯齿轨迹:每步与最优方向近乎正交,收敛速度以 (κ-1)/(κ+1) 的速率衰减。动量、共轭梯度、BFGS 分别从三个方向治理此病。本节在狭长二次山谷上完整复现锯齿现场并实测各疗法的疗效。
一、案发现场:Rosenbrock 山谷
最小化 f(x, y) = 100(y - x^2)^2 + (1-x)^2,最优解在 (1,1)。这个函数的等高线是一条抛物线形窄谷——谷底平坦、两壁陡峭,条件数极大。梯度下降的表现:
import numpy as np def grad_descent(g, x0, lr, steps): x = np.array(x0, dtype=float) path = [x.copy()] for _ in range(steps): x = x - lr * g(x) path.append(x.copy()) return np.array(path) rosen_g = lambda z: np.array([ -400 * z[0] * (z[1] - z[0]**2) - 2 * (1 - z[0]), 200 * (z[1] - z[0]**2) ]) path = grad_descent(rosen_g, [-1.2, 1.0], lr=1e-3, steps=20000) print(f"20000 步后位置: {path[-1]}") # 仍离 (1,1) 很远 print(f"距最优解距离: {np.linalg.norm(path[-1] - [1,1]):.4f}")
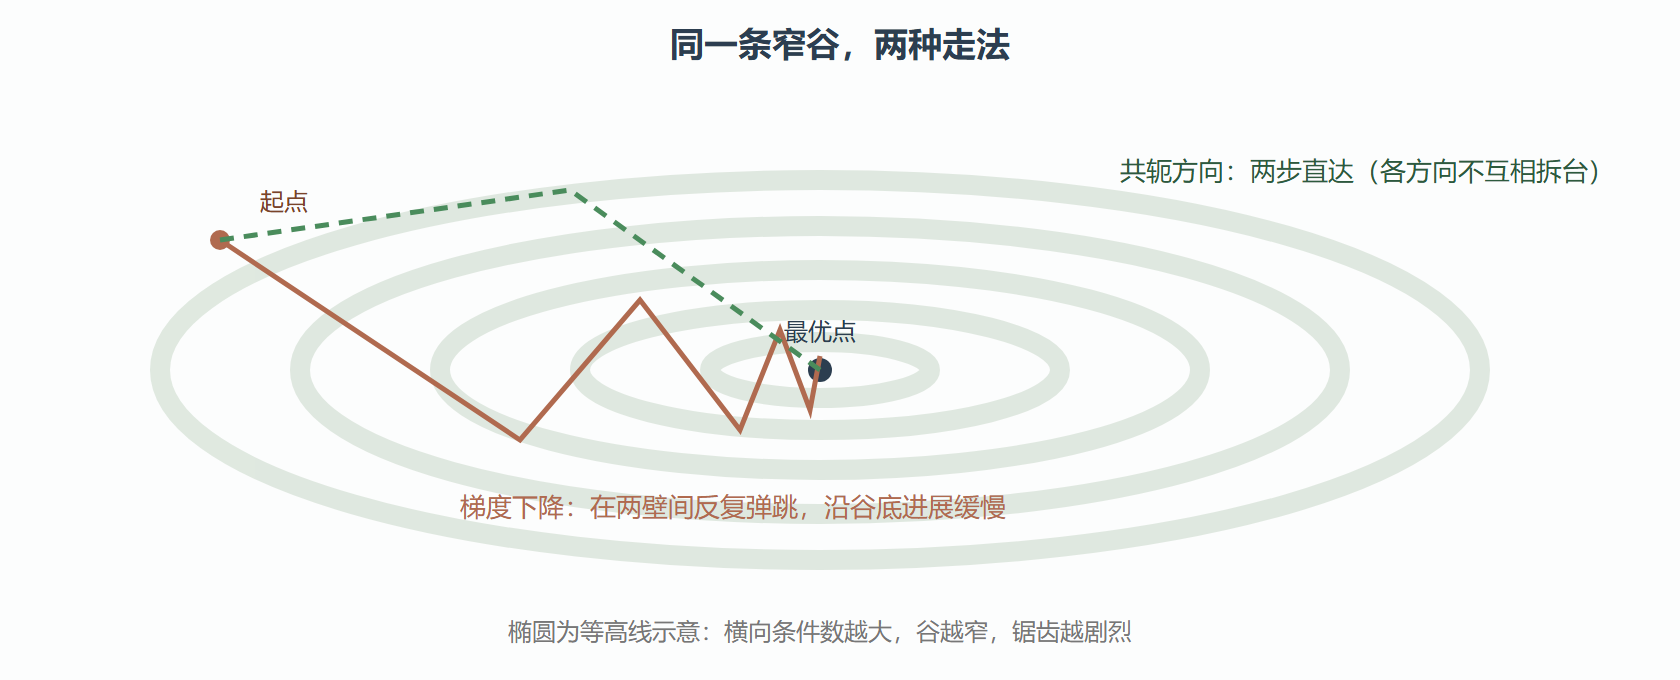
两万步还没爬到谷底。学习率调大一点直接发散(震荡幅度超过谷宽),调小则慢上加慢。病理:在窄谷里,负梯度方向大部分分量指向谷壁(陡方向),沿谷底前进的分量(缓方向)微弱——每走一步都被谷壁"弹回",轨迹呈之字形。
二、定量诊断:条件数如何给收敛定速
用一个可控条件数的二次函数做纯化实验:
import numpy as np def make_quad(kappa): A = np.array([[1.0, 0.0], [0.0, kappa]]) # 条件数 = kappa return lambda z: 0.5 * z @ A @ z, lambda z: A @ z for kappa in [1, 10, 100, 1000]: f, g = make_quad(kappa) x = np.array([10.0, 10.0]) lr = 2 / (1 + kappa) # 理论最优学习率 for k in range(200): x = x - lr * g(x) print(f"kappa={kappa:5d}, 200步后误差: {np.linalg.norm(x):.3e}") # 误差 = 初始误差 × (速率)^200,速率 = (kappa-1)/(kappa+1)
证词:收敛速率是 \frac{\kappa-1}{\kappa+1}。κ=1 时速率为 0(一步到位,完美圆形等高线);κ=1000 时速率约 0.998——每步只消减 0.2% 的误差,需要数千步。**结论:学习率救不了病态**,理论最优学习率下速度仍由条件数单方面决定。这与 2.3 节 CG 的处境形成对照:CG 把惩罚开平方,梯度下降连本带息照单全收。
图 3.3-1 窄谷中的锯齿轨迹与共轭方向对比(示意)
三、三种手术方案
方案一:动量——给迭代装上惯性
动量项把历史上的下降方向累积起来,谷壁方向的震荡相互抵消(一正一负),谷底方向的速度持续叠加。深度学习里 Adam、Nesterov 都是这个思想的变体。对 κ=1000 的二次问题,重型动量能把有效条件数降到约 √κ。
方案二:共轭梯度——第二章老朋友的优化版
CG 在 2.3 节解方程,这里最小化二次泛函,数学上是同一件事的两种表述。对 κ=1000 的二维山谷,CG 两步精确到达;高维时误差按 √κ 衰减。小规模非线性优化中 SciPy 的 method='cg' 即此。
方案三:BFGS——用历史构造曲率近似
拟牛顿家族的核心洞察:牛顿法要的 Hessian 可以从梯度差分中累积重建,不必显式计算。BFGS 维护一个矩阵 B 近似 Hessian 逆,每步用最新一对 (位移, 梯度差) 做秩二更新:
from scipy.optimize import minimize import numpy as np rosen = lambda z: (1-z[0])**2 + 100*(z[1]-z[0]**2)**2 for method in ['BFGS', 'CG', 'Newton-CG']: res = minimize(rosen, x0=[-1.2, 1.0], method=method, tol=1e-12) print(f"{method:10s} 迭代 {res.nit:3d} 步, 函数调用 {res.nfev} 次, " f"终点误差 {np.linalg.norm(res.x - [1,1]):.2e}")
典型结果:BFGS 几十步收敛,且不需要用户提供 Hessian——这使它成为中小规模无导数信息优化的默认选择。大规模问题(参数百万级)BFGS 的矩阵存不下,退回 L-BFGS(只存最近几对向量,内存 O(n)),它是深度学习之前时代大规模优化的王者。
⚠️ 常见坑一:把机器学习里的"调学习率"当成万能药。本节实验已经证明:即便取理论最优学习率,条件数决定的速度上限纹丝不动——该换算法时调参是浪费时间。
⚠️ 常见坑二:给 Rosenbrock 这类函数上固定步长梯度下降并期待收敛。正确姿势是线搜索或信赖域包住每一步(3.2 节的保险丝在这里同样适用)。
四、结案:优化方法速查判决表
| 方法 | 每步成本 | 需要导数 | 病态抗性 | 典型场景 |
|---|---|---|---|---|
| 梯度下降 | 极低 | 一阶 | 差(κ 定速) | 超大规模、流式数据 |
| 动量/Adam 类 | 低 | 一阶 | 中(√κ 级) | 深度学习 |
| 共轭梯度 | 低 | 一阶 | 好(√κ) | 大规模二次型 |
| L-BFGS | 中 | 一阶 | 好 | 中大规模光滑优化 |
| 牛顿/信赖域 | 高 | 二阶 | 优 | 中小规模高精度 |
判决逻辑一句话:规模决定一阶还是二阶,条件数决定裸奔还是上共轭/拟牛顿。
本节要点回顾
- 锯齿病理:窄谷中负梯度绝大部分用于撞墙,条件数通过速率 (κ-1)/(κ+1) 给收敛封顶
- 学习率的边界:最优学习率只优化常数因子,改变不了 κ 决定的指数
- 三路手术:动量靠惯性抵消震荡、CG 靠方向共轭不拆台、BFGS 靠历史重建曲率
- L-BFGS:把 Hessian 逆近似压缩成几对向量,大规模场景的工程折中
- 选型口诀:规模定阶数,条件数定算法家族
第三章结卷。第四章把"迭代"推向极限——微分方程数值解要迭代数百万步,误差从"一次案件"升级为"长期慢性病"。