6.1 NumPy 与 SciPy 的数值边界
6.1 NumPy 与 SciPy 的数值边界
本节摘要:数值库的默认行为里藏着若干改变结果的隐性约定:NumPy 整数溢出静默回绕、求和默认成对策略、矩阵乘法对特殊值的处理与朴素预期不同、随机数流管理影响可复现性。本节逐个实测这些边界,给出规避写法。
一、现场一:整数溢出的无声事故
import numpy as np a = np.array([2**62, 2**62], dtype=np.int64) print(a.sum()) # -9223372036854775808,静默回绕成负数! # Python 原生整数是任意精度,行为完全不同: print(2**62 + 2**62) # 9223372036854775808,正确
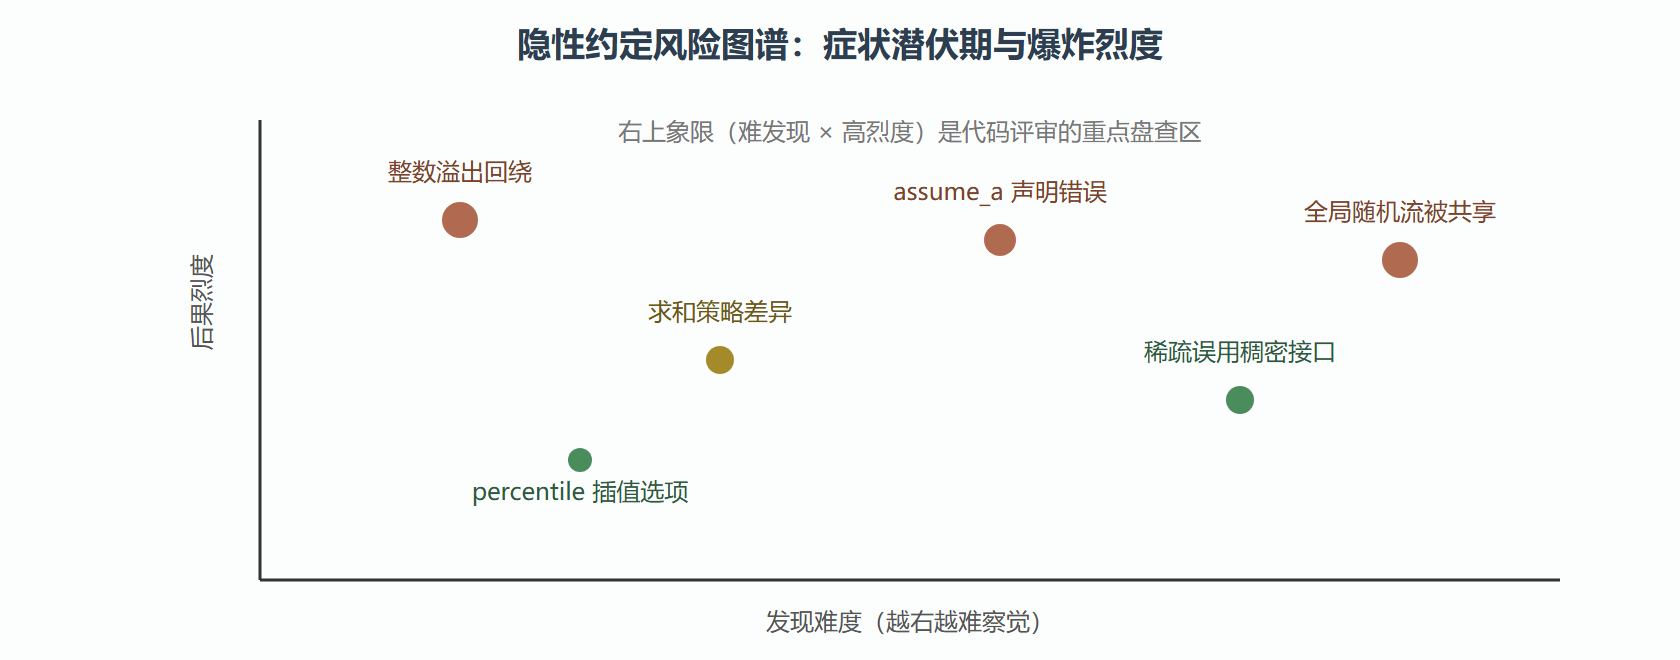
NumPy 的定长整数溢出不抛异常、不告警,结果直接回绕——如果这个和进入后续计算,污染会一路扩散。避险原则:计数量可能超 2 的 63 次方的场景(计数、累积乘积、字节统计)用 Python 原生 int 或显式换成 float/对象 dtype;组合数计算(排列组合连乘)是重灾区。
二、现场二:聚合函数的策略差异
同一个求和,不同接口给出不同结果,各有道理:
import numpy as np import math rng = np.random.default_rng(0) data = rng.uniform(1e12, 1e12 + 10, 50_000) print(f"np.sum : {data.sum():.6f}") # 成对求和 naive = 0.0 for v in data: naive += v print(f"朴素循环 : {naive:.6f}") # 顺序求和,偏差可见 print(f"math.fsum: {math.fsum(data):.6f}") # 精确舍入,当参考答案
三个结果的小数位不一致。第一章已经解释了机理;工程结论是:对账、对账类代码用 fsum 当仲裁,差异超过 eps 量级乘 N 时要怀疑顺序策略。类似的边界还有 np.mean(先求和再除,继承求和策略)与 np.percentile 的插值选项(不同插值方法在分位数上给出不同值,统计报告必须注明)。
三、现场三:线性代数模块的分工
import numpy as np from scipy import linalg as sla A = np.array([[1e-20, 1.0], [1.0, 1.0]]) b = np.array([1.0, 2.0]) x1 = np.linalg.solve(A, b) lu, piv = sla.lu_factor(A) x2 = sla.lu_solve((lu, piv), b) print(np.allclose(x1, x2)) # True,两者都带主元处理
更大的差异在能力边界:numpy.linalg 只覆盖稠密问题的核心操作;scipy.linalg 提供lu_factor/lu_solve 的分解复用、更多分解与条件数估计;scipy.sparse 与 scipy.sparse.linalg 才是稀疏世界(2.3 节的 CG、GMRES 都在这里)。选错模块不只是功能问题:对稀疏矩阵误用稠密接口会默默物化一个巨大稠密数组,内存当场爆掉。
另一个高频踩点:scipy.linalg.solve 的 assume_a 参数。对称正定矩阵声明 assume_a='pos' 后走 Cholesky 路线(2.1 节的减半成本),但声明错误不校验——把不定矩阵标成正定,得到错误结果且无警告。
四、现场四:随机数的可复现管理
import numpy as np # 旧式全局种子(遗留代码常见): np.random.seed(0) a = np.random.random(3) # 现代推荐:生成器对象,流独立、可传递 rng1 = np.random.default_rng(0) b = rng1.random(3) rng2 = np.random.default_rng(0) c = rng2.random(3) print(np.array_equal(b, c)) # True,种子决定整条流
可复现性纪律:每个模块/函数持有自己的生成器实例(通过参数传入),不要碰全局流——两个模块共享全局流时,调用顺序的改变会 silently 改变两者的随机数,蒙特卡罗结果随之漂移,排查极其困难。第五章的 MCMC、敏感性分析都要求显式的种子管理作为可复现前提。
图 6.1-1 数值工具链的隐性约定风险图谱
五、规避写法速查
| 隐性约定 | 症状 | 规避 |
|---|---|---|
| int64 溢出回绕 | 累积值突变负数 | 大数计数用 Python int 或 float;边界前显式转 dtype |
| 求和策略不一 | 两条路径小数位不同 | 仲裁用 math.fsum;对账代码统一入口 |
| assume_a 不校验 | 正定声明错但无警告 | 先特征值检查或 Cholesky 试解做体检 |
| 稀疏进稠密接口 | 内存暴涨 | 稀疏矩阵只进 scipy.sparse 系接口 |
| 全局随机流 | 改调用顺序结果漂移 | 生成器对象作参数传递,禁用全局 seed |
| 数组视图与拷贝 | 原数组被意外修改 | 明确用 copy 或写时注意 basic 切片是视图 |
💡 关键直觉:库的默认行为是为"典型场景"优化的,而数值 bug 恰恰发生在"非典型场景撞上默认行为"的缝隙里。写关键路径代码时,把每一步的 dtype、求和策略、随机流来源写进注释,是给未来的侦探(可能是三个月后的你自己)留下的物证标签。
本节要点回顾
- 整数回绕:NumPy 定长整数溢出无告警,计数类计算是重灾区
- 求和策略:np.sum 成对、朴素循环顺序、fsum 精确,三者可能不一致,fsum 仲裁
- 模块分工:numpy.linalg 核心、scipy.linalg 增强、sparse.linalg 稀疏,误用接口会内存爆炸
- assume_a 是承诺不是猜测:声明结构前先体检,错报无警告
- 随机流纪律:生成器对象显式传递,全局流是多模块代码的隐患
下一节把三道验证关卡在一维热传导案例上完整走一遍。