5.1 最短路径算法
5.1 最短路径算法
本节摘要:最短路径是网络优化的第一课,Dijkstra 算法以"每次敲定离起点最近的未定节点"的贪心策略在非负权图上保证最优。本节手写 Dijkstra 并解释其正确性不变量、失效边界(负权边)与工程化方向(优先队列、A* 启发式),最后用配送网络战例演示逐层扩展。
从一小时的送餐承诺说起
同城配送平台承诺"下单后 60 分钟送达",后台每一秒都在算:从商户到顾客,走哪条路最快?路网有几万个路口(节点)、几十万条路段(边),边的权重是实时预计通行时间。这个问题的规模吓人,结构却友好——非负权、单源、静态快照——恰好落在 Dijkstra 的舒适区。
1956 年荷兰计算机科学家迪杰斯特拉为演示 ARMAC 计算机的能力,二十分钟内在咖啡桌上想出了这个算法。它的策略极简:维护一张"已敲定最短距离"的名单,每轮从名单外挑出离起点最近的节点,敲定它,并尝试用它松弛邻居。贪心为什么对?关键不变量:在所有边权非负的前提下,一旦某节点是"未敲定集合"中最近的,它的距离不可能再被任何后续路径缩短——因为任何绕道都要先经过一个更远的节点,而非负权保证了绕路只会更远或持平。
手写 Dijkstra
import heapq def dijkstra(graph, source): """graph: {节点: [(邻居, 边权), ...]},返回距离表与前驱表""" dist = {source: 0.0} prev = {} done = set() heap = [(0.0, source)] while heap: d, u = heapq.heappop(heap) # 未敲定集合中最近的 if u in done: continue # 堆里的过期条目,跳过 done.add(u) for v, w in graph[u]: nd = d + w if nd < dist.get(v, float("inf")): # 松弛成功 dist[v] = nd prev[v] = u heapq.heappush(heap, (nd, v)) return dist, prev graph = { "仓库": [("路口A", 2.0), ("路口B", 5.0)], "路口A": [("路口B", 1.0), ("顾客C", 6.0)], "路口B": [("顾客C", 2.0)], "顾客C": [], } dist, prev = dijkstra(graph, "仓库") print("到顾客C最短用时:", dist["顾客C"]) # 5.0:仓库-A-B-C def trace(prev, target): path = [target] while path[-1] in prev: path.append(prev[path[-1]]) return path[::-1] print("路径:", " -> ".join(trace(prev, "顾客C")))
两处细节值得停一秒。其一,堆里允许同一节点多次出现(松弛一次压一个),弹出时用过期标记滤掉——这是优先队列版 Dijkstra 的标准卫生习惯,省去"堆内降键"操作。其二,前驱表 prev 是免费的路径记录器:从终点回溯即得完整路线,不必重算。复杂度 O((V+E)logV),几十万条边的路网毫秒级出解,这就是它七十年不退休的原因。
负权边:贪心的失效现场
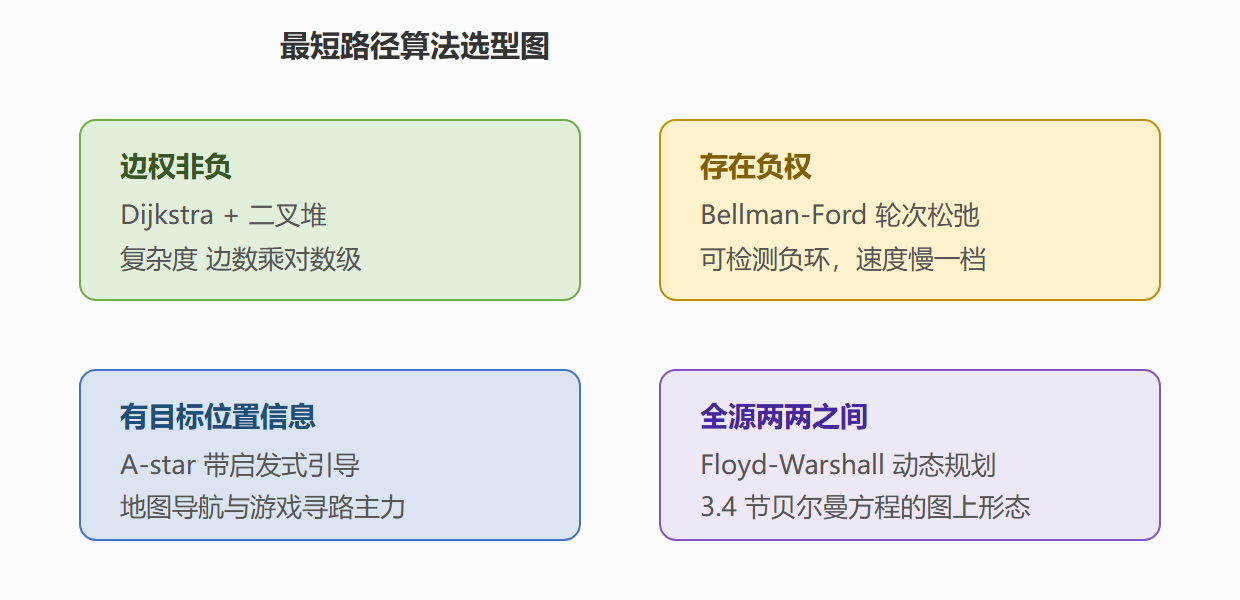
把某条边改成负数,不变量当场作废。构造一个小实验:A 到 B 边权 2,B 到 C 边权 −5,A 到 C 边权 1。Dijkstra 敲定 C(距离 1)后再也不会回头,但真实最短路径是 A→B→C 的 −3。负权边让"绕远路反而更快"成为可能,贪心的一次性敲定就此失守。此时换 Bellman-Ford:它不挑节点,老老实实把所有边松弛 V−1 轮,慢一个量级但能吃负权,还能顺带检测负环(第 V 轮仍在松弛即有负环——负环意味着"越走越赚",最短路不存在)。
def bellman_ford(edges, n, source): dist = [float("inf")] * n dist[source] = 0.0 for _ in range(n - 1): for u, v, w in edges: if dist[u] + w < dist[v]: dist[v] = dist[u] + w for u, v, w in edges: # 第 n 轮仍在改进 → 负环 if dist[u] + w < dist[v]: return dist, True return dist, False edges = [(0,1,2.0),(1,2,-5.0),(0,2,1.0)] print(bellman_ford(edges, 3, 0)) # ([0, 2, -3], False) 正确捕捉负权最优
两类算法的适用边界
工程化的三级跳
教科书版之上还有三级台阶。优先队列化(上面已做)把朴素 O(V²) 降到对数级;A* 搜索在 Dijkstra 的挑选规则里加一项"到目标的估计距离"启发式,让搜索像有指南针一样偏向目标方向——只要启发式不高估真实距离(可采纳性),最优性保持,搜索空间大幅缩小,这是游戏寻路与地图导航的实际主力;分层与双向搜索从两头同时向中间推进,在亿级节点的路网上再砍一个数量级。另外别忘了 Floyd-Warshall:它一次算出所有点对的最短路,本质是"经不经过中转点 k"的贝尔曼式递推,小规模稠密图上反而最省事。
⚠️ 常见坑:把实时路况的负相关修正塞进边权造成负值,然后继续用 Dijkstra。正确做法要么换 Bellman-Ford/Johnson 重加权,要么把模型改成"时间依赖的非负权"专门算法——负权不是数据错误,是算法契约的越界。
本节要点回顾
- Dijkstra 的正确性靠非负权:最近未定节点不可能被后续绕路超越;
- 过期堆条目 + 前驱表是工程实现的两处标配细节;
- 负权换 Bellman-Ford,附赠负环检测;全源问题用 Floyd-Warshall;
- A* = Dijkstra + 可采纳启发式,有位置信息时是首选;
- 算法选型看契约:边权符号、单源还是全源、有无目标信息,三个问题定方案。
单源最短路解决了"一对点"的问题。下一节升级到"一对多的流量":水管网络里,从源头到汇点最多能压过去多少水、瓶颈卡在哪一段。