6.1 纳什均衡与策略思维
6.1 纳什均衡与策略思维
本节摘要:博弈论研究"收益互相耦合的多主体决策",纳什均衡是无人愿意单方面偏离的稳定策略组合。本节用价格战囚徒困境演示均衡求解与矩阵划线法,展开混合策略的计算,说明为什么均衡可能是集体灾难、重复博弈如何部分救赎,以及占优策略与均衡的层级关系。
两家奶茶店的定价僵局
同街两家奶茶店各自决定定价:高价还是低价。若都高价,各赚 10;都低价,杀价伤敌一千自损八百,各赚 4;一家高价一家低价,低价者抢走市场赚 13,高价者只剩 1。写成收益矩阵(行是甲,列是乙):
| 乙高价 | 乙低价 | |
|---|---|---|
| 甲高价 | 10, 10 | 1, 13 |
| 甲低价 | 13, 1 | 4, 4 |
分析从"占优策略"入手:对甲来说,无论乙怎么选,低价都更赚(乙高价时 13 > 10,乙低价时 4 > 1)——低价是甲的占优策略。对称地,乙的占优策略也是低价。于是(低价,低价)成为唯一纳什均衡:给定对方低价,谁单独涨价谁吃亏。两家店在均衡处各赚 4,而双方都坚持高价本可各赚 10。这就是囚徒困境的结构:个体理性通过均衡机制制造了集体非理性。街头价格战、军备竞赛、公共渔场过度捕捞、内卷式加班,全是这一矩阵的换装演出。
求均衡的通用方法:最优反应
没有占优策略时,用"最优反应"逐格排查:对对手的每个策略,标出我方最优应对;双向标齐(双方互为最优反应)的格子就是纳什均衡。这个"划线法"可以直接代码化:
import numpy as np # 收益张量:payoff[a选择, b选择] = (甲收益, 乙收益) P = np.array([[(10, 10), (1, 13)], [(13, 1), (4, 4)]], dtype=float) A, B = P[:, :, 0], P[:, :, 1] def best_rows(M, axis): """对每列(或行)找最优反应的索引集合""" return [np.flatnonzero(M[:, j] == M[:, j].max()) for j in range(M.shape[1])] # 甲对乙各策略的最优反应;乙对甲各策略的最优反应 br_a = best_rows(A, 1) br_b = [np.flatnonzero(B[i, :] == B[i, :].max()) for i in range(B.shape[0])] eqs = [(i, j) for j in range(2) for i in br_a[j] if j in br_b[i]] print("纯策略纳什均衡:", eqs) # [(1, 1)] 即(低价, 低价)
有些博弈没有纯策略均衡——最著名的是猜硬币:甲乙各出正反面,相同甲赢、不同乙赢。任何确定性的选择都会被对手利用,唯一均衡是混合策略:双方各以 1/2 概率随机。混合策略的一般求法是让对手在自己两个选项之间无差异:设甲出正面的概率为 p,乙选正面与反面的期望收益相等时,乙才没有可乘之机,由此解出 p。
# 竞猜博弈:进攻方真假动作,防守方左右扑救 # 甲(攻)收益矩阵,甲选"真动作"概率 p 使乙左右无差异 # 乙左: 0.7p + 0.2(1-p);乙右: 0.3p + 0.8(1-p) p = (0.8 - 0.2) / ((0.7 - 0.3) + (0.8 - 0.2)) print(f"甲以 {p:.2f} 概率做真动作,乙无论扑哪边成功率都是 {0.7*p + 0.2*(1-p):.2f}")
混合策略的另一种读法更有味道:你的随机比例,是由对手的收益结构决定的——你要让对手猜不透,就要把对手逼到"怎么选都一样"的临界点上。点球射门、发球落点、虚晃与真突,竞技体育把它用到极致。
均衡的两种命运
均衡的局限与救赎
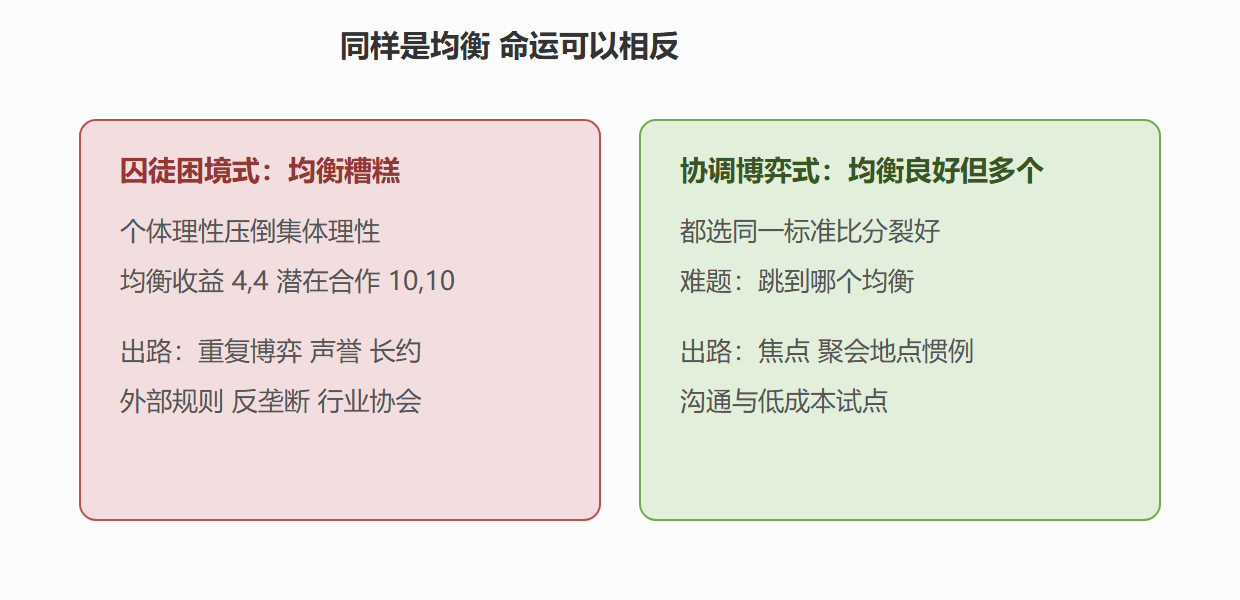
纳什均衡假设完全理性与共同知识,现实中人是有限理性的——行为博弈论的大量实验(比如最后通牒博弈里人们对不公平出价的拒绝)表明公平感、互惠、声誉都在修正冷酷的收益矩阵。工程视角的救赎更实在:困境的出路往往在博弈之外。把一次性博弈改成重复博弈(背叛会被未来的报复惩罚,合作成为可持续均衡——这是无名氏定理的内容);改变收益结构(行业自律公约、平台补贴、反垄断罚款都在改矩阵);引入承诺机制(公开宣布自动跟价的"最惠客户条款",把口头威胁变成可置信承诺)。看到困境,先问"能不能改矩阵、能不能改次数",这比劝各方高尚可靠得多。
💡 关键直觉:纳什均衡不是"最好的结果",是"最稳的结果"。分析博弈时先找均衡看清落点,再判断落点好不好——好的设法达成,坏的设法改写规则。这正是 6.2 节机制设计的入口。
重复博弈:时间如何松动困境
一次性囚徒困境里合作无解,但商业往来几乎都是重复的。把博弈重复多次,且双方都记得历史,策略空间立刻扩容——"以牙还牙"(先合作,对方背叛则下轮报复一轮)这类条件策略让合作有了牙齿:背叛的即时收益是三,但触发报复后每轮损失六,只要未来足够重要(折扣因子够大、关系够长),合作的现值就压倒背叛。这就是无名氏定理的通俗版:无限重复博弈里,一堆合作性的均衡都能站稳,困境松动了。现实对应物俯拾皆是:老街坊店铺不敢宰客(回头客的价值)、行业价格默契(报复性降价的威慑)、国际贸易的最惠国条款(把单次博弈制度化成重复博弈)。反过来,关系快结束时(店铺要拆迁、合同只剩最后一批交付),终局效应让背叛重新划算。看博弈先看它重复几次、未来折多少,这是策略思维的第二副眼镜。
最后补一个概念卫生:纳什均衡的存在性有条件——有限博弈在混合策略下必有均衡(纳什本人的定理),但纯策略均衡可能不存在(猜硬币就是例证);均衡还可能不唯一(协调博弈),此时选哪个均衡本身就是新问题,焦点、惯例与沟通都成了均衡选择机制。把这些边界条件记牢,你在使用均衡这个词时就能避开大多数误用。
本节要点回顾
- 纳什均衡 = 互为最优反应:任何一方单方面偏离都变差,才是稳定态;
- 占优策略是均衡的特例:不依赖对手行动的最优,划线法是通用排查手段;
- 混合策略让对手无差异:你的随机比例由对手的收益结构反解而出;
- 囚徒困境:个体理性汇成集体灾难,价格战、军备竞赛、公地悲剧同构;
- 出路在博弈之外:改次数(重复)、改矩阵(规则与奖惩)、改承诺(可置信威胁)。
均衡是给定规则后的落点。下一节反过来:先定目标,再设计规则,让自利的参与者自动走到设计者想要的位置。