8.1 最优控制与LQR线性二次调节器
8.1 最优控制与LQR线性二次调节器
本节摘要:最优控制把"想要的性能"写成一条可计算的代价泛函,再求使代价最小的控制律。线性系统配二次型代价(LQR)的最优解是线性状态反馈,增益由代数黎卡提方程解出。本节从离散 LQR 的动态规划推导入手,代码求解增益并与 PID 仿真对比,讨论 Q、R 权重的调参直觉与 LQG 组合。
把"调参数"变成"解方程"
第 7 章末尾的 PID 整定,本质是在参数空间里手工搜索。最优控制换一个问法:先把"好"定义清楚——代价函数 J = Σ(xᵀQx + uᵀRu),状态偏离的平方加权和(Q 加权)加控制能量的平方加权和(R 加权),然后直接求使 J 最小的控制律。Q 大意味着"状态偏差很疼",R 大意味着"动作很贵"。这个权衡的物理画面感极强: spacecraft 姿态修正里 R 大(燃料昂贵),机械臂快速定位里 Q 大(精度至上)。
一般最优控制的通用武器是庞特里亚金极小值原理(变分法路数,处理末端约束与控制约束的利器);而线性系统 + 二次代价 + 无限时间 horizon 的组合有一个礼物般的性质:最优控制律是线性的,u = −Kx,且 K 与初始状态无关——一次离线计算,终身在线使用。推导骨架就是 3.4 节的贝尔曼方程:值函数取二次型 V(x) = xᵀPx,代入离散贝尔曼方程后,P 要满足的就是(代数)黎卡提方程,K = (R + BᵀPB)⁻¹BᵀPA。
动手:解黎卡提方程
import numpy as np def dlqr(A, B, Q, R, max_iter=200, tol=1e-9): """离散时间 LQR:迭代求解代数黎卡提方程,返回增益K与P""" P = Q.copy() for _ in range(max_iter): K = np.linalg.solve(R + B.T @ P @ B, B.T @ P @ A) P_next = Q + A.T @ P @ A - A.T @ P @ B @ K if np.abs(P_next - P).max() < tol: break P = P_next K = np.linalg.solve(R + B.T @ P @ B, B.T @ P @ A) return K, P # 复用 7.1 的弹簧质量阻尼系统,采样 50ms m, c, k, dt = 1.0, 0.8, 4.0, 0.05 A = np.array([[1.0, dt], [-k/m*dt, 1 - c/m*dt]]) B = np.array([[0.0], [dt/m]]) Q = np.diag([10.0, 1.0]) # 位置偏差比速度偏差更疼 R = np.array([[0.1]]) # 控制能量便宜 K, P = dlqr(A, B, Q, R) print("最优增益 K =", np.round(K, 3)) eig = np.linalg.eigvals(A - B @ K) print("闭环特征值模:", np.round(np.abs(eig), 3), "→ 全小于1,闭环稳定")
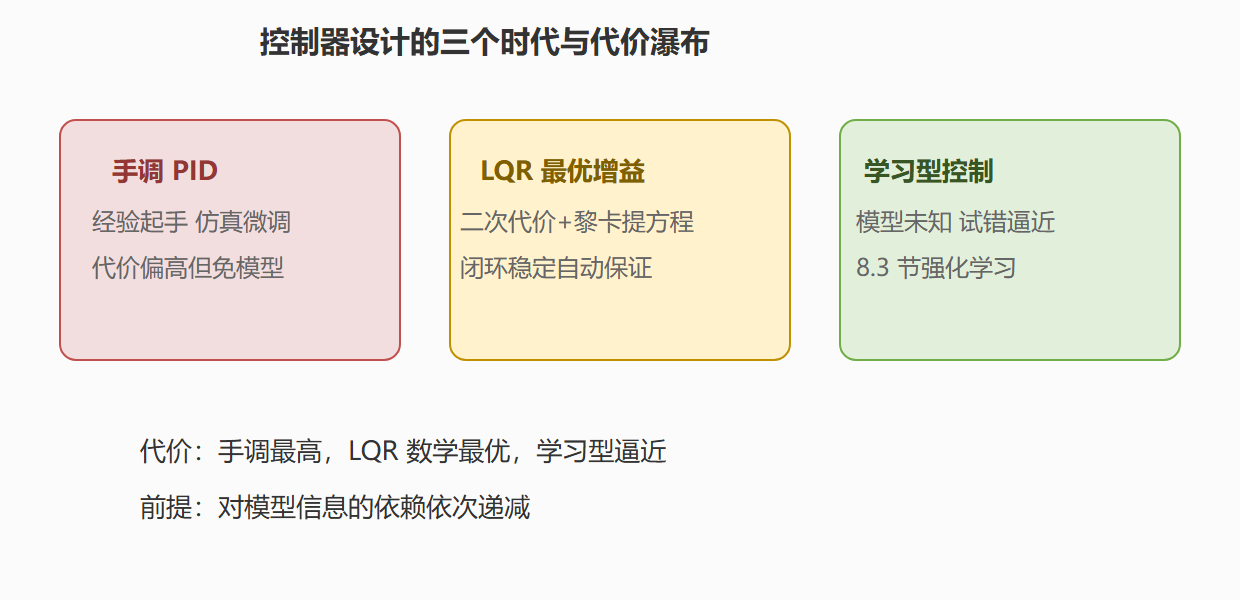
注意最后一步的"免费证书":闭环矩阵 A − BK 的特征值模全小于 1,LQR 自动保证闭环稳定(Q 正定的直接红利),不需要像 PID 那样担心增益大了震荡。再对比两种控制器的能量账单:
def closed_loop_sim(K_ctrl, T=6.0): x = np.array([1.0, 0.0]) # 初始位移 1m J = 0.0 for _ in range(int(T / dt)): u = -K_ctrl @ x J += x @ Q @ x + u * R[0, 0] * u x = A @ x + B.flatten() * u return J print(f"LQR 代价 {closed_loop_sim(K):.2f}") print(f"高增益PID 代价 {closed_loop_sim(np.array([[18.0, 4.0]])):.2f}")
同一初始状态下,任何其他(稳定线性)反馈的代价都不低于 LQR——这是"最优"的数学含义,不是修辞。
调 Q 与 R 的手艺
LQR 免去了增益整定,但把问题转化成了权重整定。工程直觉三条:先定 R 的量级(控制成本的现实标尺),再调 Q 对角元的相对比例(哪个状态分量更需要管);改 Q 某分量乘 10,通常对应状态收敛明显加快、控制量变大——沿对角线扫一遍是标准流程;Bryson 法则给了一个系统化起手式:每个权重取"最大允许偏差平方的倒数",即 1/x²_max,让各状态在代价里天然归一化。另外要记住 LQR 的适用边界:它优化的是无限时间二次代价,对非线性强的系统(大角度姿态、化学反应动力学)需要局部线性化或换非线性最优控制(第 3 章的打靶法、第 7 章的滑模都是邻居)。
从手工到最优的代价瀑布
从 LQR 到 LQG
LQR 假设全状态可测。现实中 7.1 讲过,输出只是状态的投影、且带噪声。卡尔曼滤波(下一节)提供最小方差的状态估计 x̂,用估计值代替真实状态喂给 LQR——u = −Kx̂——就得到 LQG 控制。分离定理保证了这种"估计器 + 调节器"拼接的最优性(在线性二次高斯设定下两步可以各自独立设计),这让工程流程极其清爽:一个团队做传感器融合,一个团队做最优增益,接口只有 x̂。
💡 关键直觉:LQR 的本质是"把工程偏好写成一条代价,让数学替你调增益"。调参没有消失,只是从"对着时域曲线拧旋钮"升级成"对着物理量纲定权重"——从手艺变成了可以写进设计文档的规范动作。
从极小值原理到贝尔曼:两条登山路
最优控制背后有两大方法论,值得在收尾处对望一眼。庞特里亚金极小值原理走变分法的路:把最优控制问题转成一组微分方程的两点边值问题(状态方程正向、协态方程反向、哈密顿函数极小化),擅长处理末端约束与控制受限,航天轨道转移的燃料最优解常由它导出。动态规划走贝尔曼的路:把时间切成小段、逆向递推值函数,适合离散与随机问题,也是下一节的主角。两条路在适当的正则条件下殊途同归——值函数对状态的梯度恰好就是协态变量,哈密顿函数就是贝尔曼方程里的那个最大化项。工程选型上,连续时间平滑问题偏向前者,离散随机与多阶段决策偏向后者。看懂这次对望的意义在于:第 3 章的优化、第 7 章的控制、本章的学习,在山顶上本来就是同一套数学。
本节要点回顾
- 代价函数即设计文档:Q 管状态偏差的疼度,R 管控制动作的贵度;
- LQR 的礼物:线性加二次的最优解仍是线性反馈,K 由黎卡提方程一次性解出;
- 闭环稳定是免费证书:Q 正定则 A − BK 稳定,无需担心增益震荡;
- 调参手艺在权重层:Bryson 法则起手,沿对角线扫描微调;
- LQG = LQR + 卡尔曼,分离定理允许估计与控制独立设计、以 x̂ 为接口拼接。
LQR 需要干净的全状态。下一节解决"状态藏在噪声投影后面"的问题——卡尔曼滤波是高斯世界里最优的那双眼睛。