8.3 从马尔可夫决策过程到强化学习
8.3 从马尔可夫决策过程到强化学习
本节摘要:马尔可夫决策过程(MDP)用状态、动作、转移、奖励四件套刻画序贯决策,贝尔曼最优方程给出最优值函数。本节在网格世界手写值迭代与 Q-learning,前者吃已知模型、后者只靠试错样本,对照两者揭示强化学习的本质——用采样数据逼近贝尔曼方程的解,并以探索与利用的权衡收尾。
罬最后一块地基
第 1 章埋的会师伏笔在此兑现。运筹学讲单步或多阶段的资源分配,控制论讲持续的反馈调节,两者在"序贯决策"处相遇:状态是局面的快照(库存水位或小车位置),动作是决策(补多少货或施加多大推力),转移是世界的回应规则(需求分布或牛顿定律),奖励是即时回报的量尺。这个四件套就是 MDP。马尔可夫性只有一个要求:给定当前状态与动作,未来与历史无关——局面本身就是未来的充分统计量。库存问题里"当前库存 + 在途量"构成状态时马尔可夫性成立;只记"今日库存"忘了在途,历史信息泄漏,模型就破了功。
最优性的表达式是贝尔曼最优方程(3.4 节的直系后代):V*(s) = max_a [ r(s,a) + γ Σ P(s'|s,a) V*(s') ]——局面的最优值等于"当下奖励加折扣后的下一局面最优值",对动作取最大。γ(折扣因子)是未来的汇率:γ=0.9 意味着十步之后的奖励只值今天的四成,它同时保证无穷级数收敛。
网格世界:值迭代吃模型,Q-learning 吃数据
造一个 4×4 网格:左上角是陷阱(奖励 −100,终止),右下角是出口(+10,终止),每走一步 −1(催促高效)。先看值迭代——模型已知(转移概率、奖励表都在手上)时的动态规划解法:
import numpy as np GRID, TERM = 4, {(0, 0): -100.0, (3, 3): 10.0} def step(s, a): if s in TERM: return s, TERM[s], True nxt = (max(0, min(3, s[0] + a[0])), max(0, min(3, s[1] + a[1]))) r = -1.0 if nxt in TERM: r = TERM[nxt] return nxt, r, nxt in TERM ACTIONS = [(-1, 0), (1, 0), (0, -1), (0, 1)] gamma = 0.95 def value_iteration(iters=200): V = np.zeros((4, 4)) for _ in range(iters): Vn = V.copy() for i in range(4): for j in range(4): if (i, j) in TERM: continue Vn[i, j] = max(step((i, j), a)[1] + gamma * V[step((i, j), a)[0]] for a in ACTIONS) V = Vn return V V = value_iteration() print("各状态最优值(陷阱邻域深负,出口邻域浅正):") print(np.round(V, 1))
值矩阵的形状本身就是地图:离出口越近值越高,陷阱把周围一圈拖入深谷——最优策略"看箭头走":每格挑 V 最大的邻居。
现在把模型抽走:智能体不知道转移规则、不知道奖励表,只能走走看。Q-learning 把值函数换成"状态-动作"对上的 Q 函数,用试错样本逐条修正估计:Q(s,a) ← Q(s,a) + α[ r + γ·max Q(s',·) − Q(s,a) ]。括号里的差值叫时序差分误差——"实际比预期好多少",α 是学习率:
def q_learning(episodes=800, eps=0.2, alpha=0.2, seed=0): rng = np.random.default_rng(seed) Q = np.zeros((4, 4, 4)) returns = [] for _ in range(episodes): s = (3, 0) # 固定起点 total, done = 0.0, False while not done: a = rng.integers(4) if rng.random() < eps else int(np.argmax(Q[s])) s2, r, done = step(s, ACTIONS[a]) Q[s + (a,)] += alpha * (r + gamma * (0 if done else Q[s2].max()) - Q[s + (a,)]) total += r s = s2 returns.append(total) return Q, np.array(returns) Q, rets = q_learning() print(f"前50局平均回报 {rets[:50].mean():.1f},后50局 {rets[-50:].mean():.1f}") print("学到的起点动作:", ["上", "下", "左", "右"][int(np.argmax(Q[(3, 0)]))])
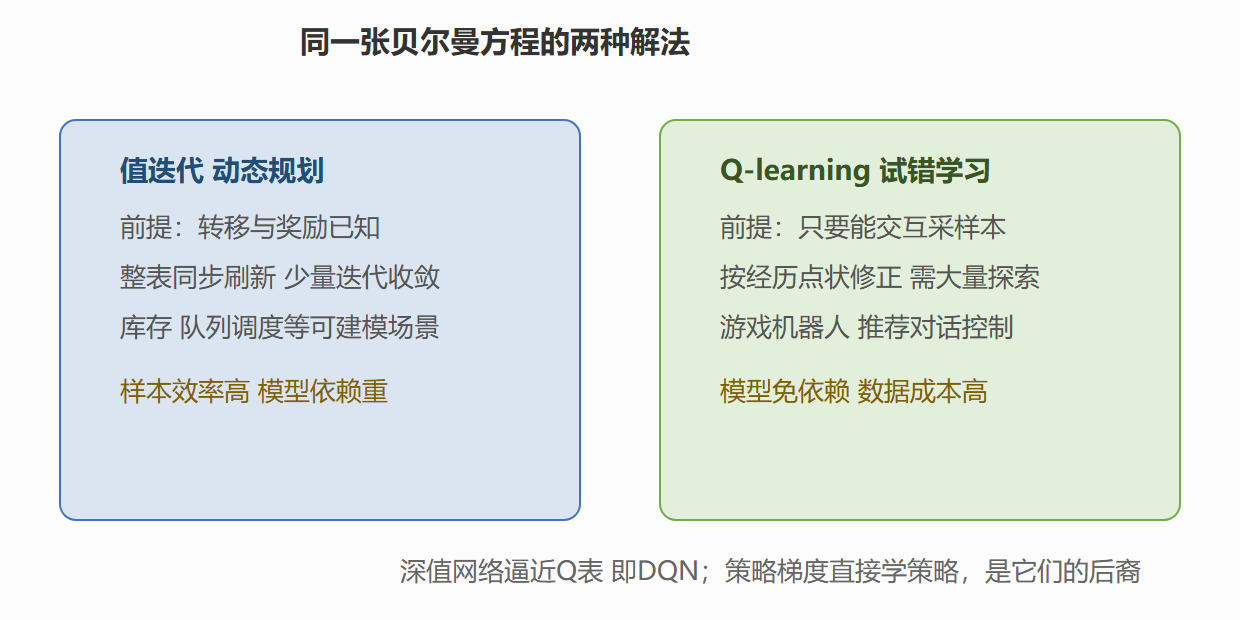
后段回报大幅抬升,说明策略从乱撞收敛到绕开陷阱直奔出口。对照两段代码能看到强化学习的全部秘密:值迭代用已知的转移概率直接刷新整张表;Q-learning 用实际走过的样本点状修正——当模型未知时,采样就是概率的替身。收敛的代价是数据量:值迭代 200 次扫描拿到精确解,Q-learning 要几百局试错才接近,这正是"模型信息换样本效率"的交易。
两种求解路线的分岔
探索与利用:ε 的分寸
Q-learning 里那个 eps=0.2 是探索率:两成动作故意随机。不探索,智能体会被早期偶然的好体验锁死在次优路线上(利用的陷阱);永远探索,策略永远掺着乱走(探索的税)。ε-贪婪的工程惯例是前期高(0.3 以上广撒网)、后期衰减(0.01 附近收敛);更深层的做法(UCB 按"没试够的程度"加成、汤普森采样按后验抽样)把探索做成学问。这个权衡在第 4 章的报童问题里早有雏形——补货本身就是"按已知最优订"还是"试探新量"的取舍,只是在 MDP 里它成了贯穿训练全程的一等公民。
从这张 4×4 网格到能下棋、能操控机械臂的智能体,中间的台阶是函数逼近:状态太多存不下 Q 表,就用神经网络当 Q 函数(DQN 的全貌),或直接参数化策略用梯度上升(策略梯度一族)。变的是函数容器,不变的是贝尔曼方程与时序差分误差这两块地基——它们正是本教程从 3.4 节一路铺到这里的路。
💡 关键直觉:强化学习不是新科学,是贝尔曼方程在"无模型、有数据"条件下的数值解法。看懂了值迭代与 Q-learning 的对照,就看懂了整个领域的主干。
本节要点回顾
- MDP 四件套:状态、动作、转移、奖励;马尔可夫性要求状态是未来的充分统计量;
- 贝尔曼最优方程是 3.4 节贝尔曼方程的最优化版本,γ 是未来的汇率;
- 值迭代吃模型、Q-learning 吃样本:整表刷新 vs 点状修正,模型信息换样本效率;
- 时序差分误差 = 实际减预期,是所有值函数类算法的共同引擎;
- 探索与利用的权衡由 ε 控制,先广后窄是惯例,也是报童问题的放大版;
- DQN 与策略梯度是容器升级,地基仍是贝尔曼与 TD 误差——全册两条主线的最终会师点。
最后一章把全册兵器装进同一个 Python 军械库,并用三个行业战例做总演习。