5.1 分子钟与选择检验
5.1 分子钟与选择检验
本节摘要:两条同源序列的差异里同时藏着"多久分开"与"受了多大选择"两条信息。前者用距离法读取:p 距离经 Jukes-Cantor 校正后除以速率即得分化时间;后者用 dN/dS 比值判读:同义替换作中性基线,非同义替换相对它的丰缺直接指示净化或正选择。本节实现这两个计算的最小纯 Python 版本。
从数差异开始:p 距离与它的失真
最原始的分子数据处理是逐位比对数差异:p = 差异数 / 比对长度。失真来自多重打击——同一个位点经历了两次替换(A→G→A)会被误判为零差异、(A→G→C)被误判为一次。差异越大、低估越重。Jukes-Cantor 1966 年给出校正:d = −3/4 · ln(1 − 4p/3)。p = 0.1 时 d ≈ 0.107,几乎不用校;p = 0.4 时 d ≈ 0.57,校正量翻了四成。这就是为什么远缘序列要换慢速演化的基因(或用氨基酸序列)来比——让 p 保持在校正可靠的区间。
演练一:p 距离与 Jukes-Cantor 校正
import math def p_distance(s1, s2): """逐位比较,跳过缺口位""" diffs = total = 0 for a, b in zip(s1, s2): if a != "-" and b != "-": total += 1 diffs += (a != b) return diffs / total def jc_distance(p): if p >= 0.75: return float("inf") # JC 校正的有效域边界 return -0.75 * math.log(1 - 4 * p / 3) s1 = "ATGCGTACGTTGACCGTACGTAGCTTAACCGGAT" s2 = "ATGCGTACGTCGATCGTACGTAGCTTAACCGGAT" p = p_distance(s1, s2) print(f"p = {p:.3f}, JC 校正距离 d = {jc_distance(p):.3f}") for pp in (0.05, 0.10, 0.20, 0.40, 0.60): print(f"p={pp:.2f} -> d={jc_distance(pp):.3f}")
末尾的循环打印一张"校正曲线":p 与 d 在低位几乎相等,越过 0.3 后迅速劈叉。分子钟的用法即:分化时间 t = d / (2r),r 为每 lineage 每百万年的替换率。 mitochondrial cytochrome b 的 r 约为每百万年 1% 量级,据此给鸟类、鱼类的分化事件断代,与化石独立吻合时,钟的可靠性就多一分背书。
dN/dS:在同一位点上让中性给自己当对照
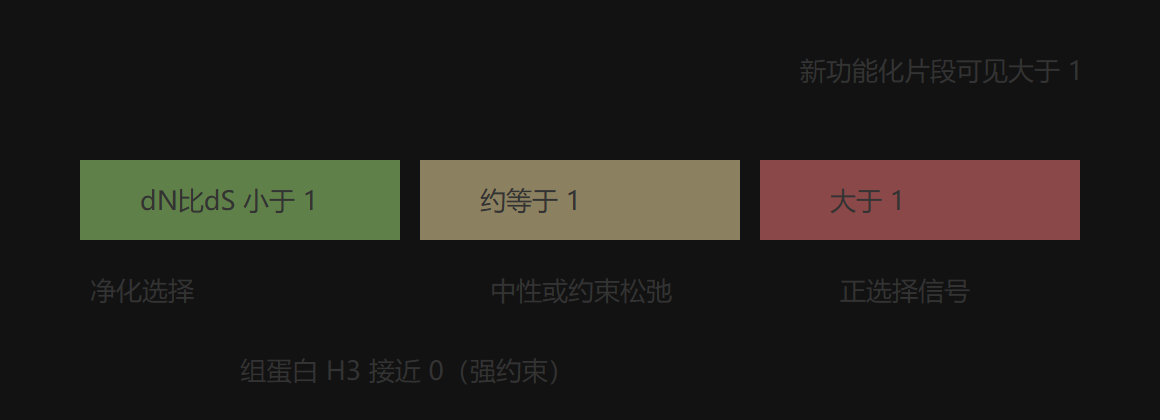
密码子有 64 个,同义替换(不改变氨基酸)大多被漂变处理,充当内建的中性基线。于是:
- dN/dS ≈ 1:非同义与同义一样快,中性或约束松弛
- dN/dS ≪ 1:非同义被清除——净化选择(基因组最常见的状态)
- dN/dS > 1:非同义被主动推广——正选择的分子签名
CODON_TABLE = { "ATT":"I","ATC":"I","ATA":"I","CTT":"L","CTC":"L","CTA":"L","CTG":"L", "GTT":"V","GTC":"V","GTA":"V","GTG":"V","TTT":"F","TTC":"F","TTA":"L", "TTG":"L","ATG":"M","GCT":"A","GCC":"A","GCA":"A","GCG":"A","TGT":"C", "TGC":"C","GGT":"G","GGC":"G","GGA":"G","GGG":"G","GAA":"E","GAG":"E", "GAT":"D","GAC":"D","AAT":"N","AAC":"N","TAT":"Y","TAC":"Y","TAA":"_", "TAG":"_","CAT":"H","CAC":"H","CAA":"Q","CAG":"Q","AAT":"N","AAA":"K", "AAG":"K","CCT":"P","CCC":"P","CCA":"P","CCG":"P","ACT":"T","ACC":"T", "ACA":"T","ACG":"T","TCT":"S","TCC":"S","TCA":"S","TCG":"S","AGT":"S", "AGC":"S","TGG":"W","TAA":"_","TGA":"_","ATG":"M","TTT":"F"} def count_ns_ds(cds1, cds2): """统计非同义位与同义位的差异(把每个差异归到 N 或 S 桶)""" n_diff = s_diff = n_sites = s_sites = 0 for i in range(0, min(len(cds1), len(cds2)) - 2, 3): c1, c2 = cds1[i:i+3], cds2[i:i+3] if "-" in c1 + c2 or len(c1) < 3 or len(c2) < 3: continue a1 = CODON_TABLE.get(c1); a2 = CODON_TABLE.get(c2) if a1 is None or a2 is None: continue ndiff = sum(x != y for x, y in zip(c1, c2)) if ndiff == 0: continue weight_syn = (a1 == a2) n_sites += 1; n_diff += 0 if weight_syn else ndiff s_sites += 0 if weight_syn else 0 s_sites += 1 if weight_syn else 0 s_diff += ndiff if weight_syn else 0 return n_diff, n_sites, s_diff, s_sites # 构造测试序列:一段偏同义漂变,一段偏非同义替换 cds_a = "ATGGCTAACTTGGAACCGTATGCCTAAGGACTTCAAC" cds_b = "ATGGCCAACTTTGAACCGTACGCCTAAGGATTTCAAT" nd, ns, sd, ss = count_ns_ds(cds_a, cds_b) dN = nd / max(ns, 1) dS = sd / max(ss, 1) print(f"非同义差异数 {nd}, 同义差异数 {sd}") print(f"粗略 dN/dS = {dN/max(dS,1e-9):.2f}")
真实的 dN/dS 还要按"每个密码子的潜在同义/非同义位点数"归一(Nei-Gojobori 法),上面是最简化的差异计数版,适合教学演示方向感。经典实证:溶菌酶在反刍动物前胃中的新功能化片段 dN/dS > 1;而组蛋白 H3 的 dN/dS 低到接近零——全基因组最严的净化选择之一,替"功能约束越强演化越慢"背书。
⚠️ 常见坑:拿全基因平均的 dN/dS 找正选择。正选择常只发生在几个位点、几个短暂时间窗,平均之后信号被稀释成"约等于 1"。实操要用分支-位点模型(如后续进阶工具)在特定谱系、特定位点上检验;本节的比值只是入门钥匙。
本节要点回顾
- p 距离在高分歧区严重低估,Jukes-Cantor 校正给出多打击修正
- 分子钟 = 校正距离 ÷ 速率,其理论根基是第 4 章的中性替换率
- dN/dS 三段判读:净化选择小于 1、中性约等于 1、正选择大于 1
- 同义位点是序列自带的对照 组,这一设计思想贯穿所有分子检验
下一节从序列升到基因组:大尺度事件如何改写进化的可能性空间。
图5-1 dN比dS 三段判读标尺