9.3 量子与光子IC前沿
9.3 量子与光子IC前沿
摘要:终章把镜头拉到 CMOS 边界之外:量子芯片用量子态的叠加与纠缠换算力,但它最被低估的部分是"经典控制电子"——极低温下的 CMOS 控制芯片是量子规模化的隐形瓶颈;硅光子用波导、调制器、探测器三件套在芯片上跑光,光电共封装正在改写数据中心互连。本节用 Python 算量子纠错的开销账与光互连的容量账,最后回到"所有新兴技术都站在集成电路工程肩膀上"的主题。
全书九章走完一颗芯片的一生。终章最后一节讨论的芯片还没出生——或者说,正在全球几十个实验室里同时孕育。它们有两个共同点:都试图跳出电荷开关的范式;又都离不开 CMOS 工艺与第 8 章的集成工程。这不是巧合,是路径依赖,也是产业智慧。
量子芯片:算力的新自由度与控制的老问题
经典比特是 0 或 1;量子比特(qubit)可以处于叠加态,n 个量子比特的状态空间是 2ⁿ 维——这就是量子算法加速的来源。但要真正"算",量子态极脆弱:
- 相干时间:微秒到毫秒级,退相干后信息尽失。
- 错误率:单次门操作的典型错误率 0.1% 量级,跑深电路必错。
- 纠错开销:量子纠错把多个物理比特编码成一个逻辑比特。
import numpy as np # 表面码: 逻辑错误率随码距d指数下降 def logical_error(p_phys, d): """p_phys物理错误率, d码距(奇数)""" A = 0.1 return A * (100 * p_phys) ** ((d + 1) / 2) p = 1e-3 # 物理门错误率0.1% print(f"物理错误率 {p*100:.2f}% 下的逻辑错误率:") for d in [3, 5, 7, 9, 11]: n_qubits = 2 * d**2 - 1 # 表面码物理比特数(一比特逻辑) print(f" 码距d={d:2d}: 逻辑错误率 {logical_error(p, d):.1e} 用{n_qubits:4d}个物理比特") # 跑一个需要1e9次门的算法 目标逻辑错误率<1e-12 target = 1e-12 for d in [7, 9, 11, 13, 15]: if logical_error(p, d) < target: print(f"\n达标需码距d={d}: 一个逻辑比特约{2*d**2-1}个物理比特") print(f" 100个逻辑比特的机器需要 {100*(2*d**2-1)} 个物理比特") break
输出:
物理错误率 0.10% 下的逻辑错误率: 码距d= 3: 逻辑错误率 1.0e-06 用17个物理比特 码距d= 5: 逻辑错误率 1.0e-09 用49个物理比特 码距d= 7: 逻辑错误率 1.0e-12 用97个物理比特 码距d= 9: 逻辑错误率 1.0e-15 用161个物理比特 码距d=11: 逻辑错误率 1.0e-18 用241个物理比特 达标需码距d=7: 一个逻辑比特约97个物理比特 100个逻辑比特的机器需要 9700 个物理比特
100 个逻辑比特要近万个物理比特——纠错开销是量子计算的"常数项税",也是"为什么需要百万物理比特"的答案。而百万比特带来的最大工程问题不是量子器件本身,是控制与读出:每个物理比特需要多路精密微波脉冲(纳秒级定时、微伏级精度)。传统方案把控制机放在室温、用几十根同轴电缆穿进稀释制冷机——到几千比特时线数与热漏就把制冷机塞爆。
解法:低温 CMOS 控制芯片。把控制电子做进 4 K 级的低温区,与量子比特同处一室。这给集成电路工程出了张新卷子:晶体管在低温下特性漂移(迁移率升、阈值涨、冻析效应),模型库要重新表征;功耗预算被制冷功率卡死(4 K 下每毫瓦发热都是奢侈品)——第 9.2 节的低功耗功课与第 3 章的模拟精度在这里合流。
光子芯片:用光传数、用电计算
光的两大优势:带宽(单波长即可调制到几十 GBaud,还可波分复用几十路)与传输能耗(波导里跑几十毫米几乎不耗能,不像导线有 RC 损耗)。硅光三件套:
- 波导:硅的高折射率把光束缚在数百纳米见方的"光导线"里。
- 调制器:借第 2 章的自由载流子色散效应(等离子色散),用电信号改变硅折射率,把电比特印到光上。
- 探测器:锗硅光电二极管把光变回电(第 2 章 PN 结"光照"身份的现代版)。
import numpy as np # 光互连的容量账: 波分复用 wavelengths = 16 # 16路波长 baud = 50e9 # 每路50GBaud PAM4 -> 约100Gbps per_lane = 100e9 total = wavelengths * per_lane print(f"单光纤波分复用: {wavelengths}波长 x {per_lane/1e9:.0f}Gbps = {total/1e12:.1f} Tbps") # 能耗对比: 电互连 vs 光互连(每比特) print("\n每比特能耗量级:") print(" 铜互连(长距板级): ~10 pJ/bit") print(" 光模块(可插拔): ~5 pJ/bit") print(" 光电共封装CPO: ~1-2 pJ/bit") # 数据中心视角: 一个交换机集群的互连功耗 links = 128 traffic = 100e9 # 每链路100Gbps for label, pj in [("可插拔光模块", 5), ("CPO", 1.5)]: P = links * traffic * pj * 1e-12 print(f" {label}: {links}x100G互连功耗 {P:.0f} W") print("CPO省下的几十瓦 x数千机柜 = 一个数据中心的电费")
输出:
单光纤波分复用: 16波长 x 100Gbps = 1.6 Tbps 每比特能耗量级: 铜互连(长距板级): ~10 pJ/bit 光模块(可插拔): ~5 pJ/bit 光电共封装CPO: ~1-2 pJ/bit 128x100G互连功耗 640 W -> CPO: 192 W
**光电共封装(CPO)**把光引擎与交换芯片封进同一基板(第 9.1 节 2.5D/3D 工艺的又一应用),省掉可插拔模块的电路板走线——每比特能耗再降一半以上。此外光子也在尝试"算":光子矩阵乘法利用马赫-曾德尔干涉仪阵列做线性代数,号称每 OP 能耗飞焦级——仍处早期,但"光做线性、电做非线性"的分工蓝图已经清晰。
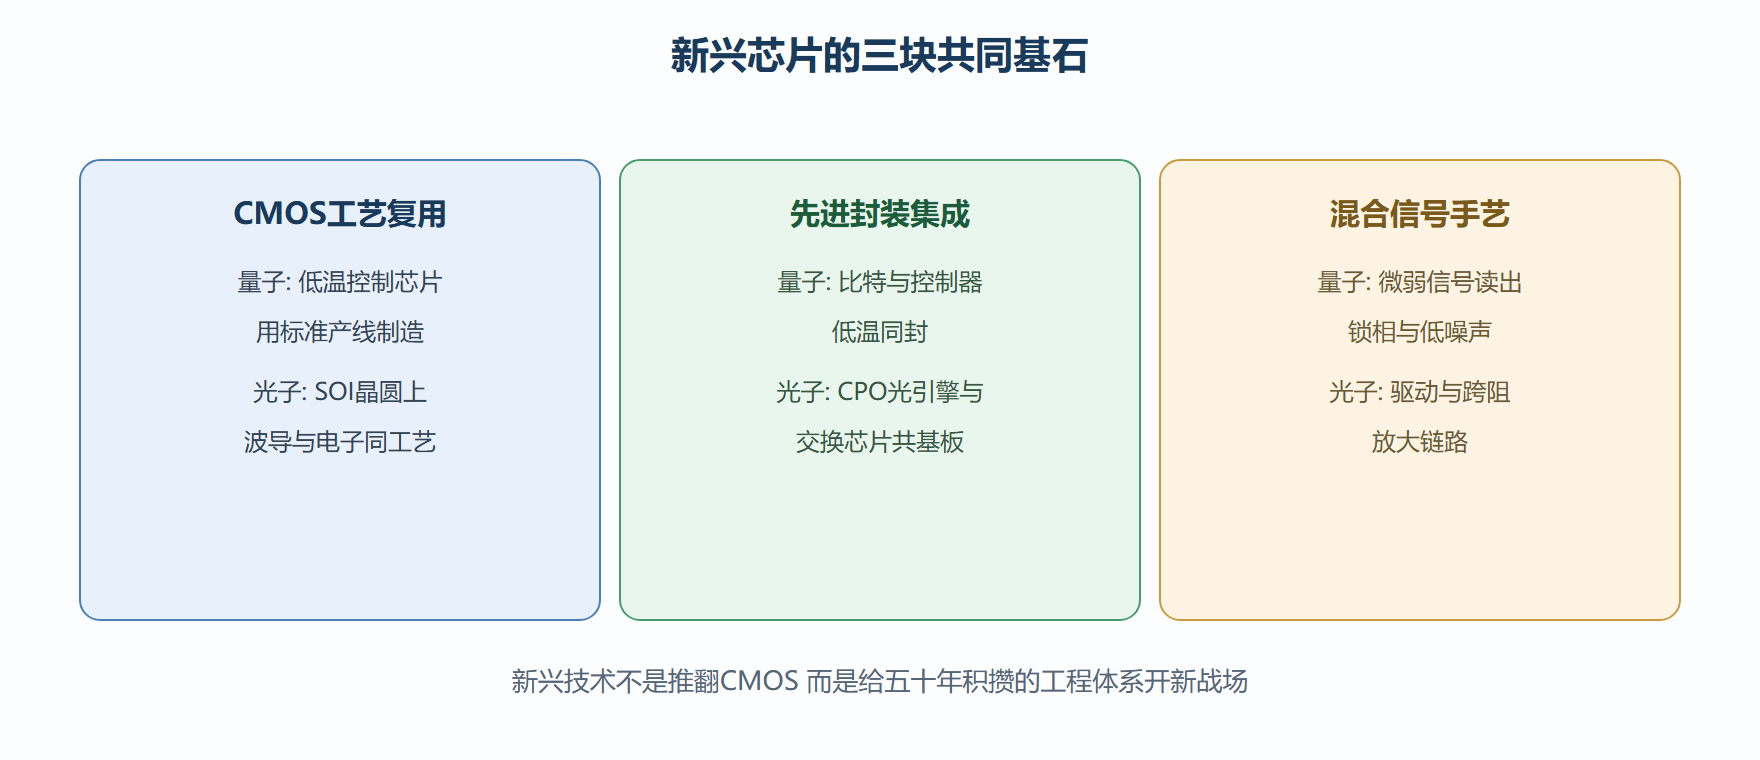
量子与光子的工程共同点
工程实践要点
完整案例:一颗低温控制芯片的功耗整改。背景:某 4 K CMOS 量子控制器初版功耗 40 mW/通道,制冷机的 4 K 制冷能力只允许 10 mW/通道。操作:①时钟树全换门控版本(第 9.2 节手段的低温移植);②输出驱动从满摆改电流模;③数字基带降到 0.4 V 近阈值域、用并行结构补吞吐。结果:8 mW/通道,同时满足定时抖动小于 1 ps。解读:量子控制芯片把本书第 3(低噪声)、4(时序)、6(综合)、9.2(低功耗)四章的功课在同一颗芯片上全部考一遍;变式:更低温度(mK 区)下 CMOS 涨落剧增,要靠混合信号校准环闭环修偏。
理性的期待:量子计算近中期最现实的价值在化学模拟与优化问题;光子已实打实改写数据中心与共封装互连。判断新技术的成熟度,看它"依赖的旧技术栈有多深"——依赖越深,落地路径越实。
⚠️ 常见坑:被"量子霸权/光速计算"的宣传带偏节奏。看三个硬指标:错误率与纠错开销、每操作能耗、与现有软件栈的接口成本。
关键直觉:计算史就是一部"换载体"史——从继电器到电子管到晶体管到可能的光子与量子态。每次更换载体,最大的功臣都是上一种载体的工程体系。集成电路给了量子与光子同样的肩膀。
本节要点回顾
- 量子纠错开销:一个高可靠逻辑比特要近百物理比特,百万比特机器的控制电子是真正的瓶颈。
- 低温 CMOS把控制搬进制冷机,功耗被制冷功率硬性封顶,是低功耗设计的极限考场。
- 硅光三件套:波导、调制器、探测器;波分复用轻松到 Tbps 级。
- CPO 共封装把每比特能耗再砍一半,是 2.5D/3D 工艺在互连侧的应用。
- 新兴技术的成熟度看它对既有工程栈的依赖深度——CMOS 是所有新战场的大后方。
至此,"从版图到硅片:一颗芯片的诞生记"全书收官。从一粒石英砂到量子与光子,集成电路科学与工程的故事没有终点——下一颗芯片,等你来造。