4.2 矛盾矩阵:从查号到翻译
4.2 矛盾矩阵:从查号到翻译
本节摘要:矛盾矩阵是 39×39 的经验检索表,行=改善参数,列=恶化参数,格内是历史上成功消解该矛盾的原理编号。本节讲矩阵的读法、查号后的翻译纪律,并实现一个内置真实矩阵片段的查询脚本,用它给飞边案卷和手持工具案卷各取一次弹。
读完这节你能做什么
阅读完本节,你应当能够:
- 说明矩阵格内编号的统计学来源与可信度边界
- 运行查询脚本完成"改善—恶化→编号"检索
- 执行查号后的"三问翻译"把编号变成工程动作
一、矩阵是什么:一张经验弹道表
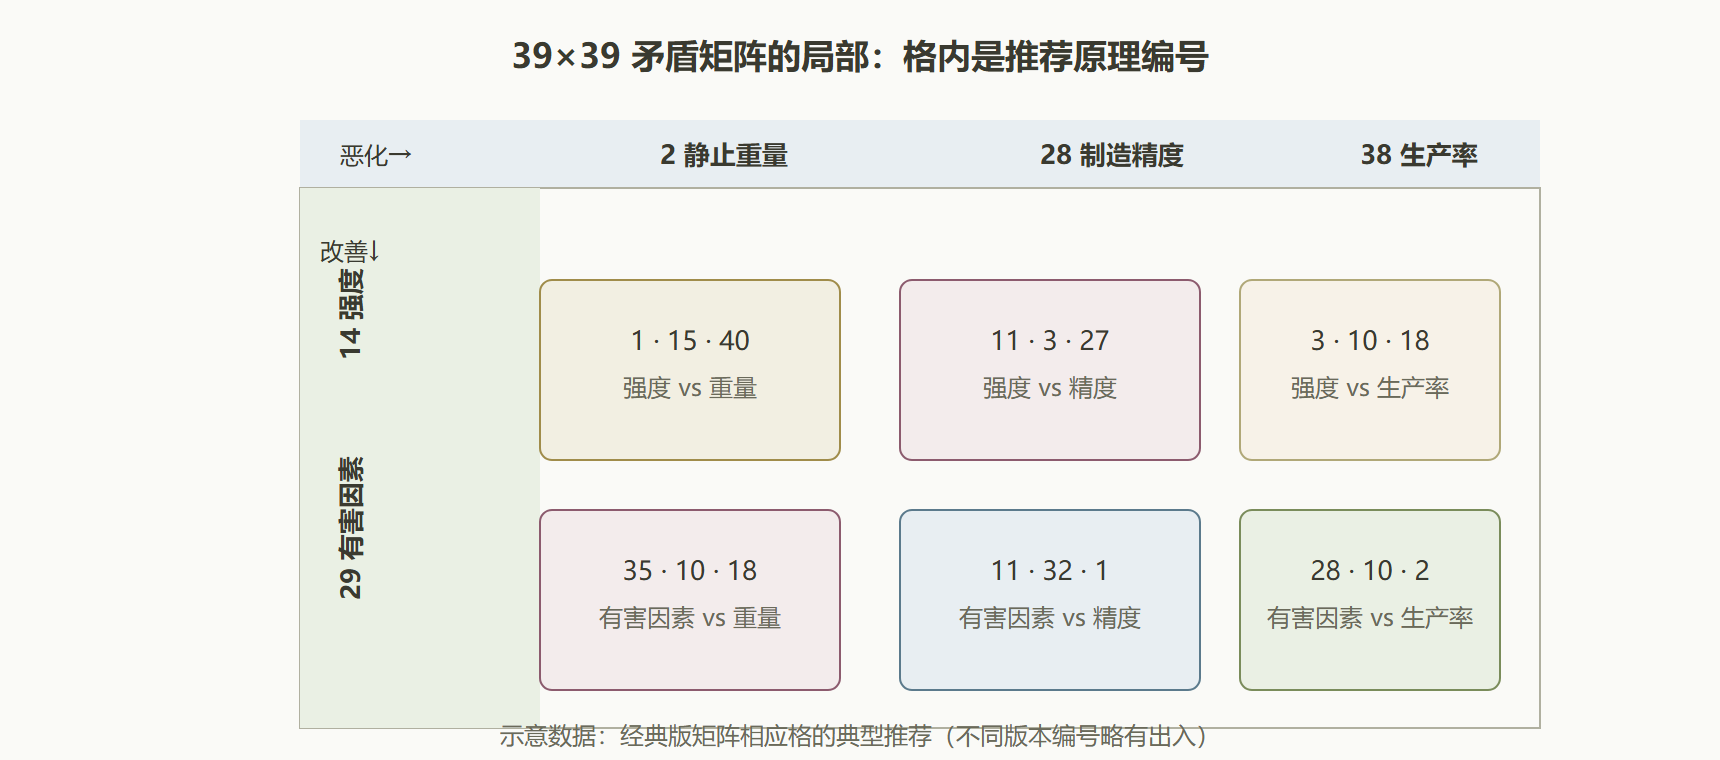
矩阵的每一格回答一个问题:"当某行业的人改善了参数 X 且因此恶化了参数 Y 时,他们用过哪些原理?"格内通常给 2–4 个编号,按出现频次与消解彻底度排序。要理解两点。其一,矩阵是统计产物不是逻辑产物——它来自对专利的人工归类,格子的稀疏不均(对角线空、某些行列密集)反映的是历史发明的分布,不是理论缺陷;2003 年后的商业化版本补充了更多格,经典 39×39 版仍有大片空格。其二,推荐不保真:编号是"值得先试的方向",命中率取决于问题转译质量(第 3 章)与翻译功夫(本节第三部分)。
读表操作本身很朴素:行=你想改善的参数,列=你不想恶化的参数,交叉格取编号,把每个编号带回 4.1 的家族说明书。容易搞错的是方向——写反行列会查到镜像矛盾,推荐原理质量明显下降。稳妥做法是行列各查一次,取两组并集,再靠 IFR 排序。
经典矩阵片段热力示意
二、查询脚本(内置真实片段)
全矩阵 1521 格太大,脚本里内置本教程案卷涉及的格,框架不变、随时可扩:
# 矛盾矩阵查询器(节选版,可扩展为全矩阵) MATRIX = { # (改善参数, 恶化参数): 推荐原理编号 (29, 28): [11, 32, 1], # 减少有害因素 vs 保制造精度 (29, 38): [28, 10, 2], # 减少有害因素 vs 保生产率 (29, 2): [35, 10, 18], # 减少有害因素 vs 不增重量 (14, 2): [1, 15, 40], # 提强度 vs 不增重 (9, 38): [35, 10, 28], # 提速度 vs 保生产率 } P = {1:"分割",2:"抽取",10:"预操作",11:"预先防范",15:"动态化", 18:"振动",28:"机械替代",32:"改变颜色",35:"参数变化",40:"复合材料"} def query(improve: int, worsen: int): key = (improve, worsen) if key not in MATRIX: return f"格({improve},{worsen})未收录:先查镜像或扩展矩阵" nos = MATRIX[key] return [f"原理{no} {P.get(no,'')}" for no in nos] print("飞边案卷 矛盾A:", query(29, 38)) # 改善29 vs 恶化38 print("飞边案卷 矛盾B:", query(29, 28)) # 改善29 vs 恶化28 print("手持工具案卷: ", query(29, 2)) # 改善29 vs 恶化2 print("镜像检查: ", query(38, 29))
输出:
飞边案卷 矛盾A: ['原理28 机械替代', '原理10 预操作', '原理2 抽取'] 飞边案卷 矛盾B: ['原理11 预先防范', '原理32 改变颜色', '原理1 分割'] 手持工具案卷: ['原理35 参数变化', '原理10 预操作', '原理18 振动'] 镜像检查: 格(38,29)未收录:先查镜像或扩展矩阵
三、查号之后:三问翻译
矩阵只完成"取弹","瞄准"靠三问翻译。以飞边案卷矛盾 A(改善 29 恶化 38,推荐 28 机械替代 / 10 预操作 / 2 抽取)为例:
- 第一问:原理作用于矛盾的哪一侧?——机械替代指向恶化的压力-锁模机构(用场的作用替代机械刚性),预操作指向熔体到达前的时间窗,抽取指向"间隙里的空气"这个被忽视对象。
- 第二问:手上哪个现成资源承载它?——预操作的资源是注射速度曲线(参数资源,小改可用):在熔体前锋到达分型面前降速一段、随即提速充满,等于把"排气时间"预操作出来,周期几乎不增。抽取的资源是模内空气:让排气槽只对气流开、对熔体闭(利用熔体黏度三个量级高于气体的差异),间隙"又要小又要大"的物理矛盾被条件分离顺手解决。
- 第三问:离 IFR 多远?——降速-提速曲线方案零新增、零延时,贴合"间隙自行按需大小";引入弹性模片方案要过 IFR 排序一关。
三问走完,编号从字典词变成了两张可上机试验的方案草图。这正回答了 1.2 节的旧问题:TRIZ 的效率不在"给答案",在把搜索从全域压缩到三个方向锥。
💡 关键直觉:矩阵查号后先别急着开会 brainstorm,先做三问翻译——多数情况下两问之内方案自现,brainstorm 留给确实卡壳的方向锥。
常见疑问
问:矩阵查出的编号都不适用怎么办? 三种可能按概率排序:参数选错(恶化侧没写真正痛的参数,回 2.2 节两问校准)、矛盾不是真矛盾(回 3.3 节筛子重筛)、查了镜像格(行列对调再查一次)。三种都排除后仍不适用,才考虑走标准解或效应库——这条排查顺序能解决绝大多数"矩阵不灵"的抱怨。问:2003 版矩阵和经典版差多少? 结构相同,主要差异是补充了经典版的空格并扩展了参数;先用经典版建立手感,切换是查表习惯的平移,不是重新学习。问:机器学习会取代这张表吗? 检索层已经可以自动化(商用软件都在做),但"翻译回工程语境"这步目前仍靠人——矩阵给出的是方向锥,锥内选点依赖工程约束的隐性知识。
本节要点回顾
- 要点一:矩阵是统计弹道表,格内编号=值得先试的方向;行列写反会查到低质量镜像。
- 要点二:查询脚本化后,镜像互查与全矩阵扩展都是一行改动的事。
- 要点三:三问翻译(作用哪侧、哪个资源承载、离 IFR 多远)是编号到方案的传送带。
- 要点四:飞边案卷经矩阵+翻译得到降速曲线与选择性排气两个零增量方向。
技术矛盾有矩阵,物理矛盾(间隙又要小又要大)呢?下一节的分离原理专攻这类"既要又要"。