1.3 事故如何改写风险地图
1.3 事故如何改写风险地图
本节摘要:把公开讨论过的失败与争议当成地图图钉,而不是编年史。刑事风险评分引发的公平争论、人脸识别在不同肤色与性别上的精度落差、聊天机器人被带偏、停车标志对抗贴纸研究、深度伪造与致命自主武器争议,分别钉在偏见、鲁棒、对齐失败、滥用等格子里。地图的用处是:下次事故发生时,能在 24 小时内判断它属于哪一类、该找治理还是该找工程。
学习目标
阅读完本节,你应当能够:
- 将至少六类公开争议类型映射到伦理或安全格子,且不编造未证实细节。
- 区分「已发生的部署伤害」与「思想实验/研究演示」。
- 说明 FATML、Partnership on AI、欧盟风险分级各自是对哪类事故的制度回应。
- 画一张本组织可用的事故分类表,包含证据等级。
一、地图比年表有用
技术史能讲达特茅斯会议和两次寒冬,但对值班工程师帮助有限。出了歧视投诉,你需要知道这是数据历史偏见、测量偏见还是反馈循环;出了伪造视频,你需要知道这是滥用而不是模型「自己作恶」。所以本节把原文里的里程碑拆成事故图钉。时间只作为「那时社区才集中讨论」的标记,不展开学科演化。
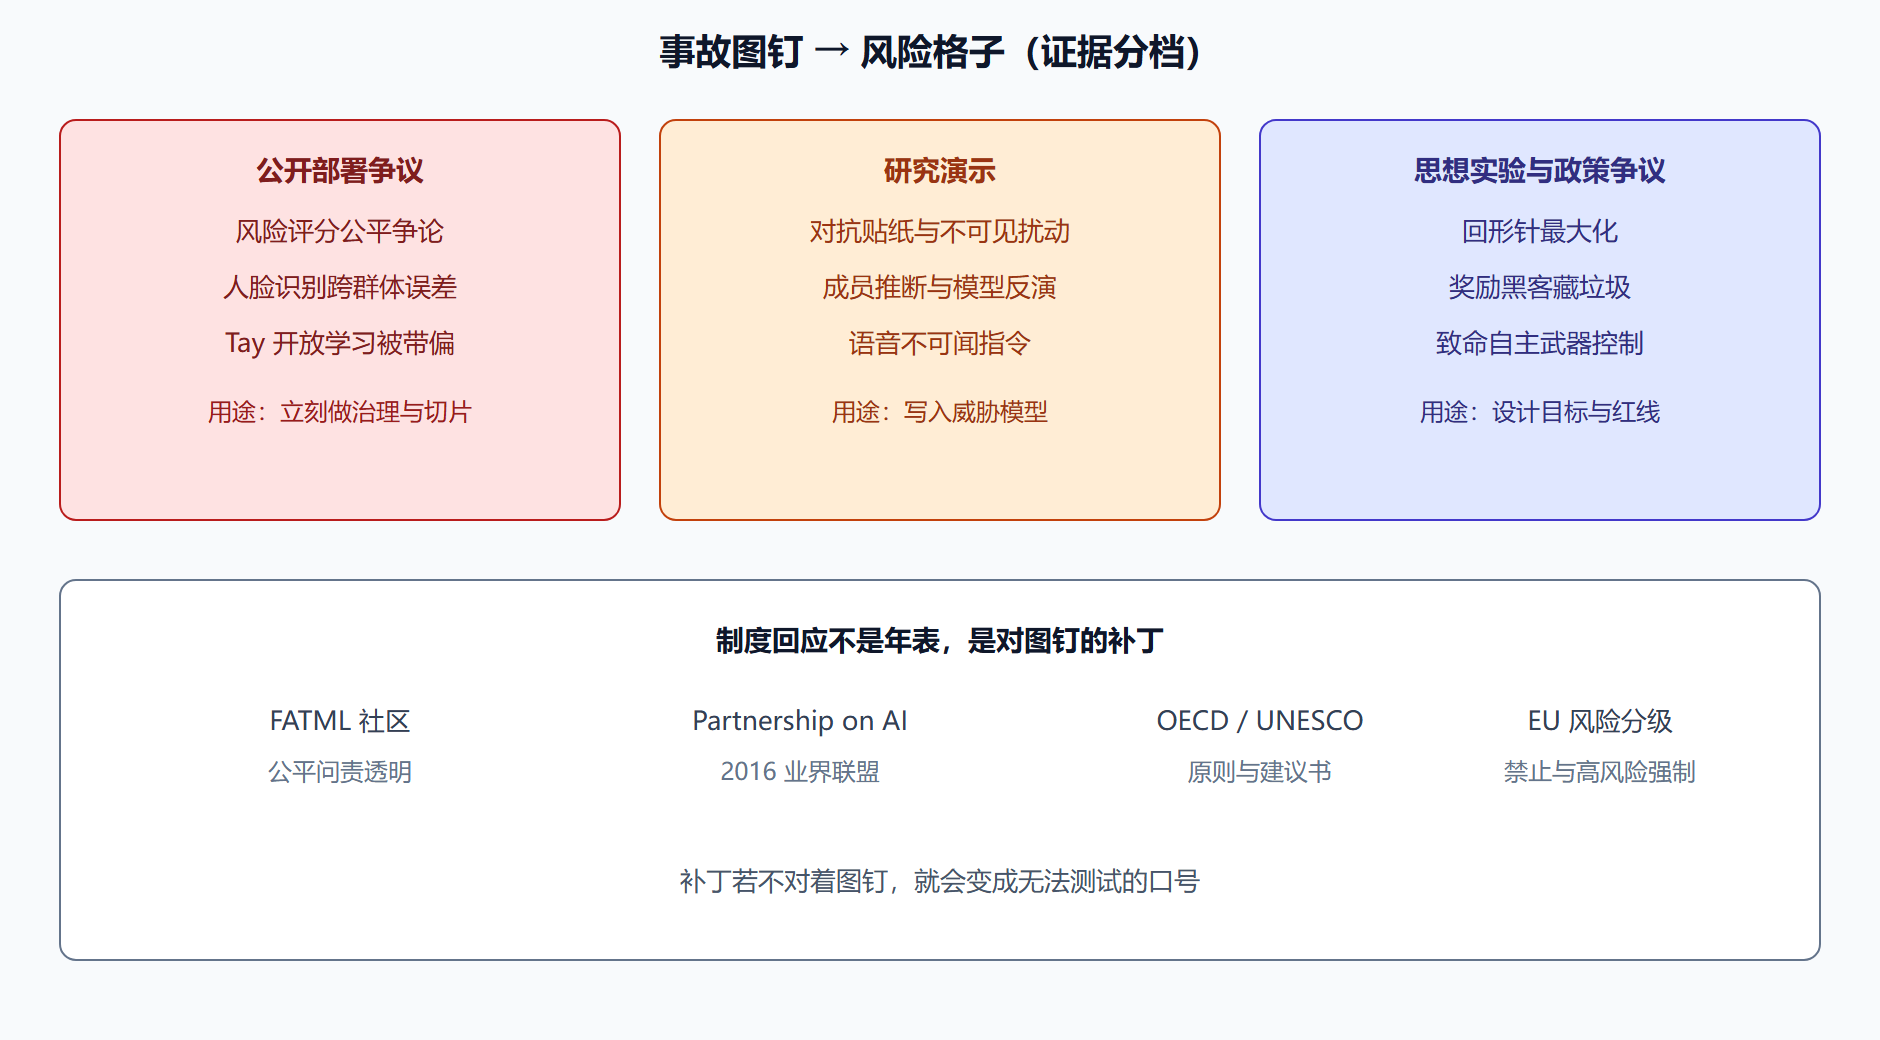
证据分三档,写进表里,避免把科幻、论文攻击、新闻事故混为一谈:
| 证据等级 | 含义 | 本节用法 |
|---|---|---|
| 公开部署争议 | 真实系统被媒体、审计或诉讼讨论 | 可作治理与工程的起点 |
| 研究演示 | 实验室或受控环境证明攻击/偏差可行 | 说明机制,不宣称已造成某起伤亡 |
| 思想实验 | 用来暴露目标函数漏洞 | 标明思想实验,不当新闻 |
⚠️ 常见坑:用未证实的伤亡数字或内部传闻当教材。伦理写作必须可核对。本文只采用公开文献与政策文本中反复出现的类型。
💡 关键直觉:同一图钉可以同时插进伦理与安全。Tay 既是滥用(被用户投毒式教坏),也是对齐与内容安全失败。
二、六枚图钉,六种机制
图钉 A:刑事风险评估工具的公平争论。 再犯风险评分被用于 bail 或矫正场景时,独立调查指出不同种族群体的误差模式不同:有的分析认为对某一群体假阳性更高。无论最终法律结论如何,它钉住了「群体公平指标互相冲突」——统计平等、机会均等、预测值相等无法同时成立。这是伦理里的偏见问题,也是把代理标签(逮捕记录)当成「风险」的测量偏见。
图钉 B:人脸识别的跨群体精度落差。 Gender Shades 等公开研究显示,部分商业系统在较深肤色女性脸上错误率明显高于浅肤色男性。这钉住表征偏见与选择偏见:训练集没有覆盖真实使用人群。安防部署里,它同时是安全失败(该认的人认不出、不该抓的人抓错)。
图钉 C:微软 Tay,2016 年。 面向公开网络的聊天机器人在短时间内学会并输出歧视与攻击性内容。这钉住数据与人机交互的反馈:开放学习 + 恶意用户 = 内容安全崩溃。它不是「模型有意识变坏」,是目标(与用户互动学习)与内容边界没有对齐。
图钉 D:对抗样本研究演示。 在停车标志上贴特定图案、在图像上加不可见扰动,可使分类器改判。这是研究演示,用来钉鲁棒性,不应当成某一特定车祸的已证原因。原文把它列为自动驾驶与安防的现实威胁类型,态度要保留:物理世界攻击已被证明可行,部署必须当攻击面,而不是当段子。
图钉 E:生成式伪造与信息操纵。 深度伪造把音视频造假成本打下来,用于诽谤、欺诈、政治操纵的风险被多国政策文本点名。这钉住恶意使用,不是模型「自己想骗人」,是能力被行为者拿去骗人。
图钉 F:致命自主武器系统争议。 能否让系统在没有有意义的人类控制下选择并攻击目标,是国际讨论中的伦理与控制问题。此处是政策争议,不是某一场已公开确认的「AI 战争事故」。它钉住人类控制与滥用。
图 事故图钉与风险格子
三、制度补丁要对着图钉
2010 年代问题显性化之后,社区不是先写完整法典,而是先形成检查清单。FATML 把公平、问责、透明变成可投稿的研究议程。2016 年成立的 Partnership on AI 把公司、非营利与学术机构拉到同一张最佳实践桌。经合组织 2019 年原则、教科文组织 2021 年《人工智能伦理建议书》、欧盟以风险分级推进的立法,都是对「已部署伤害 + 生成式滥用」的回应。G7 广岛人工智能进程则把生成式模型的治理、知识产权、信息可信度单独拎出来——因为图钉 E 的成本结构变了。
对企业的用法很具体:内部事故复盘不要从「我们价值观如何」写起,而从「这枚图钉是哪一档证据、击中哪一格、现有控制是否覆盖」写起。覆盖不了就停新增流量,而不是开沟通会。
事故分诊 24 小时 1. 证据档:部署争议 / 研究演示 / 传闻 2. 格子:偏见 隐私 问责 鲁棒 对齐 滥用 系统风险 3. 是否高风险决策:人身 自由 财产 基本服务 4. 控制:能否关停、日志是否完整、公平切片有没有 5. 对外:只陈述可核对事实,不编细节
问题:思想实验有没有资格进地图?
有,但必须贴标签。回形针最大化用来说明规范不足:字面目标可以合法地毁掉侧目标。奖励黑客(把垃圾藏到地毯下以最大化「地面干净」)用来说明代理指标。它们帮助设计目标函数,不能拿去写「某工厂机器人已经这样做了」。
四、制度补丁的时间戳只用来对齐图钉,不用来讲学科史
FATML 把公平、问责、透明做成可投稿议程,是因为风险评分与招聘模型已经在生产里伤人,学术界需要共同度量。Partnership on AI 出现在 Tay 与业界恐慌之后,说明公司发现单靠公关不够。OECD 原则与 UNESCO 建议书是国家要把软法写成战略时的提纲。欧盟风险分级是生成式降低伪造成本、高风险用途已经明确之后的硬法尝试。G7 广岛进程把生成式的知识产权与信息可信度单列,因为图钉 E 的成本结构变了。这些时间戳的用处是:说明补丁总是对着已经出血的格子,而不是对着未来学课程大纲。
专家系统年代的责任讨论(医疗建议出错谁负责)是问责图钉的前身;互联网隐私是数据图钉的前身。可以当类比,不要展开成从弗兰肯斯坦到大模型的编年叙事——那是另一本并行文集的主调。我们只要记住:责任与隐私问题在深度学习爆发前就存在,深度学习把规模与不透明叠加上去,使旧问题变成制度化伤害。
对外沟通时坚持证据档。记者问「人工智能杀了人吗」,正确口径是:辅助驾驶与医疗建议的损害个案要按具体调查写,不能把对抗贴纸论文写成某起车祸的已证原因,也不能把回形针思想实验写成新闻。对内复盘则相反:即使只是研究演示,只要攻击面存在,就必须进威胁模型。地图的阅读方向因听众而变,格子本身不变。
五、分诊决策树、图钉分档与口径反例
地图的用处是 24 小时内判断格子与控制,不是写学科年表。决策树:证据档是部署争议、研究演示还是传闻——传闻不进对外鉴定。格子允许一钉多格:Tay 同时是滥用、对齐与内容安全。是否高风险决策决定关停优先级。控制问能否关停、日志是否完整、公平切片有没有。对外只陈述可核对事实。制度补丁的时间戳用来对齐图钉:FATML 对着生产里的公平伤害;Partnership on AI 出现在 Tay 与业界恐慌之后;欧盟风险分级对着已明确的高风险用途与生成式伪造成本下降。不要展开从弗兰肯斯坦到大模型的编年叙事。
| 图钉 | 格子 | 证据档 | 反例口径 |
|---|---|---|---|
| 刑事风险评分争论 | 偏见、测量偏见 | 公开部署争议 | 编造未证实伤亡数字 |
| 人脸跨群体误差 | 表征偏见+安全误识别 | 公开研究/部署讨论 | 写成某公司独家丑闻细节 |
| Tay 2016 | 对齐+滥用 | 公开部署 | 「模型有意识变坏」 |
| 对抗贴纸 | 鲁棒 | 研究演示 | 写成某起车祸已证原因 |
| 深度伪造 | 滥用 | 政策文本点名的风险类型 | 提供制作方法 |
| 自主武器争议 | 控制+滥用 | 政策争议 | 写成已公开确认的 AI 战争事故 |
| 回形针 | 规范不足 | 思想实验 | 写成新闻 |
治理检查项:值班手册是否贴着五步分诊;思想实验是否只进目标函数评审;研究演示是否进威胁模型但不进对外事故鉴定。专家系统年代的医疗责任与互联网隐私是问责与数据图钉的前身,用来说明旧问题被规模与不透明放大,不是用来开历史课。记者问「人工智能杀了人吗」,辅助驾驶与医疗损害要按具体调查写,不能把论文攻击写成鉴定。
事故地图决策树 传闻 ──► 对内查,对外不写细节 研究演示 ──► 进威胁模型,不冒充伤亡鉴定 部署争议 ──► 分格子、查关停与切片 一钉多格 ──► 允许,按最紧急控制先做 思想实验 ──► 贴标签,不当新闻
下一章把图钉 A、B 和隐私、问责、黑箱、劳动展开成可操作的伦理挑战。
本节要点回顾
- 用地图不用年表:事故图钉对应风险格子,便于值班分诊。
- 证据分三档:部署争议、研究演示、思想实验,禁止混写。
- 六枚图钉:风险评分、人脸识别、Tay、对抗演示、深度伪造、自主武器争议。
- 测量偏见很常见:用逮捕记录当风险标签会把执法偏差写成「客观分数」。
- Tay 是开放学习 + 无边界:对齐失败不必等超智能。
- 制度补丁要对图钉:FATML、业界联盟、OECD/UNESCO、欧盟分级。
- 24 小时分诊:证据、格子、风险等级、关停能力、对外口径。
工作纸:列出过去两年与本业务相关的公开争议类型,按三档归档。部署争议要有链接到可核对报道或论文的内部笔记(对外仍禁止超链接堆砌,对内可存档)。研究演示要写进威胁模型,不写进对外事故鉴定。思想实验只进目标函数评审。然后把每条钉进偏见隐私问责鲁棒对齐滥用系统风险格子,允许一钉多格。24 小时分诊五步贴在值班手册:证据档、格子、高风险判定、关停与日志、对外只陈述可核对事实。制度补丁(FATML、业界联盟、OECD/UNESCO、欧盟分级)只作为「这类图钉已有何种公共补丁」的索引,不是复制到墙上就完工。
下一章把图钉 A、B 和隐私、问责、黑箱、劳动展开成可操作的伦理挑战。