5.3 公平性检测与缓解
5.3 公平性检测与缓解
本节摘要:公平工程把第 2.1 节的定义变成切片报表与干预。检测要覆盖历史、表征、测量、抽样与反馈循环。度量在统计平等、机会均等、均衡赔率等之间按场景单主指标。缓解分预处理、训练中公平约束或对抗性去偏、后处理调阈值。不可能同时满足所有定义,因此文档必须写清选择与残留风险。代理变量扫描与持续监控比「训练时跑一次脚本」更重要。
学习目标
阅读完本节,你应当能够:
- 搭建按敏感属性切片的错误率与选择率报表。
- 为信贷或招聘选择主公平指标并论证。
- 判断三阶段干预哪一段适合当前约束。
- 把反馈循环检测写进再训练门禁。
一、先测,再谈去偏神话
没有切片,去偏是盲目的。最低报表:各组样本量、选择率、真阳性率、假阳性率、校准曲线。样本量过小要标明置信不足,不能用「已公平」一笔勾销。测量偏见要单独查:标签是否在用逮捕、点击、投诉这些被权力扭曲的代理。原文 5.3 把来源与 2.1 对齐,工程上要在数据说明书里逐条勾。
二、干预阶段怎么选
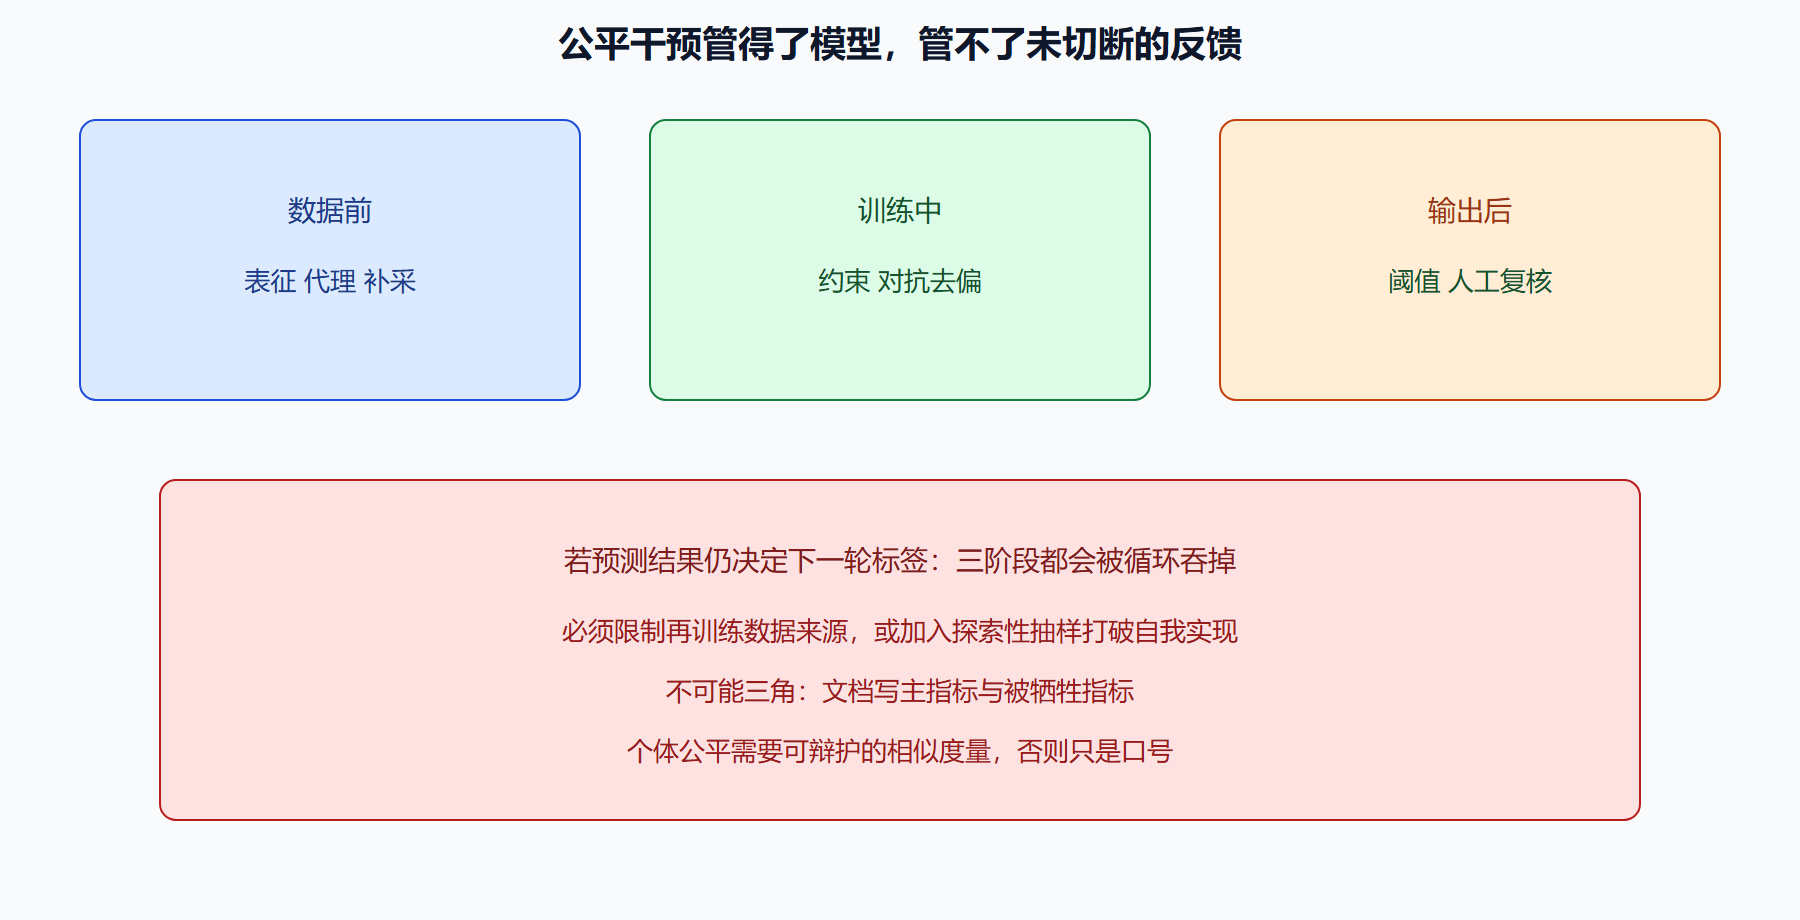
预处理:重采样、重加权、抑制代理、主动补采。适合还能动数据时。训练中:把公平差加进损失,或对抗性去偏让输出难被敏感属性分类器猜中。适合有训练权且能量化主指标。后处理:分组阈值,适合模型已冻、只需止血。后处理不改变内部表示,分布一切换可能失效,故只能当过渡。
| 阶段 | 典型动作 | 何时不要用 |
|---|---|---|
| 预处理 | 补采少数、去代理 | 标签本身系统性错 |
| 训练中 | 公平正则、对抗去偏 | 无法定义敏感属性或非法处理该属性时需法务 |
| 后处理 | 调阈值、校准 | 当永久方案;或组内仍极不公 |
| 流程 | 人工复核拒绝尾部 | 复核负荷不可及时 |
敏感属性的使用本身受法律约束。有的法域限制直接用种族训练,但仍要求结果公平——于是要用合法的评估协议与间接估计,这必须由法务参与,工程师不要自行发明「影子种族推断」去优化指标,那会制造新的隐私与伦理事故。
⚠️ 常见坑:优化了一个公平指标,其他指标崩溃却不上报。发布包应含主指标与对照指标全家福。
💡 关键直觉:公平测试集要与训练隔离,并含部署将面对的群体。用训练分布「证明公平」是循环论证。
图 三阶段止血与残留
fairness_gate: for g in slices: log tpr fpr selection calibration n if any n too_small: flag_low_confidence if primary_metric < floor: block if retraining_uses_own_decisions: require_loop_review
对抗性去偏不能消灭通过邮编、姓名拼写进来的信息。要配合代理扫描:哪些特征能预测敏感属性,它们对决策贡献多大。贡献过大就进入特征治理,而不是再加大对抗损失假装看不见。
问题:没有敏感属性怎么做公平?
可用投诉、地理代理、用户自愿填写的评估通道,或独立审计抽样标注。完全没有切片就不要宣称公平。高风险系统应在合法前提下建设评估用敏感标签,与训练标签隔离。
四、仪表板、可视化与「没有敏感属性」时怎么办
原文把公平工具功能写成仪表板、偏见可视化、敏感属性识别、指标计算库。仪表板若不能按部署人群下钻,就只是全局平均的另一种画法。可视化要能显示代理变量如何预测敏感属性、以及对决策的贡献。差异化影响等指标与统计平等、机会均等一起看,防止只优化一个。公平测试集与训练隔离,并含部署将面对的群体。
没有敏感属性时,可用投诉、地理、自愿评估通道或独立审计抽样标注。完全没有切片就不要宣称公平。高风险系统应在合法前提下建设评估用敏感标签,与训练标签隔离。工程师不要自行发明影子种族推断去刷分,那是新的隐私与伦理事故。法务必须参与「能否在评估中处理该属性」。后处理调阈值在模型已冻时止血,分布一切换可能失效,故要设失效复审。个体公平的相似度量必须可辩护。反馈循环检测是再训练门禁:用自己的决策当下一轮标签,必须先审查。
发布包含主指标与对照指标全家福。优化了一个、隐瞒崩溃的其他指标,等于没有公平工程。样本量过小要标明置信不足。这些纪律比再引入一个新的去偏算法更重要。
五、指标选择决策树、伤害分档与干预反例
主指标按伤害类型选,不要按「哪条最好看」选。招聘与信贷:优先机会均等(有资格者被选中的比例接近),同时上报统计平等以免配额幻觉,校准看预测值是否各组可信。刑事风险与福利停发:假阳性伤害不可逆,均衡赔率或分组假阳性上限往往更贴现场;必须写明用逮捕等代理标签时的测量偏见残留。医疗筛查:假阴性(漏诊)优先,按皮肤类型、性别、年龄切片灵敏度,地板高于营销推荐。内容分发:看投诉与曝光是否在群体间系统性偏离,并切断「越推越极端」的回流。标签与敏感属性在历史上相关时,不可能三角会发作——文档必须写主指标、被牺牲指标、人工复核覆盖哪些拒绝。
| 伤害档 | 现场 | 主指标倾向 | 干预寿命 |
|---|---|---|---|
| 档I 机会关闭 | 招聘、信贷 | 机会均等为主 | 能动机时预处理+训练中 |
| 档II 惩罚过重 | 司法、福利、风控拒绝 | 控制假阳性差 | 后处理可止血,须设复审日 |
| 档III 漏检伤身 | 医疗、安防漏报 | 分组灵敏度地板 | 补采表征不足,禁只调阈值 |
| 档IV 回流焊死 | 预测性警务、推荐 | 探索抽样或冻结再训 | 任何去偏之前先断回流 |
治理检查项:评估用敏感标签与训练隔离、法务是否签字;代理扫描哪些特征能预测敏感属性、贡献过大是否进入特征治理;再训练是否使用本模型昨日决策;样本量过小是否标明置信不足;发布包是否含主指标与对照指标全家福。反例:删掉性别列截图存档当「已公平」;优化统计平等导致合格候选人被配额误伤却不上报机会均等崩溃;工程师自行做影子种族推断刷分,制造新的隐私事故;后处理阈值当永久补丁,分布一切换就失效;仪表板只有全局平均,不能按部署人群下钻。
公平门禁决策树 无切片 ──► 禁止宣称公平 有回流 ──► 先冻结或探索抽样,再谈去偏 标签是逮捕或点击 ──► 先记测量偏见,再选指标 模型已冻且事故在发生 ──► 后处理止血并写复审日 能动机且主指标可微 ──► 训练中约束或对抗去偏,配合代理扫描
下一节处理对抗与恶意扰动下的工程强化,与 3.1 的威胁模型对接。
六、招聘、信贷、医疗三套地板,以及回流切断怎么验收
招聘:禁止用姓名、照片、毕业年份当捷径;复核必须抽拒绝样本,不能只抽通过者。主指标用机会均等,对照上报统计平等。历史成功员工画像若被当成个体公平的距离,驳回相似性定义。信贷:代理变量扫描邮编、设备、消费品类;机会均等优先,配额式统计平等可能掩盖组内不公。医疗:表征不足表现为皮肤类型与性别上的灵敏度差,假阴性地板高于营销;只调后处理阈值不补采,视为未治疗表征偏见。三套地板写进同一张发布表,禁止各业务线私自换主指标还不报对照。
回流切断的验收不是口头「我们会注意」。再训练数据清单必须能回答:是否包含本模型昨日决策;若是,探索性抽样比例或冻结令写在哪。预测性警务与推荐极化形态不同、治理相同。对抗性去偏之后仍要扫代理:判别器猜不准敏感属性,不等于邮编不再编码阶层。法务参与评估用敏感标签协议,工程师禁止自建影子推断刷分。发布包含主指标、对照指标、样本量、置信不足标记。缺一项,公平闸阻断。
没有敏感属性时,可用投诉、地理、自愿评估通道或独立审计抽样,但完全没有切片就不要宣称公平。仪表板必须能按部署人群下钻,全局平均的另一种画法不算检测。后处理设复审日,分布切换触发重评。这些纪律比再引入一个新去偏算法更值钱。
再训练门禁验收问三句:昨日决策有没有进入今日标签;探索抽样比例写在哪;代理扫描贡献过大的特征有没有进入治理。三句答不全,去偏实验不得称为已上线控制。评估用敏感标签与训练隔离的法务签字放进发布包。没有签字就没有公平宣称。
主指标按伤害选:机会关闭用机会均等,惩罚过重控假阳性差,漏诊控灵敏度。对照指标必须同包上报。后处理写复审日,过期未审视为未治愈。影子敏感属性推断刷分列为事故而不是技巧。没有切片,公平二字不准出现在发布说明。
没有切片报表,公平二字不准写进发布说明。
本节要点回顾
- 先切片再干预:样本量不足要标明。
- 主指标按场景选:全家福对照上报。
- 三阶段各有寿命:后处理是止血不是治愈。
- 反馈循环必须单独闸:否则去偏被数据吞回。
- 不要非法推断敏感属性去刷分:会制造新伤害。
- 评估集隔离:防止循环论证。
- 代理扫描:对抗去偏的必要伴侣。
工作纸:主指标与对照指标全家福。评估用敏感标签是否与训练隔离、法务是否签字。代理扫描结果。反馈循环是否阻断再训练。后处理是否被误当永久方案。没有敏感属性时的评估通道。样本量不足是否标明。禁止影子推断刷分。仪表板能否按部署人群下钻。公平测试集是否含真实部署群体。把「去掉敏感列」从完成项改为未开始,除非代理扫描已做。
下一节处理对抗与恶意扰动下的工程强化,与 3.1 的威胁模型对接。