1.2 虚拟内存与物理内存:账本背后的银行
1.2 虚拟内存与物理内存:账本背后的银行
本节摘要:程序里写下的地址全是虚拟地址,操作系统与 MMU 负责把它翻译成物理地址;new 登记的只是虚拟账目,真正的物理内存要等数据真正写入(触页)时才兑现。理解这层"银行系统"才能解释分配快、写入慢、涨内存与占内存是三回事等日常现象。
上一节把变量分到了五本账上,但你打印出的那些地址(无论是 0x55 开头还是 0x7f 开头)都不是内存条上的真实位置——它们是虚拟地址。虚拟内存系统就是账本背后的银行:每个进程都拿到一套从零开始的私有账本,银行在背后决定哪笔账对应哪块真实的存储。本节承接区域划分,向下补齐这层机制;它是第 6 章谈分配器与缓存性能的前置知识。
学习目标
- 说出虚拟地址到物理地址的翻译路径,以及页(page)在其中的角色;
- 解释"登记账目"与"兑现物理内存"两步为什么分开,以及缺页在其中的作用;
- 复现并解读"分配 256 MiB 很快、逐页写入却慢"的实验;
- 用这套机制解释 commit、RSS、swap 三个监控指标的区别。
一、银行为什么要隔在中间
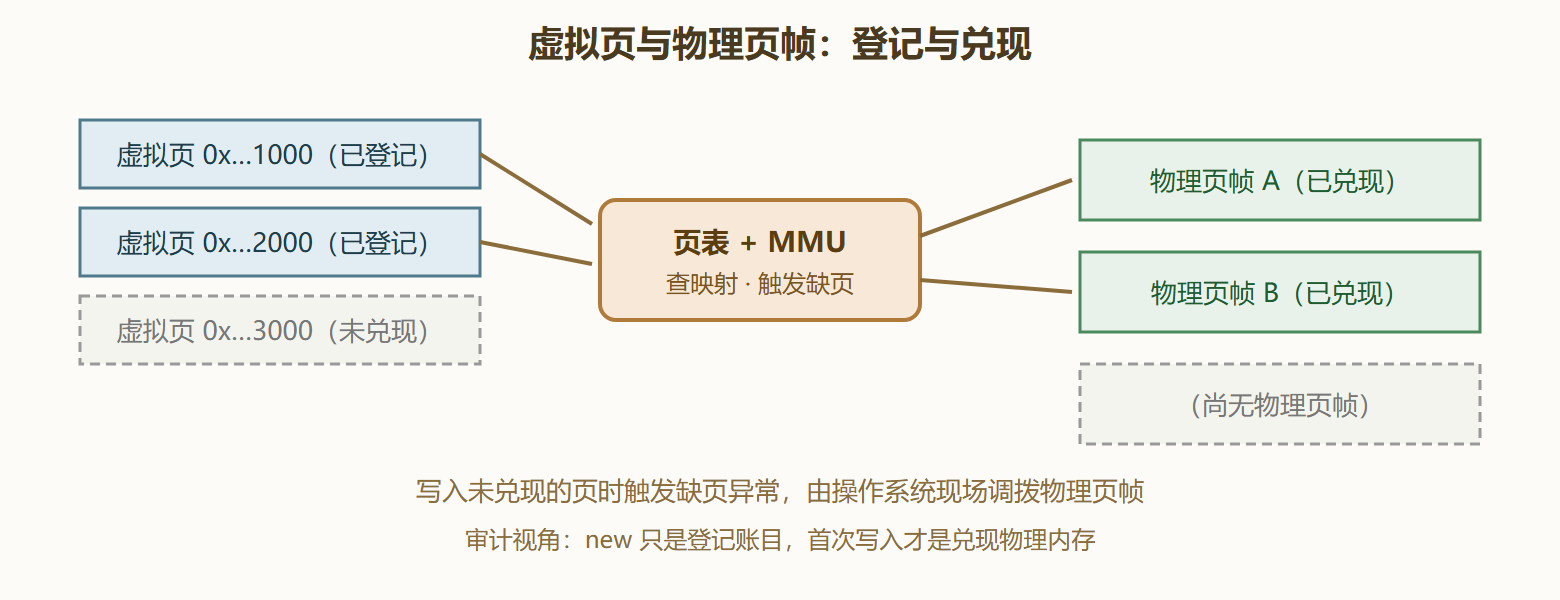
如果程序直接用物理地址,会立刻撞上三堵墙:地址冲突(两个进程都想用同一段地址)、隔离缺失(一个进程能踩别人的内存)、碎片利用(物理内存东一块西一块凑不出连续空间)。虚拟内存把这三堵墙一次拆掉:每个进程活在自己的地址空间里,CPU 访问内存时由 MMU 查页表完成翻译,翻译不到就触发缺页异常交给操作系统处理。
翻译以页为单位,常见页大小 4 KiB。进程的虚拟地址空间被切成等大的页,物理内存被切成等大的页帧,页表记录"虚拟页 → 物理页帧"的映射。关键在于:映射可以暂时不存在。new 一块大内存时,操作系统只在虚拟账本上登记区间,并不立刻找物理页帧;等你第一次写入某个页,缺页异常触发,银行才现场调拨一个物理页帧挂上去。这就是"登记"与"兑现"的分离。
图 1-2 虚拟地址到物理地址的翻译路径
二、实验:登记快,兑现慢
一张图不如一次实验。下面这段程序先申请 256 MiB,再逐页触碰,两步分别计时:
#include <chrono> #include <cstdio> int main() { constexpr std::size_t kPageSize = 4096; // 常见页大小 constexpr std::size_t kPages = 64 * 1024; // 64K 页 = 256 MiB const std::size_t total = kPages * kPageSize; auto t0 = std::chrono::steady_clock::now(); auto* buf = new char[total]; // 只登记虚拟账目 auto t1 = std::chrono::steady_clock::now(); for (std::size_t i = 0; i < total; i += kPageSize) buf[i] = 1; // 逐页触碰,触发缺页兑现 auto t2 = std::chrono::steady_clock::now(); auto ms = [](auto a, auto b) { return std::chrono::duration_cast<std::chrono::milliseconds>(b - a).count(); }; std::printf("登记 %zu MiB 用时 %lld 毫秒\n", total >> 20, static_cast<long long>(ms(t0, t1))); std::printf("逐页兑现 %zu 页 用时 %lld 毫秒\n", kPages, static_cast<long long>(ms(t1, t2))); delete[] buf; return 0; }
一台普通 Linux 上的典型输出(数值随机器而异,现象本身稳定):
登记 256 MiB 用时 0 毫秒 逐页兑现 65536 页 用时 87 毫秒
解读:登记一步快到计时器都懒得走,兑现一步实打实花了近百毫秒——差额就是六万多次缺页处理的代价。这正是"程序申请 1 GiB 内存"与"程序占用 1 GiB 物理内存"不是一回事的根源:账目挂上了,物理银行还没放款。
背景:某行情服务启动时要一块大缓冲做预计算,上线后发现启动慢。操作:把缓冲的逐页初始化从"用到才做"改成启动时批量做,并把这两步计时分开打点。结果:登记那一步的耗时可忽略,瓶颈全部落在逐页兑现上,批量化后启动耗时反而下降——因为集中触页让内核的调拨路径更友好。解读:监控里的内存数字要先问清量的是哪本账:虚拟账目(登记)、commit(承诺兑现)、RSS(实际兑现的物理页)是三个不同的口径。变式:如果只想占着地址不占物理内存(预留给极端场景用),就登记而不触碰;反过来想预热,就在上线脚本里主动逐页写一遍。
三、审计视角下的三个日常现象
现象一:delete 之后物理内存不一定立刻还回去。 销账只是解除虚拟映射、把内存还给分配器,物理页帧未必马上被回收,RSS 回落经常滞后。看到"free 了 RSS 不降"先别喊泄漏,这多半是银行在等合适的时机整理账目。
现象二:两次申请常拿到同一批地址。 把上一节的缓冲 delete 后再 new 一块同大小的,打印两个指针,主流分配器会给出相同的地址——账目销了,账页还在分配器手里,下一笔同额开户直接翻旧账页。这也解释了为什么"内存清零"不能靠眼睛:复用的页里全是上一户的残留数据。
#include <cstdio> int main() { auto* p = new char[1024 * 1024]; std::printf("第 1 次开户 %p\n", reinterpret_cast<void*>(p)); delete[] p; auto* q = new char[1024 * 1024]; std::printf("第 2 次开户 %p\n", reinterpret_cast<void*>(q)); // 主流实现会复用账页 delete[] q; return 0; }
典型输出(主流 64 位实现下两行地址相同;标准不保证,属实现细节):
第 1 次开户 0x55c9a3de7010 第 2 次开户 0x55c9a3de7010
现象三:swap 是银行的风险缓释。 物理页帧紧张时,操作系统把冷页换出到磁盘,账本上的虚拟地址不变,只是兑现点挪到了磁盘。程序突然访问被换出的页,缺页处理就慢上几个数量级——这就是"内存吃满后程序整体变卡"的机制根源,也是压测时监控 swap 使用率的原因。
| 口径 | 量的是什么 | 对应账本动作 |
|---|---|---|
| 虚拟登记 | 地址区间挂账 | new 完成的部分 |
| commit | 承诺可兑现的总额 | 登记加部分预调拨 |
| RSS | 已兑现的物理页帧 | 逐页触碰后的结果 |
⚠️ 常见坑:把"申请了多少"当成"占用了多少"去做容量规划,会同时犯两类错——高估虚拟登记(以为要加内存了,其实只登记未兑现),或低估 RSS(以为登记小就安全,结果触页高峰把物理内存打穿)。容量问题永远看 RSS 加 swap 口径。
本节要点回顾
- 两层地址:程序只见虚拟地址,MMU 查页表翻译成物理地址,页是翻译单位(常见 4 KiB)。
- 登记与兑现分离:new 只登记虚拟账目,首次写入触发缺页才兑现物理页帧。
- 分配快写入慢:大块申请近乎零成本,逐页触碰才产生真实开销,实验可复现。
- 三个口径:虚拟登记、commit、RSS 对应账本动作的不同阶段,容量规划看 RSS。
- 地址复用:销账后的账页常被下一笔同额开户复用,残留数据不会自动清零。
- swap 机制:冷页换出到磁盘,虚拟账目不变,兑现点挪位,换来的是总容量、付出的是访问延迟。
下一节回到堆账本的柜面:把 new 与 delete 拆成一道道可观察的工序,看清开户登记与对象构造是怎么分工的——坏账审计的全部抓手都在这套流程里。