5.3 原子操作与内存序:免锁记账的规则
5.3 原子操作与内存序:免锁记账的规则
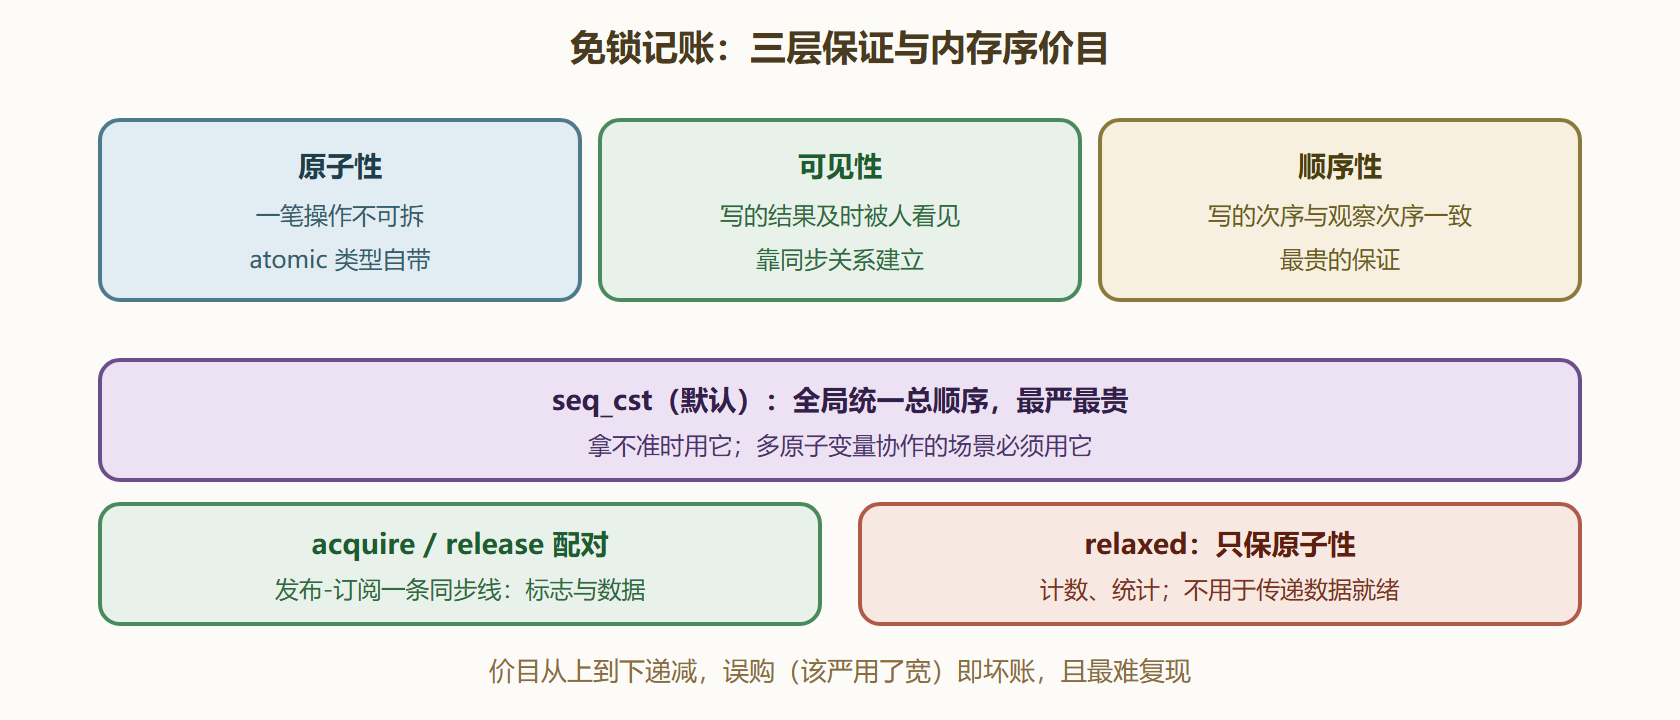
本节摘要:std::atomic 把单笔读改写变成硬件级不可拆操作,免掉锁的等待;但免锁记账有三层保证要分别核算——原子性(一笔不丢)、可见性(写被人看见)、顺序性(次序与观察一致)。内存序(seq_cst、acquire-release、relaxed)是按需购买这些保证的价目表:从严到宽,价格递减,误购即坏账。
锁制度立好了,代价也摆在明面上:高频小账目(计数器、标志位)每次进出门的开销可能超过记账本身。本节下到底层:原子操作让单笔账不打断、不排队,而它真正的难点不在原子性,在内存序——为"别人什么时候看见我的写"定价。这是本章也是全册技术最深的一站,掌握它的分层理解法就能化繁为简。
先看一笔账
原子计数器修复 5.1 的丢账,注意这次没有门、没有等待:
#include <cstdio> #include <thread> #include <atomic> std::atomic<long> counter{0}; // 账本本身自带原子性 void deposit_many(int times) { for (int i = 0; i < times; ++i) { counter.fetch_add(1, std::memory_order_relaxed); // 单笔原子加,无锁 } } int main() { std::thread t1(deposit_many, 100000); std::thread t2(deposit_many, 100000); t1.join(); t2.join(); std::printf("期望 200000,实际 %ld —— 原子加一笔不丢\n", counter.load()); return 0; }
输出确定:
期望 200000,实际 200000 —— 原子加一笔不丢
fetch_add 在主流平台上编译为一条原子加指令(x86 上是 lock 前缀指令),硬件保证读改写不可拆,两位柜员的三步再无交错可言。这里用了最宽松的 relaxed 内存序——因为计数场景只要原子性,不需要任何"谁先谁后"的顺序承诺,钱花在刀刃上。
但 relaxed 有严格边界。看一笔它做不了的账:数据就绪通知。线程 A 准备好数据后置标志,线程 B 等标志再去读数据——两者之间必须建立"数据写入发生在标志、标志发生在数据读取"的先后关系:
#include <atomic> #include <cstdio> #include <string> #include <thread> std::string payload; // 普通变量:数据账 std::atomic<bool> ready{false}; // 标志账 void producer() { payload = "审计底稿已生成"; // 第一步:写数据 ready.store(true, std::memory_order_release); // 第二步:发布标志 } void consumer() { while (!ready.load(std::memory_order_acquire)) { // 等标志(acquire 接收) } std::printf("收到:%s\n", payload.c_str()); // 保证看见完整数据 } int main() { std::thread p(producer), c(consumer); p.join(); c.join(); return 0; }
输出确定:
收到:审计底稿已生成
release-acquire 是一对配对凭证:release 写向上保证"本线程此前的所有写,都先于这次标志写入对 acquire 方可见";acquire 读向下保证"看到标志后,后续读拿到的是发布前的完整账目"。两方配对,一条"先写后见"的同步线就画成了。若这里改用 relaxed,标志照样能传到,但 payload 的写入没有任何顺序承诺——consumer 可能打印出空串或半截数据,且这种坏账在测试机上可能永远不复现。
图 5-2 三层保证与内存序价目表
一、三个免锁构件与适用边界
构件一:原子计数器(relaxed)。统计、限流、指标——只要"总数不丢",不要"次序"。构件二:发布标志(release 写加 acquire 读,或干脆 seq_cst)。配置更新、数据就绪、关闭信号——凡标志背后跟着数据的,必须带顺序保证。构件三:自旋锁与比较交换。compare_exchange_weak 是免锁算法的积木,也是自旋锁的内核:
#include <atomic> #include <cstdio> #include <thread> class SpinLock { std::atomic_flag flag_ = ATOMIC_FLAG_INIT; public: void lock() { while (flag_.test_and_set(std::memory_order_acquire)) { // 忙等:转圈直到拿到凭证 } } void unlock() { flag_.clear(std::memory_order_release); } }; SpinLock spin; long tickets = 0; void sell(int n) { for (int i = 0; i < n; ++i) { spin.lock(); ++tickets; spin.unlock(); } } int main() { std::thread t1(sell, 50000), t2(sell, 50000); t1.join(); t2.join(); std::printf("售票 %ld 张,账实相符\n", tickets); return 0; }
输出确定:
售票 100000 张,账实相符
边界要清醒:自旋锁等待时占着 CPU 空转,只适合"临界区极短、竞争极轻"的场景;竞争一重,空转烧掉的算力远超 mutex 的休眠等待。免锁不是免费的,它把成本从等待转移到了设计复杂度与验证难度上——无锁数据结构的正确性论证是专家级工作,工程上默认选锁,免锁留给瓶颈实测证明必要之后。
⚠️ 常见坑:atomic 让普通变量"整体原子"的幻觉。std::atomic 只有 128 位以内且硬件支持才免锁,更大的对象会退化为隐藏的锁;而且 atomic 结构体只保原子性,成员组合的语义(比如钱从 A 账扣、B 账加要一起生效)它一概不管——那是事务,是锁或数据库的辖区。
本节要点回顾
- atomic 保证原子性:fetch_add 等操作硬件级不可拆,计数器场景 relaxed 即够。
- 三层保证分层买:原子性最基础,可见性靠同步关系,顺序性最贵。
- release-acquire 画同步线:标志背后有数据的场景必备,relaxed 传标志不传数据。
- seq_cst 是默认档:拿不准就用它,多原子变量协作必须用它;优化要有实测依据。
- 免锁三构件:relaxed 计数、acquire-release 发布、compare_exchange 积木。
- 边界要清醒:自旋锁只配短临界区轻竞争,免锁结构正确性论证成本极高。
并发账房到此收账:竞争、锁、原子与内存序,三层秩序各就各位。下一章做全册的收官审计——把账本摊到硬件上核算分配、缓存与对齐的物理成本,并请出 sanitizer 为全册账目做总对账。