4.2 蓝绿与金丝雀
4.2 蓝绿与金丝雀
本节摘要:蓝绿部署维护两套相同生产环境,测试通过后一次性切流量;金丝雀先将少量流量导向新版本,逐步扩大。本节用 K8s Service/Deployment、Argo Rollouts 权重与 Istio VirtualService 演示两种策略的配置。
你能学到什么
阅读完本节,你应当能够:
- 解释蓝绿与金丝雀的流量切换机制
- 在 K8s 配置蓝绿双 Deployment + Service 切换
- 使用 Argo Rollouts 实现 5%→100% 金丝雀
- 选择滚动更新、蓝绿、金丝雀的适用场景
一、蓝绿部署动手做
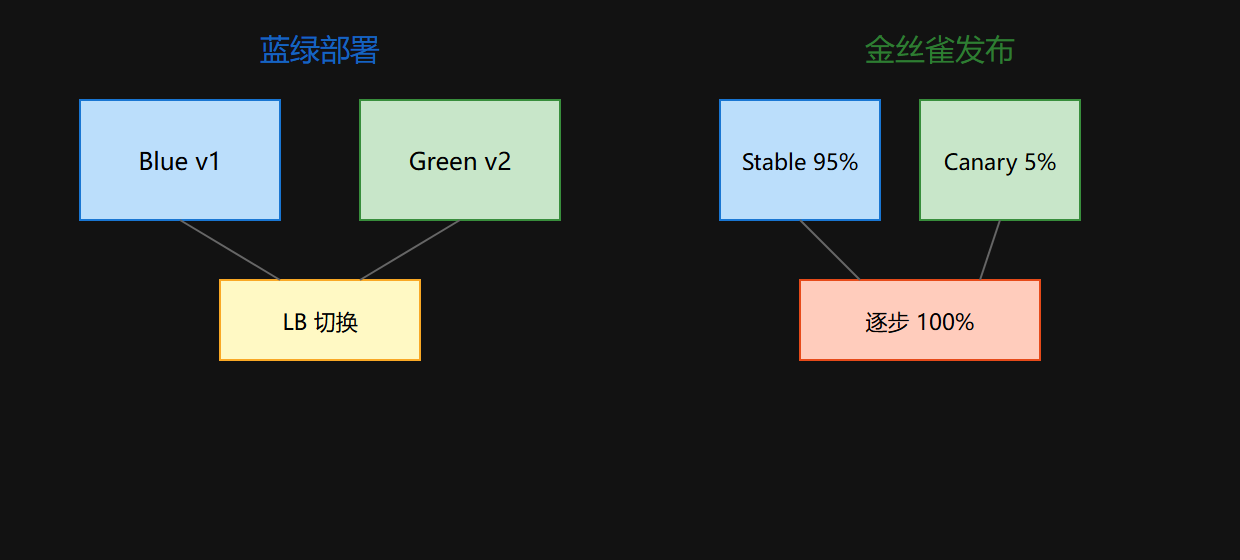
两套 Deployment:app-blue、app-green。Service selector 指向当前活跃色。
# app-green deployment(新版本) apiVersion: apps/v1 kind: Deployment metadata: { name: app-green } spec: replicas: 3 selector: { matchLabels: { app: myapp, version: green } } template: metadata: { labels: { app: myapp, version: green } } spec: containers: - name: app image: registry/app:v2.0.0 --- apiVersion: v1 kind: Service metadata: { name: myapp } spec: selector: { app: myapp, version: green } # 从 blue 改为 green 即切换 ports: [{ port: 80, targetPort: 8080 }]
切换命令:
kubectl patch service myapp -p '{"spec":{"selector":{"version":"green"}}}'
旧 blue 保留 24h 便于 instant rollback——patch 回 blue 即可。
蓝绿 vs 金丝雀拓扑
二、Argo Rollouts 金丝雀
apiVersion: argoproj.io/v1alpha1 kind: Rollout metadata: { name: myapp } spec: replicas: 10 strategy: canary: steps: - setWeight: 5 - pause: { duration: 5m } - setWeight: 25 - pause: { duration: 5m } - setWeight: 100 trafficRouting: nginx: { stableIngress: myapp-stable, canaryIngress: myapp-canary } selector: { matchLabels: { app: myapp } } template: metadata: { labels: { app: myapp } } spec: containers: [{ name: app, image: registry/app:v2.0.0 }]
每步 pause 观察 error rate;Prometheus 告警触发则 kubectl argo rollouts abort myapp。
策略选型表
| 策略 | 资源成本 | 回滚速度 | 风险暴露 | 适用 |
|---|---|---|---|---|
| 滚动更新 | 低 | 分钟 | 中 | 无状态微服务 |
| 蓝绿 | 高(双倍) | 秒 | 低 | 核心交易 |
| 金丝雀 | 中 | 秒~分 | 最低 | 大流量 |
| A/B | 中 | N/A | 实验 | 转化率优化 |
⚠️ 常见坑:蓝绿切换后立刻删 blue——新版本内存泄漏要 2h 才 OOM,应保留 blue 至 metrics 稳定。
💡 关键直觉:Google SRE книга称金丝雀为 canarying releases——用真实用户流量作最后测试,但 blast radius 可控。
Istio VirtualService 权重
spec: http: - route: - destination: { host: myapp, subset: stable } weight: 95 - destination: { host: myapp, subset: canary } weight: 5
无需双倍 pod,适合资源紧张集群——但需 Istio sidecar 开销。
K8s 原生 RollingUpdate 参数
strategy: type: RollingUpdate rollingUpdate: maxSurge: 25% maxUnavailable: 0
maxUnavailable: 0 保证升级过程容量不降——适合 CDP 高频发布。
四、滚动更新与 A/B 部署(SOURCE 3.4/4.2 扩展)
Kubernetes RollingUpdate 细节
spec: minReadySeconds: 30 progressDeadlineSeconds: 600 revisionHistoryLimit: 10
minReadySeconds 新 pod ready 后仍等 30s 才计为 available——给 JVM warmup 时间。revisionHistoryLimit 保留 10 个 ReplicaSet 便于 rollback。
A/B 与金丝雀区别
金丝雀看系统指标(error rate、latency);A/B 看业务指标(转化率、点击率)。A/B 需流量分割 + 统计分析显著性——Optimizely、LaunchDarkly 集成。运维金丝雀用 Prometheus;产品 A/B 用 analytics pipeline。
Serverless 蓝绿
Lambda alias live 指向 version N,candidate 指向 N+1——加权 alias routing 实现金丝雀:
aws lambda update-alias --name live --function-version N+1 --routing-config AdditionalVersionWeights={N+1=0.05}
无 K8s 的 team 仍可做渐进发布。
部署窗口与全球化
全球用户时「低峰窗口」不存在——金丝雀 + 自动 rollback 替代「凌晨 2 点维护窗口」。仍选窗口的团队,通常是 CD 非 CDP,需人工值守。
本章回顾
- 蓝绿 双环境 + Service selector 切换,回滚秒级
- 金丝雀 渐进流量,Argo Rollouts 自动化 step
- 滚动更新 K8s 默认,资源最省
- 保留旧版 24h 再缩容
- Istio 权重 细粒度 traffic split
- A/B 偏产品实验非纯运维
- pause + metrics 金丝雀每步验收
下一节 4.3 监控驱动的自动回滚。
发布策略的工程决策
选发布策略,先问三个问题:回滚速度要多快、资源成本能承受多少、风险暴露面有多大。蓝绿最贵但回滚最快(切 selector 秒级),适合核心交易与数据库强耦合服务;金丝雀资源成本适中,适合大流量且需要真实用户验证的服务;滚动更新最省资源,是默认兜底,但无法快速回滚到上一版本前的稳定态。
落地时的细节决定成败:蓝绿要保留旧环境至少一个观察周期,不能切完就删;金丝雀每步都要有明确的验收指标(error rate、latency),不达标自动 abort;A/B 是产品实验不是运维手段,与金丝雀不能混用。对于无状态服务,任何策略都可行;有状态服务(含数据库写路径)要先解决数据兼容,再谈流量切换。
有状态服务的发布策略
有状态服务(数据库写路径、会话保持)的发布不能只切换流量,还要处理数据兼容:新版本写入的 schema 必须能被旧版本读取(expand 阶段先加列),回滚时旧版本不能因新数据崩溃。蓝绿对有状态服务成本更高(双份数据库),金丝雀则要保证同一用户会话不跨版本漂移。实际做法是把状态迁移与应用发布解耦,让数据库兼容性成为发布的前提条件而非伴随动作。
流量切换的可观测性
无论蓝绿还是金丝雀,流量切换期间都必须保证可观测性:Grafana 面板实时展示两版本的错误率、时延、吞吐,部署时间点通过 annotation 标记。金丝雀的每一档推进前,都要对比 canary 与 stable 的指标差异,差异超过阈值就自动回缩。切换完成后,保留旧版本一段时间(观察期)再清理,让监控有足够窗口发现迟发性问题。