1.3 图像数据基础:像素、通道与张量形状
1.3 图像数据基础:像素、通道与张量形状
本节摘要:模型眼里的图像是一个四维张量,形状记作 N×C×H×W——批大小、通道数、高、宽。入线检查的任务是把任意来源的图片规整成这四个维度都确定的 float32 张量,并完成归一化。本节给出通道、尺寸、数值范围三项检查的代码与一桩经典事故(RGB 与 BGR 顺序颠倒),是进入第二章主车间前的最后一道手续。
本节要回答的问题
一张 JPEG 在磁盘上是压缩过的字节流,在模型里是浮点数张量,中间隔着解码、缩放、转置、归一化若干步。哪一步最容易出错?经验答案是:全都容易。所以与其靠记性,不如靠对账——每一步之后形状是多少、数值范围是多少,都应该有明确的预期值。本节就把这份对账单建起来。
学习目标
阅读完本节,你应当能够:
- 说出 NCHW 四个字母的含义,给任意中间特征图报出维度;
- 用代码完成"解码、缩放、转张量、归一化"的标准入线流程;
- 心算一个批次的显存占用,判断自己的显卡装不装得下;
- 识别通道顺序、数值范围两类入线事故的症状与修法。
一、像素与通道:图像的三维骨架
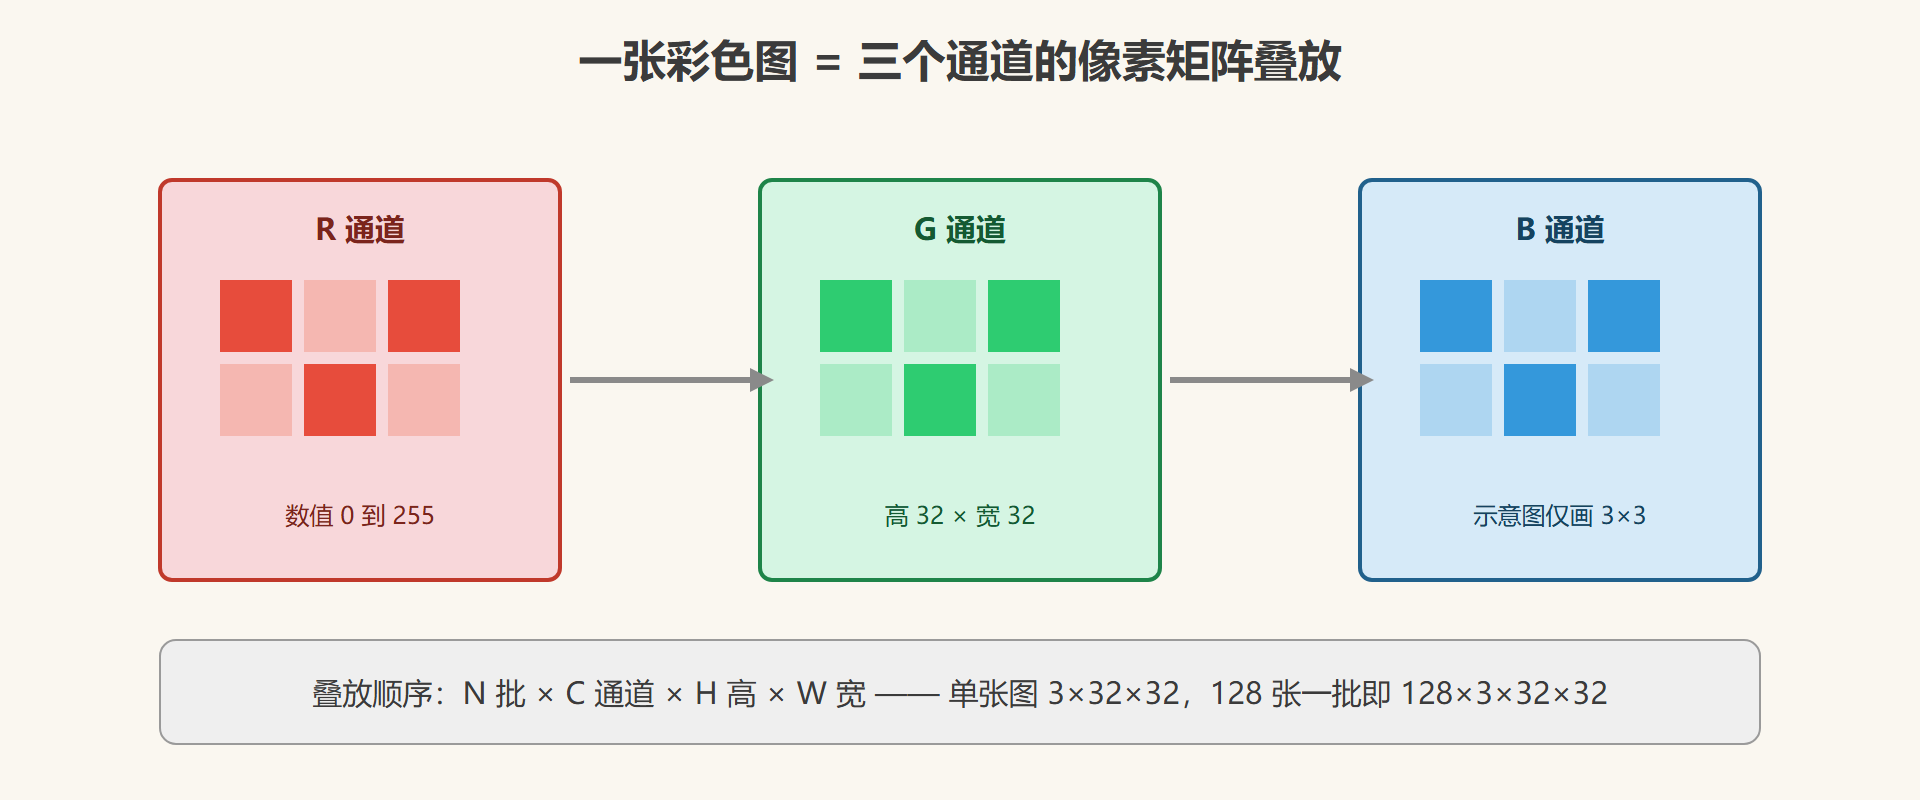
黑白照片是二维网格,每个格子存一个亮度值,0 为纯黑、255 为纯白(8 位存储)。彩色照片用三个这样的网格叠加:红、绿、蓝三个通道各自记录一种颜色的强度,三者按比例混合出肉眼看到的所有颜色。于是单张图天然是三维的:C×H×W,通道数乘高乘宽。
卷积框架普遍采用 NCHW 排布:最外层是批大小 N,把多张图摞成一个批次,后三维依次是通道、高、宽。批次化不是为了好看——GPU 擅长并行处理大块规整数据,一次喂一批比逐张喂快得多。本章主角、贯穿全册的那张 32×32 彩色小图,单张形状是 3×32×32;按 128 张的批次送入,就成了 128×3×32×32 的四维张量。
图 1-2 单张图像的张量骨架
二、入线手续:从解码到归一化
标准流程有四步。第一步解码,把压缩字节流还原成像素矩阵,顺手处理手机照片常见的旋转标记;第二步几何规整,缩放或裁剪到网络的固定输入边长;第三步转张量,把 0 到 255 的 uint8 除以 255 变成 0 到 1 的 float32;第四步数值规整,减均值、除标准差,把分布拉到以零为中心。前两步解决"形状对不对",后两步解决"数值好不好"。
import torch # 合成一张 4×4 纯色图:三通道亮度分别为 255、128、0,代替真实读图 img = torch.zeros(3, 4, 4, dtype=torch.uint8) img[0] = 255 img[1] = 128 img[2] = 0 x = img.float() / 255.0 # 第三步:0 到 1 的 float32 mean = torch.tensor([0.485, 0.456, 0.406]).view(3, 1, 1) # ImageNet 通道均值 std = torch.tensor([0.229, 0.224, 0.225]).view(3, 1, 1) # ImageNet 通道标准差 xn = (x - mean) / std # 第四步:逐通道标准化 print(x.shape) # torch.Size([3, 4, 4]) print(x.dtype) # torch.float32 print(round(xn[0, 0, 0].item(), 3)) # 2.249 最亮红通道 print(round(xn[1, 0, 0].item(), 3)) # 0.205 中等绿通道 print(round(xn[2, 0, 0].item(), 3)) # -1.804 全黑蓝通道
减的均值、除的标准差不是玄学常数:它们是在百万级图像集上统计出的各通道平均亮度和波动幅度。用自己数据集的统计值替代完全合理,但训练与推理必须用同一套,否则同一张图在两边会被解读成两种亮度分布。
三、对账与排错:显存、通道与范围
批次送进显存前,先心算账目。128 张 3×32×32 的 float32 图:128×3×32×32 = 393,216 个数,每个 4 字节,约 1.5 MiB——小意思。换成一批 64 张 224×224×3 的图:64×3×224×224×4 字节 ≈ 38.5 MiB,加上网络中间特征图与反向传播的梯度,占用会翻好几倍。训练时显存溢出,第一件事就是回头查批次大小。
import torch import torch.nn.functional as F # 一批 128 张 32×32 彩图的显存账 N, C, H, W = 128, 3, 32, 32 batch = torch.randn(N, C, H, W) mem_mib = batch.numel() * 4 / 1024**2 print("批次元素个数:", batch.numel()) # 393216 print("显存占用 MiB:", round(mem_mib, 2)) # 1.5 # 标签要变成 one-hot 才能和 10 类输出做交叉熵对账(部分框架内部处理) labels = torch.randint(0, 10, (N,)) onehot = F.one_hot(labels, num_classes=10) print("标签形状:", tuple(onehot.shape)) # (128, 10)
两类高频事故值得单独点名。其一是通道顺序:Pillow 按 RGB 读,OpenCV 按 BGR 读,用 OpenCV 预处理却喂给按 RGB 统计均值的网络,红蓝互换——模型不会报错,只会安静地把准确率掉一截,极难察觉。其二是数值范围:忘了除 255,输入带着 0 到 255 的幅度冲进网络,第一层卷积输出直接饱和,表现为损失不降。排查口诀:形状、通道序、数值范围,三查之后再谈调参。
巡检记录
- 形状语言:NCHW 四维贯穿全册,报形状时按批次、通道、高、宽的顺序念;
- 归一化两件套:先除 255 到 0 到 1,再减均值除标准差到零附近,训练推理必须同一套统计值;
- 显存心算:元素个数乘 4 字节,128 张 32×32 彩图约 1.5 MiB,64 张 224×224 彩图约 38.5 MiB;
- 事故清单:BGR 与 RGB 颠倒、忘了除 255,这两类错误不报错、只掉分,入线时就要拦住。
⚠️ 常见坑:读图库返回的通道序与训练统计的通道序不一致时,症状是"模型能跑但准确率显著偏低"。先打印张量逐通道均值对比统计值,再怀疑模型本身。
原料合格,主车间的灯已经亮了。第二章从流水线的核心工位开始:卷积层到底在图上做什么。