4.2 反向传播:误差如何倒流回每个工位
4.2 反向传播:误差如何倒流回每个工位
本节摘要:反向传播是训练闭环的回流管道:损失对输出求导,沿计算图逐层倒推,把"每个参数该为这次错误负多少责"(梯度)送到它手里。本节用一个两层小账完全手算一遍前向与反向,再让自动求导对账,最后用连乘实验看清梯度消失的算术本质。
一笔可以全手算的账
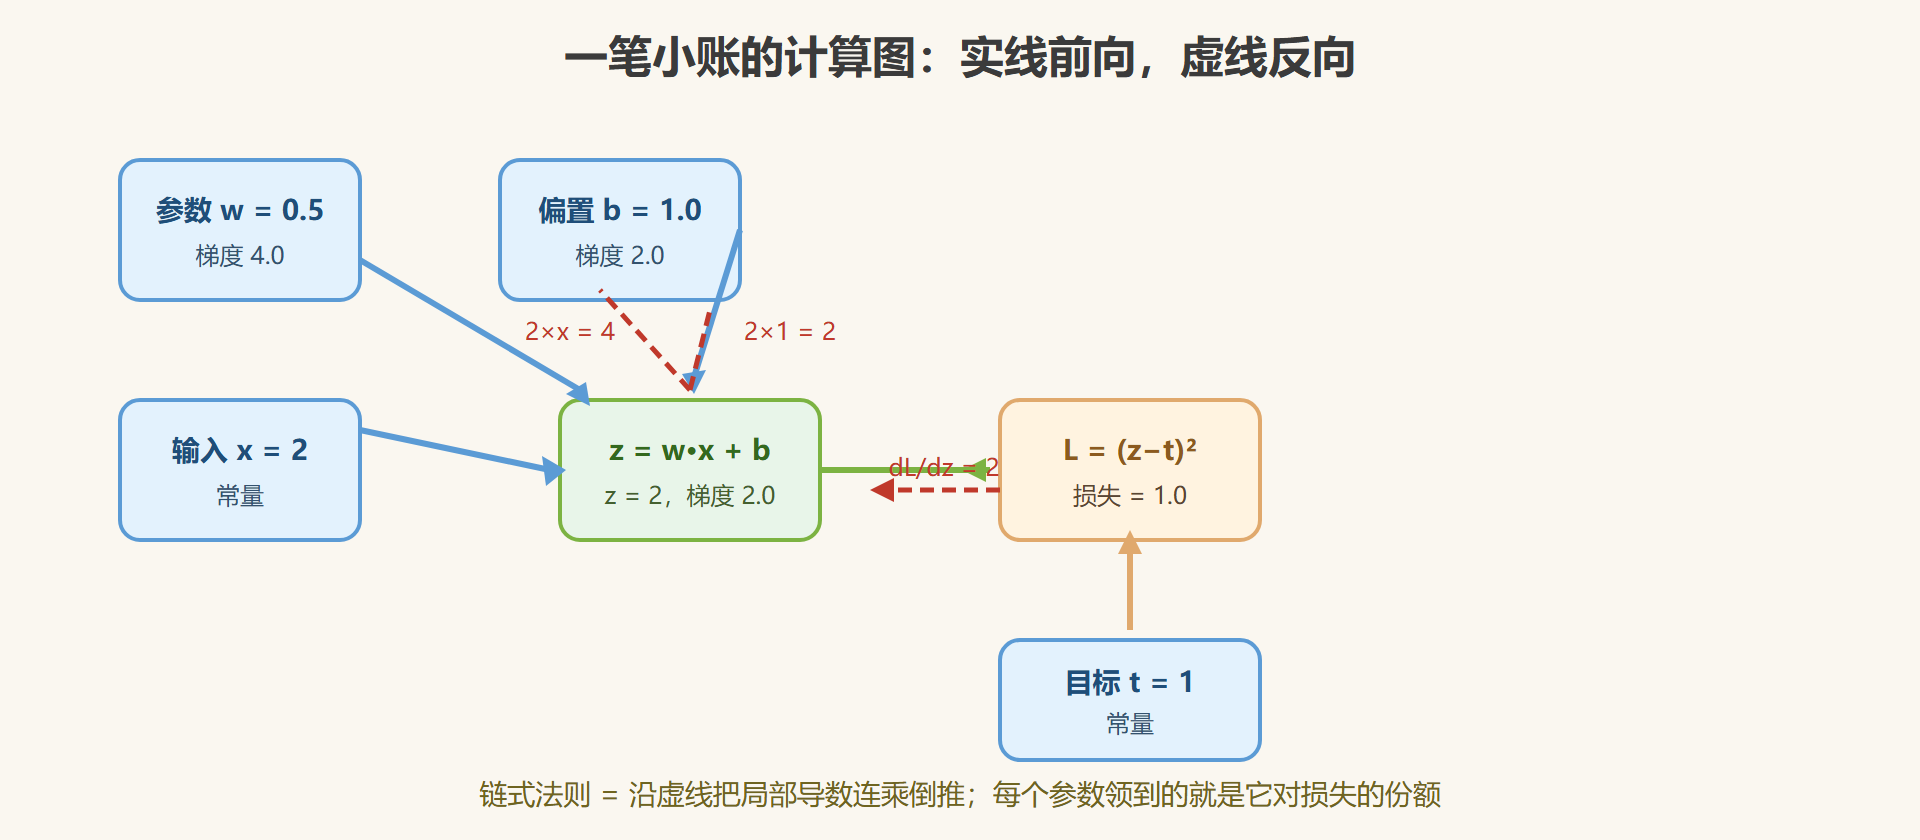
取最小的场景:一个样本、一个参数 w、一个偏置 b。前向两步——z = w×x + b(加权求和),损失 L = (z − t)²(差的平方)。代入 x=2、w=0.5、b=1、目标 t=1:z = 0.5×2+1 = 2,L = (2−1)² = 1。反向按链式法则倒推:损失对 z 的导数是 2×(z−t) = 2;z 对 w 的导数是 x = 2,两个一乘,w 的梯度是 4;z 对 b 的导数是 1,b 的梯度是 2。**梯度就是"责任认定书":参数动一动,损失跟着变多少。**
import torch x = torch.tensor([2.0]) w = torch.tensor([0.5], requires_grad=True) b = torch.tensor([1.0], requires_grad=True) t = torch.tensor([1.0]) z = w * x + b # 前向:加权求和 loss = (z - t) ** 2 # 前向:平方损失 loss.backward() # 反向:自动倒推 print("损失:", loss.item()) # 1.0 print("w 的梯度:", w.grad.item()) # 4.0 = 2(z−t)×x = 2×1×2 print("b 的梯度:", b.grad.item()) # 2.0 = 2(z−t)×1 with torch.no_grad(): # 沿负梯度方向走一小步(学习率 0.1) w -= 0.1 * w.grad b -= 0.1 * b.grad print("更新后 z:", (w * x + b).item()) # 1.0,恰好命中目标
更新后 z 正好落在目标上不是巧合:w 的新值 0.5−0.1×4 = 0.1,b 的新值 1.0−0.1×2 = 0.8,z = 0.1×2+0.8 = 1.0。小账虽小,五步流程(前向、打分、求导、倒推、更新)与百万参数的大网络一模一样——区别只是链式法则的链条更长、由框架代算。
学习目标
阅读完本节,你应当能够:
- 对两层以内的复合函数手算完整的前向值与梯度;
- 解释计算图为什么让反向传播只需一次"倒着走";
- 复算饱和激活的梯度连乘,说清梯度消失的算术来源;
- 用梯度检查(数值微分)验证手推或框架的梯度。
一、计算图:一次前向换来一次全量反向
网络无论多深,前向计算都会被框架记录成一张计算图:节点是运算,边是数据流。反向传播从损失节点出发,沿边逆向走一遍,每到一个参数节点就累加它的梯度。精妙之处在复杂度:反着走一遍的代价与正着走一遍同阶——不管网络有一万层还是一亿参数,一次训练步只需一次前向加一次反向。各层复用同一份上游导数,这正是链式法则的工程形态。
倒流的秩序也有讲究:同一批数据的反向必须从损失端逐层推进,所以框架都会在前向时保留中间激活值(给反向复用),这也是训练比推理吃显存得多的原因。显存告急时,梯度检查点等以时间换空间的手段(重算代替保存)就是从这张图上省出来的。
梯度送到每个参数手里的前提,是倒流的路径清晰可见。看一眼这张计算图,正向实线、反向虚线,两条车道方向相反、共用一套节点:
图 4-2 计算图上的前向与反向
二、梯度消失:连乘的算术
2.3 节埋过伏笔:饱和激活的导数小于一,链式法则逐层连乘,深层网络的梯度会指数级萎缩。这笔账小到不必框架:
scale = 0.25 # Sigmoid 在 0 处的最大导数 grad = 1.0 for i in range(10): grad *= scale print("0.25 连乘十次:", f"{grad:.2e}") # 9.54e-07
十层就只剩百万分之一;若导数取在饱和区(趋近零),萎缩更狠。误差信号传到浅层时已无力指挥参数——这就是 2012 年前深层网络训不动的算术真相。ReLU(正区导数恒一)与残差跳线(3.5 节,梯度沿捷径短路回传)各修了这条链的一环。对偶的问题叫梯度爆炸(连乘大于一),批归一化与梯度裁剪负责按住它。
三、亲手验一次梯度
怀疑手推导数推错、或怀疑框架有毛病时,有一招万能对账:数值微分。导数的定义是"挪一点点看变化率",取极小步长直接算:
import torch import torch.nn.functional as F x = torch.tensor([2.0]) w = torch.tensor([0.5]) t = torch.tensor([1.0]) def loss_at(wv): return float(((wv * x + b0 - t) ** 2)) b0 = torch.tensor([1.0]) eps = 1e-5 numerical = (loss_at(w + eps) - loss_at(w - eps)) / (2 * eps) print("数值梯度:", round(numerical, 4)) # 4.0,与反向传播一致
解析梯度 4.0 对上数值梯度 4.0,链条没有断点。这招在自研结构、自定义损失时是救命稻草:梯度检查不过,先查自己的推导,再怀疑人生。
巡检记录
- 梯度即责任书:损失对该参数的导数,数值上等于"参数挪一点、损失变多少",4.2 节小账里 w 认领 4.0、b 认领 2.0;
- 计算图红利:一次前向 + 一次反向即可更新全部参数,代价与网络规模同阶;
- 消失是算术不是玄学:0.25 连乘十次剩 9.54e-07,ReLU 与残差跳线分别斩断连乘链的两处衰减;
- 数值微分兜底:任何解析梯度都能用极小步长的差分对账,自研结构上线前先过这一关。
💡 关键直觉:把反向传播想成"倒查责任链"。质检台给出总差评(损失),逐站倒查每道工序的责任份额——每个参数拿到的梯度,就是它对差评应负的部分;优化器只负责按份额执行改动。
梯度送到每个参数手里,最后一环是执行:按什么节奏改参数,就是下一节优化器的话题。