4.8 模型评估指标:出厂验收单
4.8 模型评估指标:出厂验收单
本节摘要:准确率是验收的第一栏,但类别不平衡时它会撒谎——"狗"占九成的数据集里全猜狗也有九成"准确"。本节把混淆矩阵与精确率、召回率、F1 三件套用一组真实数字算透,解释宏平均与 Top-5 的口径,为第五章的检测与分割指标铺好地基。
验收单上都有什么栏
模型练完,谁说了算?答案是测试集上的指标——前提是测试集从未参与训练与调参。验收单第一栏是总体准确率:判对的比例。它直观,却有个致命盲区:类别不平衡时被多数类绑架。九成是狗的验证集上,一个只会喊"狗"的废物模型准确率高达九成——所以验收单还需要按类别拆开的栏:混淆矩阵,以及从它算出的精确率、召回率与 F1。这一节把这套口径用固定的一百个样本算到小数点。
学习目标
阅读完本节,你应当能够:
- 从混淆矩阵读出每类的判对与误判走向;
- 手算精确率、召回率与 F1,并解释两者的取舍关系;
- 在不平衡数据上改用宏平均,说清它与总体准确率的差异;
- 复算 Top-1 与 Top-5 的口径,知道大数据集为何用后者。
一、混淆矩阵与三件套
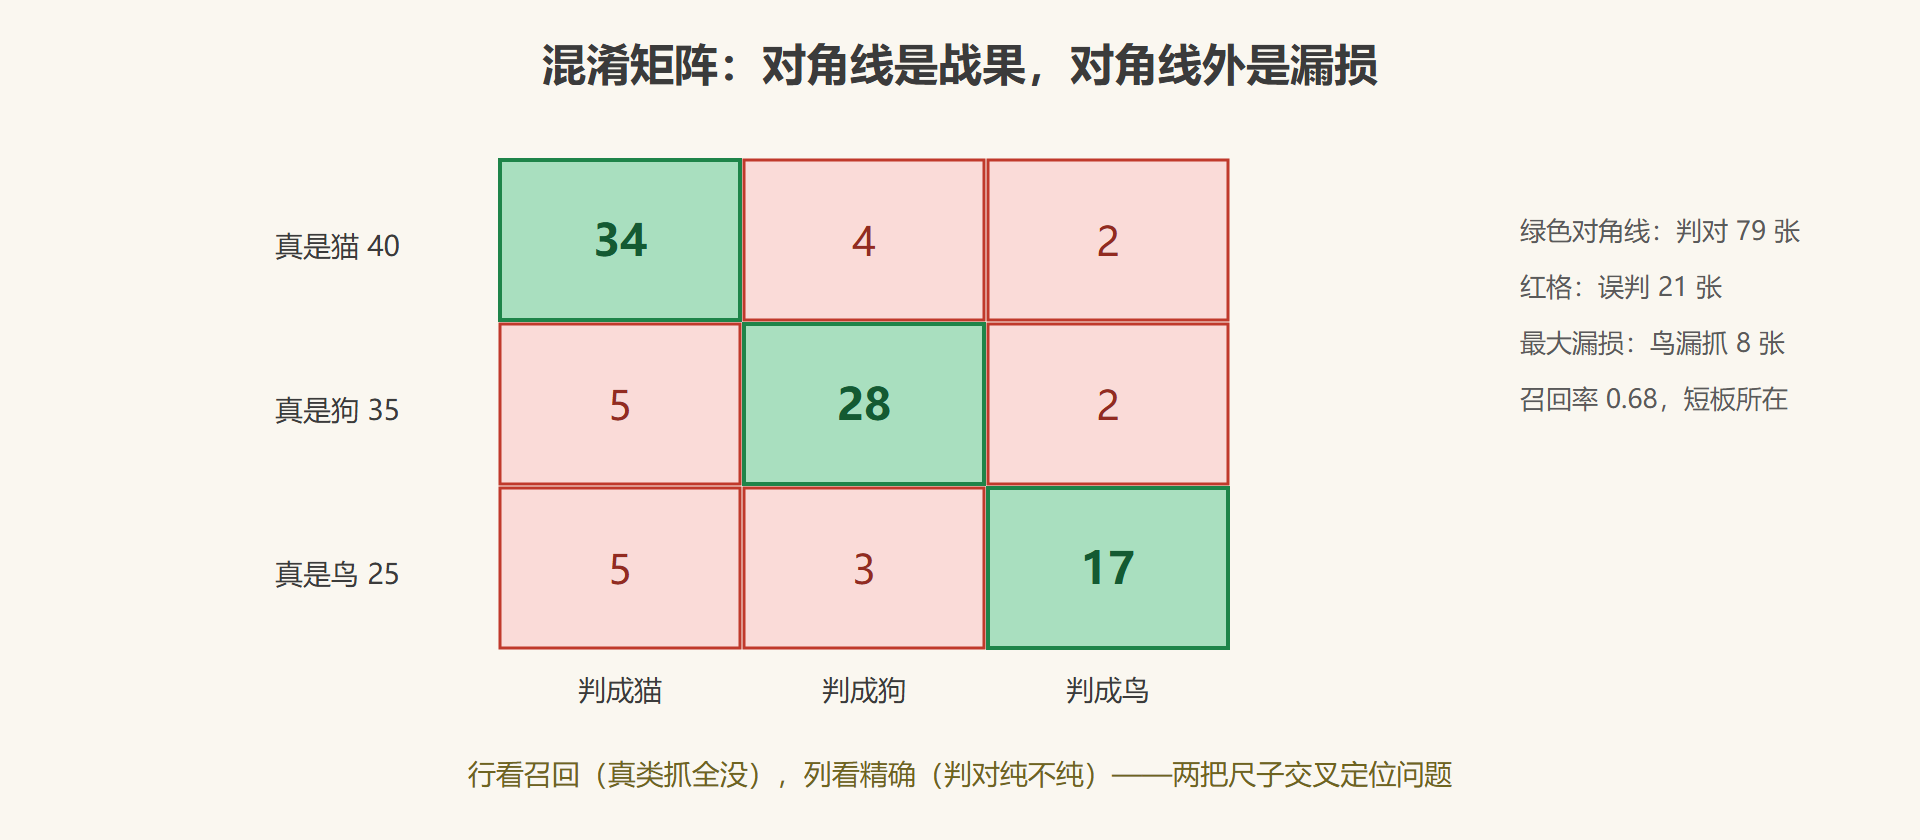
设定一份验收场景:猫、狗、鸟共一百张测试图,模型的判决结果列成混淆矩阵——行是真实类别,列是预测类别。猫四十张:判对三十四、误成狗四、误成鸟二;狗三十五张:判对二十八、误成猫五、误成鸟二;鸟二十五张:判对十七、误成猫五、误成狗三。
import torch conf = torch.tensor([ [34, 4, 2], # 真实猫的判决去向 [5, 28, 2], # 真实狗 [5, 3, 17], # 真实鸟 ]) print("总体准确率:", round((conf.diag().sum() / conf.sum()).item(), 3)) # 0.79 f1s = [] for i, name in enumerate(["猫", "狗", "鸟"]): tp = conf[i, i].item() prec = tp / conf[:, i].sum().item() # 精确率:判成 i 的里面多少真对 rec = tp / conf[i, :].sum().item() # 召回率:真是 i 的里面抓住多少 f1 = 2 * prec * rec / (prec + rec) f1s.append(f1) print(f"{name}: 精确率 {prec:.3f} 召回率 {rec:.3f} F1 {f1:.3f}") # 猫: 0.773 0.850 0.810 # 狗: 0.800 0.800 0.800 # 鸟: 0.810 0.680 0.739 print("宏平均 F1:", round(sum(f1s) / 3, 3)) # 0.783
逐格核对口径:猫的精确率 34÷44(判成猫的共四十四张:三十四真猫加五狗五鸟误入),召回率 34÷40(真猫四十张抓住三十四);F1 是两者的调和平均,谁拖后腿就拉低谁。读这份验收单的方法:鸟的召回率只有 0.68,说明三成二的鸟被漏抓——总体 0.79 的准确率完全看不出这个短板,不平衡问题一拆便现形。这正是宏平均(按类取平均)存在的意义:每类一票,多数类无法刷票。
图 4-5 混淆矩阵的对角线读法
二、Top-5 与验收纪律
ImageNet 有一千个类,把正确类挤进前五也算对的 Top-5 口径由此通行——类越多、类间越相似,Top-5 越能反映"大方向对不对"。口径本身可以用确定性小例算清:
import torch n = 100 logits = torch.zeros(n, 10) labels = torch.zeros(n, dtype=torch.long) for i in range(n): if i < 40: # 40 张:正确类排第一 logits[i, 3] = 5.0 labels[i] = 3 elif i < 90: # 50 张:正确类排第二,Top-1 丢、Top-5 留 logits[i, 7] = 6.0 logits[i, 3] = 5.0 labels[i] = 3 else: # 10 张:正确类掉出前五 for j, v in [(1, 6.0), (2, 5.9), (4, 5.8), (5, 5.7), (6, 5.6)]: logits[i, j] = v labels[i] = 3 top1 = (logits.argmax(1) == labels).float().mean().item() top5 = (logits.topk(5, 1).indices == labels.unsqueeze(1)).any(1).float().mean().item() print("Top-1:", round(top1, 2)) # 0.40 print("Top-5:", round(top5, 2)) # 0.90
验收纪律比指标本身更容易失守:验证集用于选模型调超参,测试集只在最终验收碰一次;两者混用,指标就成了对着答案涂卡。类别不平衡的任务,验收单以宏平均 F1 与每类召回为主栏;代价敏感的场景(漏检缺陷比误报更贵)还要把召回单独设门槛——指标是业务约束的翻译,翻译错了,训练再好也白练。
追问两则
问:微平均与宏平均差在哪?答:微平均把所有类的判对数加总再算比例,多数类话语权大;宏平均每类一票、类类平等。四百狗对十鸟的集合里,两者可能差出十几分——汇报哪个,取决于你关心"整体吞吐"还是"最弱一环"。问:验证集多大才够?答:经验下限是每类几百张,稀有类的验证样本少于几十个时,指标的置信区间会宽到没法做决策——与其加大模型,不如先补验证样本。
巡检记录
- 准确率的盲区:不平衡时被多数类绑架,九成狗的集合里全猜狗也九成准;
- 三件套口径:列看精确率(判成猫的纯度 34÷44),行看召回率(真猫抓全 34÷40),F1 调和两者;
- 宏平均:每类一票算 F1 再平均(本例 0.783),多数类刷不了票;
- Top-5 的意义:类多且相似时考察"大方向",本例 Top-1 0.40 而 Top-5 0.90;
- 纪律:验证集调参、测试集终验,混用等于作弊。
⚠️ 常见坑:只汇报总体准确率接不平衡项目。先看混淆矩阵再定指标主栏——绝大多数"准确率虚高"的事故,一张混淆矩阵就能提前揭穿。
训练篇至此完整闭环:量具、回流、节奏、进料、稳态、双闸、捷径、验收。第五章把练好的流水线送出厂,看看分类之外它还能干什么。