5.1 综合实战:一个图像分类项目的全流程复盘
5.1 综合实战:一个图像分类项目的全流程复盘
本节摘要:前面八章的零件在这一节组装成整机:从拿到数据到交付一份验收报告,按"背景、操作、结果、解读、变式"五段复盘一个完整的十类图像分类项目。所有环节都能在前文找到对应章节——这一节既是复习地图,也是你下一个项目的操作底稿。
项目档案:十万张小图的十类分类
背景:任务是把 32×32 的彩色小图分成飞机、汽车、鸟等十个类别(CIFAR-10 规格),训练集五万张、测试集一万张。约束:单张消费级显卡、可接受的训练时长、交付物是"模型加验收报告"。这个规模是检验全书零件成色的标准试金石——再小的项目练不了真功夫,再大的项目变量太多。
学习目标
阅读完本节,你应当能够:
- 按固定顺序组装训练脚本:数据、模型、优化器、调度器、损失、循环;
- 写出规范的评估循环(关梯度、双态切换、逐类统计);
- 读自己的训练日志,定位欠拟合、过拟合与调度失当;
- 把本节清单迁移到自己的数据集上。
一、操作:六步组装
数据与增强直接搬 4.4 节的 CIFAR 管线(随机裁剪、水平翻转、色彩抖动加归一化,测试侧只做确定性预处理);骨干在 2.6 节的 TinyCNN 与 3.5 节的 ResNet-18 之间按算力选择;训练侧的组装顺序如下,每行都来自前文的巡检结论:
import torch import torch.nn as nn device = "cuda" if torch.cuda.is_available() else "cpu" net = TinyCNN().to(device) # 骨干:来自 2.6 节的定义 opt = torch.optim.AdamW(net.parameters(), # 优化器:4.3 与 4.6 节的默认配方 lr=1e-3, weight_decay=0.01) sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=50) # 余弦退火 crit = nn.CrossEntropyLoss() # 量具:4.1 节 for epoch in range(50): net.train() # 训练态:4.5 节的双态纪律 for x, y in train_loader: # 批 128:4.4 节增强管线 x, y = x.to(device), y.to(device) opt.zero_grad() # 清上一批的梯度 loss = crit(net(x), y) # 前向加打分 loss.backward() # 反向:4.2 节 opt.step() # 更新:4.3 节 sched.step() # 每轮末调步长:4.6 节 # 每 5 轮跑一次评估段并记录最优权重(早停兜底)
评估循环独立成段,三条纪律缺一不可:切推理态(BN 用滑动统计、Dropout 直通)、关梯度(省显存提速)、逐类统计(给验收单供料):
net.eval() correct = total = 0 hit = [0] * 10 seen = [0] * 10 with torch.no_grad(): for x, y in test_loader: x, y = x.to(device), y.to(device) pred = net(x).argmax(dim=1) correct += (pred == y).sum().item() total += y.numel() for c in range(10): hit[c] += ((pred == y) & (y == c)).sum().item() seen[c] += (y == c).sum().item() print("总体准确率:", round(correct / total, 4)) print("每类召回:", [round(h / s, 3) for h, s in zip(hit, seen)])
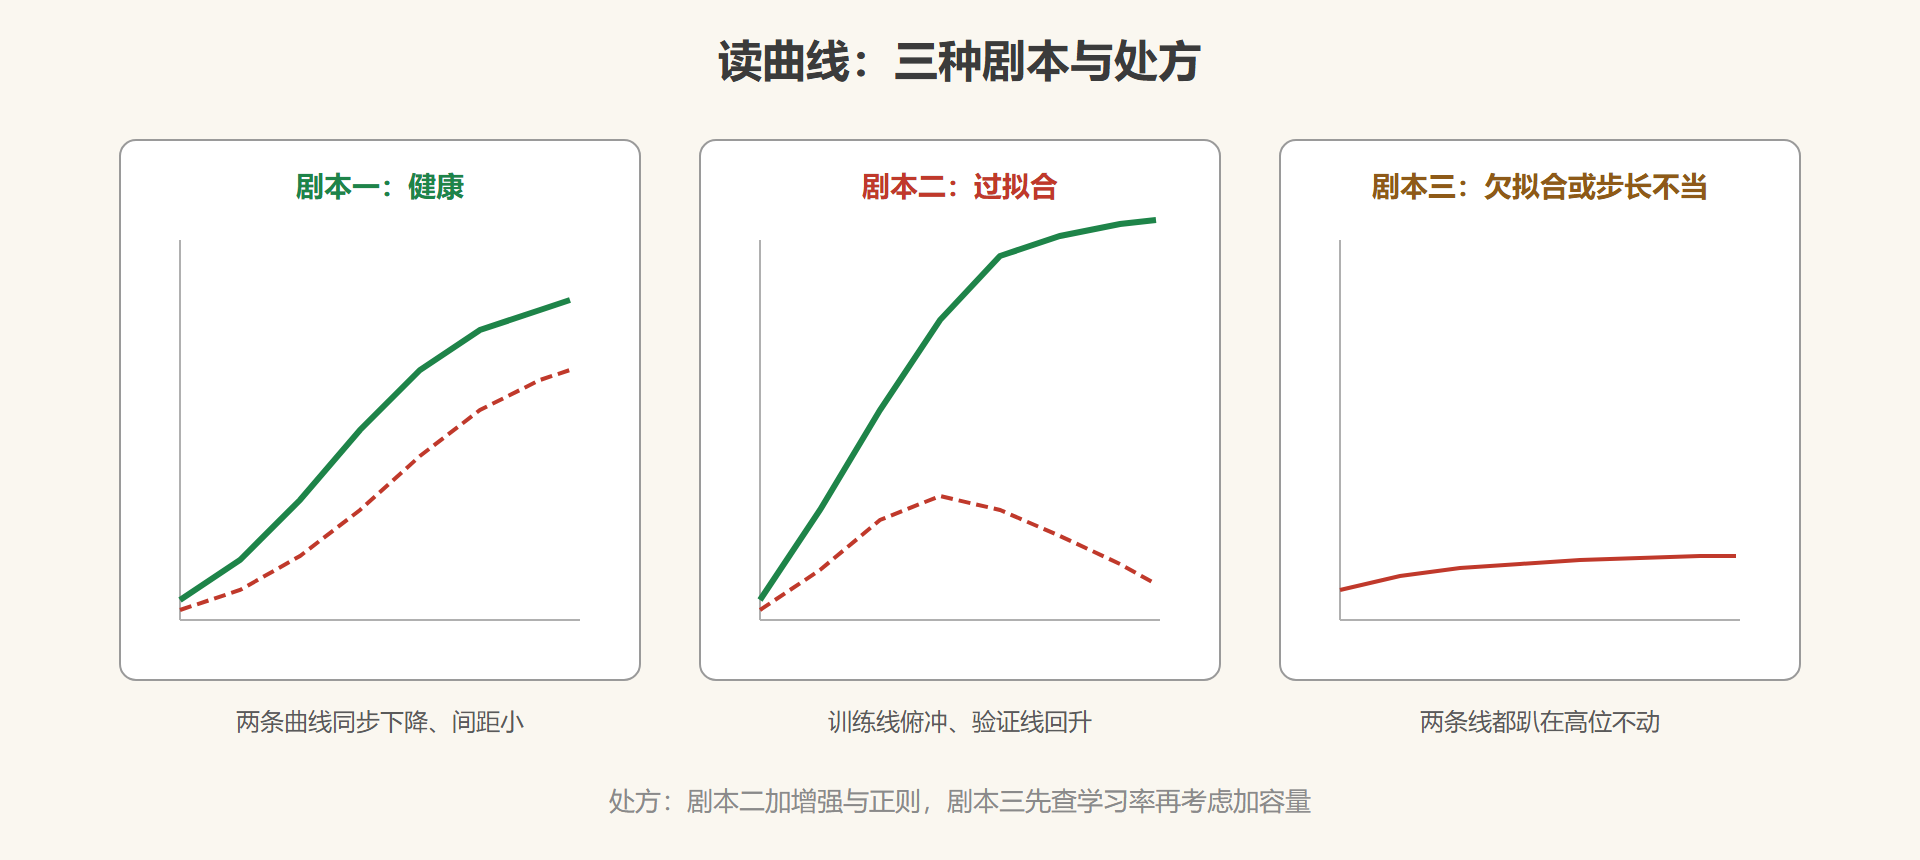
图 5-2 训练与验证曲线的三种剧本
二、结果、解读与变式
结果:同一套配方下,TinyCNN 与 ResNet-18 的典型落差清晰可辨——TinyCNN 五十个轮次收敛到七成五上下的测试准确率,ResNet-18 在增强加持下可达九成四五(公开复现的常见区间,具体数字随实现浮动一到两个点)。训练日志里健康曲线的画像见上图剧本一:两条线同步下降、间距稳定。
解读:三条线索值得写进每份报告。其一,骨干深度带来的差距(约二十个百分点)主要花在复杂纹理与部件组合上,符合 2.6 节感受野的推演;其二,逐类召回往往不均——猫狗互混是常态,把 4.8 节的混淆矩阵贴进报告,比一个总准确率有说服力得多;其三,若验证曲线从某轮开始抬头(剧本二),最优权重早停在抬头前一轮,这正是 4.6 节早停存在的意义。
变式:三条常用改造路线。数据再少一半,转 4.7 节迁移学习,ResNet-18 冻结换头仍能保住九成附近;要求上手机端,按 3.6 节换 MobileNet 骨干,算力降一个数量级、精度让一到两个点;误判代价不对称(如把猫判狗无所谓、把危险品判成日用品不行),在 4.1 节给损失加权或在验收端单设召回门槛。
巡检记录
- 组装顺序:数据、骨干、优化器、调度器、损失、循环——顺序本身就是排查清单;
- 评估三纪律:推理态、关梯度、逐类统计,缺一条验收单就有窟窿;
- 读曲线三剧本:健康、过拟合(验证回升)、欠拟合(双线趴高),各有固定处方;
- 报告规格:总准确率之外必须附混淆矩阵与逐类召回,9 成 5 的总分会掩盖某类 7 成的短板。
交付清单复用
把这次复盘沉淀成一张可复用的交付清单:数据侧——切分指纹、类别分布表、增强管线清单各一份;训练侧——最优权重、最终超参、学习率曲线截图;验收侧——总体指标、混淆矩阵、逐类召回、失败案例集(抽三十张误判图人工归因)。下次项目照单点验,缺哪栏补哪栏。清单的价值在于把"忘了看"变成"没得漏"——多数项目事故复盘出来,都是清单上某一栏没做,而不是哪个高深技巧不会。
💡 关键直觉:项目复盘的价值不在这次多少分,而在"每一步为什么这么配"。把本节每行代码的出处(对应章节)都写进你的工程注释,下一个数据集来了,你改的只是文件路径。
分类流水线到此完整落地。下一站给输出加一个维度:不但说"是什么",还要说"在哪"。