5.3 语义分割与实例分割:像素级阅卷
5.3 语义分割与实例分割:像素级阅卷
本节摘要:分割把"图里有什么"细化到每个像素各属什么类别:语义分割只问类别不问个体,实例分割在此基础上把每个个体分开。技术关键词是编码器-解码器与跳线融合——先把图压缩成特征再放大回原尺寸,浅层细节由跳线直送出口。指标换成交并比与 Dice,本节用一对小掩码把两者算到小数点。
像素级阅卷为什么难
把分类头换成"每个像素一个分类头",就得到分割的雏形。难在两头的矛盾:卷积流水线为了看懂语义不断压缩尺寸(32 倍下采样常见),而输出要与原图逐像素对齐。压缩丢掉的精度,得在解码端想办法还回来。还有一个更基本的坑:目标有大有小,只看深层特征,小物体早被池化抹没了。这两件事的解法——编码器-解码器结构与跳线——构成了这一节的主干。
学习目标
阅读完本节,你应当能够:
- 区分语义分割与实例分割的输出形态(两类狗:一类合并、一类分开);
- 画出编码器-解码器结构,解释跳线为什么是"细节直通车";
- 手算一对掩码的 IoU 与 Dice,并说出两者互换的公式关系;
- 知道 U-Net 与 Mask R-CNN 分别站在哪条技术线上。
一、编码器-解码器与跳线
流水线的压缩段(编码器)直接复用分类骨干;新的放大段(解码器)用转置卷积或插值逐级把特征图放回原尺寸,每放大一级就恢复一点空间细节。但压缩丢掉的细节不可能凭空复原——于是有了跳线:把编码器同分辨率的浅层特征直接接到解码器同级出口上拼接,细节不走压缩流程,抄近道直达。U-Net 把这条对称结构推到极致,医学影像几乎人手一份;DeepLab 系则用空洞卷积在不缩图的前提下扩大感受野,是另一条并行的路。
输出层的设计值得停留一秒:最后一层是 1×1 卷积,把每个像素的特征向量映射成类别分数——相当于"逐像素的分类头",softmax 沿类别维做,训练用的还是 4.1 节的交叉熵,只是统计口径从每张图一次变成每像素一次。
import torch import torch.nn as nn dec = nn.ConvTranspose2d(256, 128, kernel_size=4, stride=2, padding=1) x = torch.randn(1, 256, 14, 14) print(tuple(dec(x).shape)) # (1, 128, 28, 28):尺寸翻倍,交回给跳线拼接 head = nn.Conv2d(128, 21, kernel_size=1) # 逐像素 21 类打分(VOC 规格) feat = torch.randn(1, 128, 224, 224) print(tuple(head(feat).shape)) # (1, 21, 224, 224)
二、语义还是实例:两个词的分工
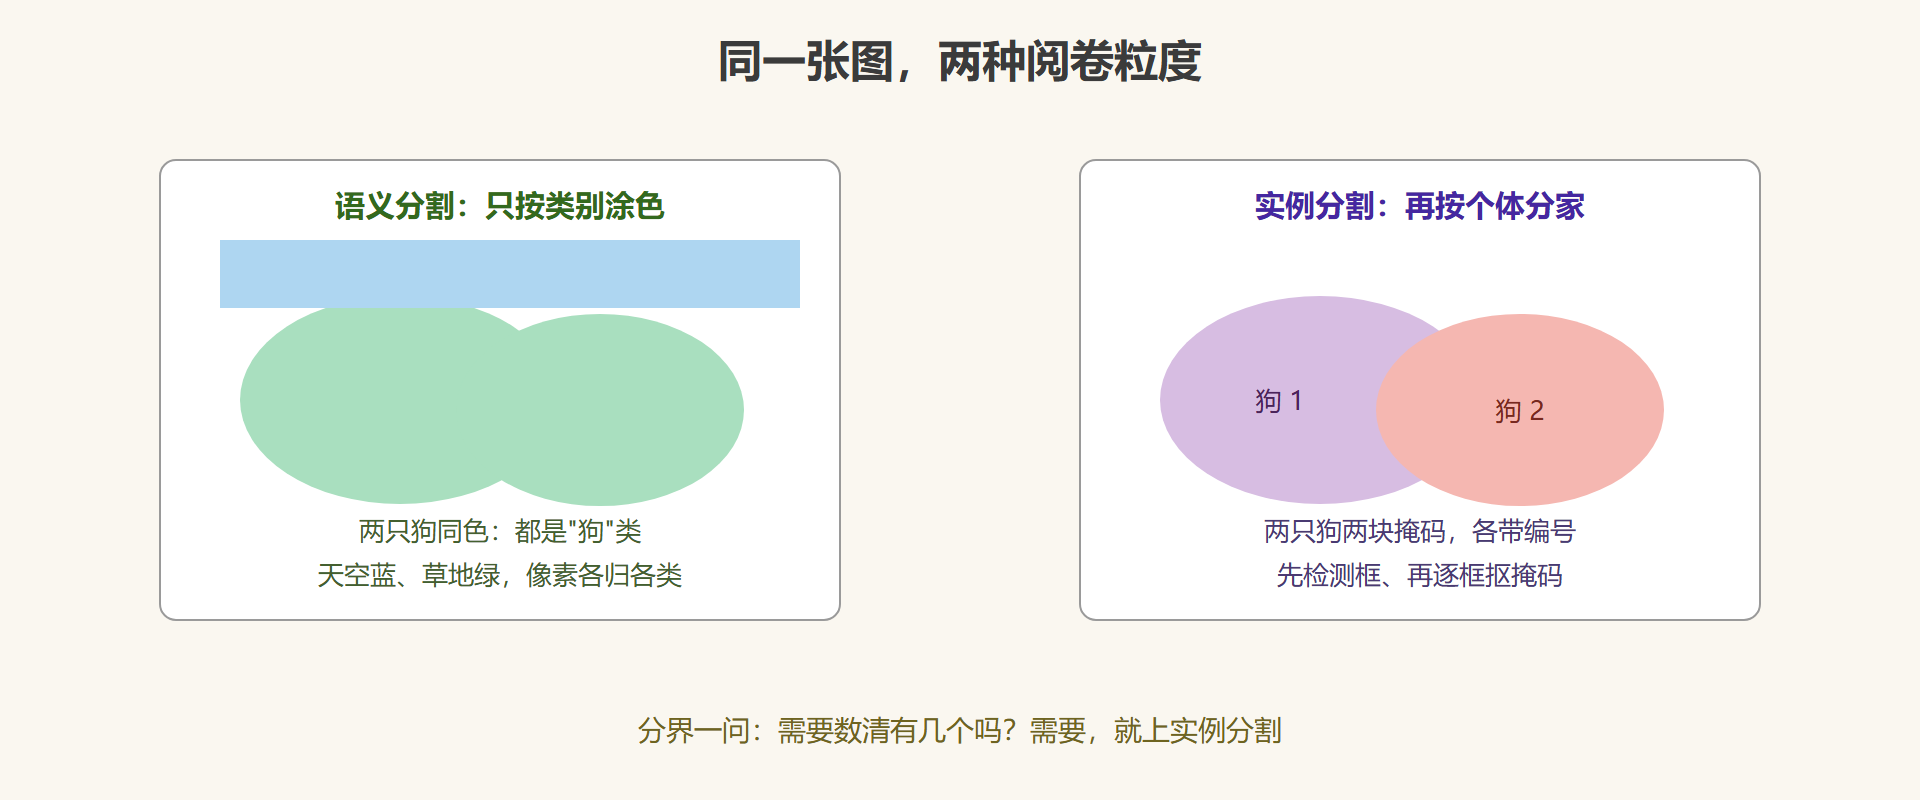
语义分割的输出是一张类别图:图里所有狗的像素同属"狗",两只并排的狗融为一体。实例分割在类别之上再加个体编号:两只狗各自一块掩码。技术分野也在这:语义分割是一张图一次推理的全卷积网络;实例分割的当家做法 Mask R-CNN 是"先检测后抠图"——按 5.2 节找出每个框,再在框内逐个生成掩码,把检测与分割串成两段。
掩码的验收口径与 5.2 节的 IoU 同源,只是对象从矩形变成像素集合。取一对可手算的小掩码(四乘四网格):
import torch truth = torch.zeros(4, 4, dtype=torch.bool) truth[1:4, 1:4] = True # 真值:右下 3×3,共 9 个像素 pred = torch.zeros(4, 4, dtype=torch.bool) pred[0:3, 2:4] = True # 预测:偏上 1 行的 3×2,共 6 个像素 tp = (truth & pred).sum().item() # 交集 fp = (~truth & pred).sum().item() # 误报 fn = (truth & ~pred).sum().item() # 漏报 iou = tp / (tp + fp + fn) dice = 2 * tp / (2 * tp + fp + fn) print("TP FP FN:", tp, fp, fn) # 4 2 5 print("IoU:", round(iou, 3)) # 0.364 print("Dice:", round(dice, 3)) # 0.533
交集只有四格(两块掩码重叠的左上角),误报两格(预测多出的顶行),漏报五格(真值左列与底行)。IoU = 4÷11 ≈ 0.364;Dice = 8÷15 ≈ 0.533,永远比 IoU 好看一点,两者可按 Dice = 2·IoU ÷ (1+IoU) 互换。分割论文与比赛常用逐类 IoU 的均值(mIoU)做总账;医学圈偏爱 Dice,因为它对"小目标漏一点"的惩罚更陡,与临床对漏诊的零容忍同频。
图 5-4 语义分割与实例分割的输出对比
追问两则
问:分割要不要处理类别不平衡?答:要,而且比分类更凶——背景像素常占九成以上,直接训练会让边界学得含糊;常用处方是给交叉熵按类加权,或换 Dice 损失直接优化重叠度,两者还能加权混用。问:上采样时的对齐参数是什么梗?答:插值与转置卷积都有"像素中心对齐与否"的口径差异,对不齐时输出掩码整体偏移一格,边缘指标全面失真——复现别人的结构时,这是最容易漏抄的参数。
巡检记录
- 粒度递进:分类给整图一个标签,检测给目标若干框,分割给每个像素一个标签;
- 结构钥匙:编码器-解码器负责"先看懂再还原",跳线把浅层细节抄近道送回出口,U-Net 是其集大成者;
- 输出层:1×1 卷积做逐像素分类,损失仍是交叉熵,口径从每图变成每像素;
- 指标手算:TP4、FP2、FN5 一组账给出 IoU 0.364 与 Dice 0.533,两者按固定公式互换;
- 分界一问:要数清个体数量就上实例分割(检测加抠图),只问类别归属用语义分割。
⚠️ 常见坑:训练分割时只做随机裁剪不做对齐校验,图像与掩码的裁剪参数不一致——特征在看左上角、标签在看右下角,损失降不下去还查不出原因。图像与标注必须共用同一套几何变换参数。
像素级阅卷封顶之后,还剩一条反向的路:不从像素提特征,而是从特征造像素。下一节反着走流水线。