6.2 可解释性与对抗样本:流水线的盲区
6.2 可解释性与对抗样本:流水线的盲区
本节摘要:CNN 的两个盲区一体两面:解释不了自己为什么对(可解释性),且会被肉眼看不见的扰动骗过(对抗样本)。本节给出归因可视化的两张常用底牌(显著图与 Grad-CAM),用可手算的线性样例演示 FGSM 攻击如何让打分翻转,并交代对抗训练这条主流防御线的思路。
一张贴纸引发的安全课
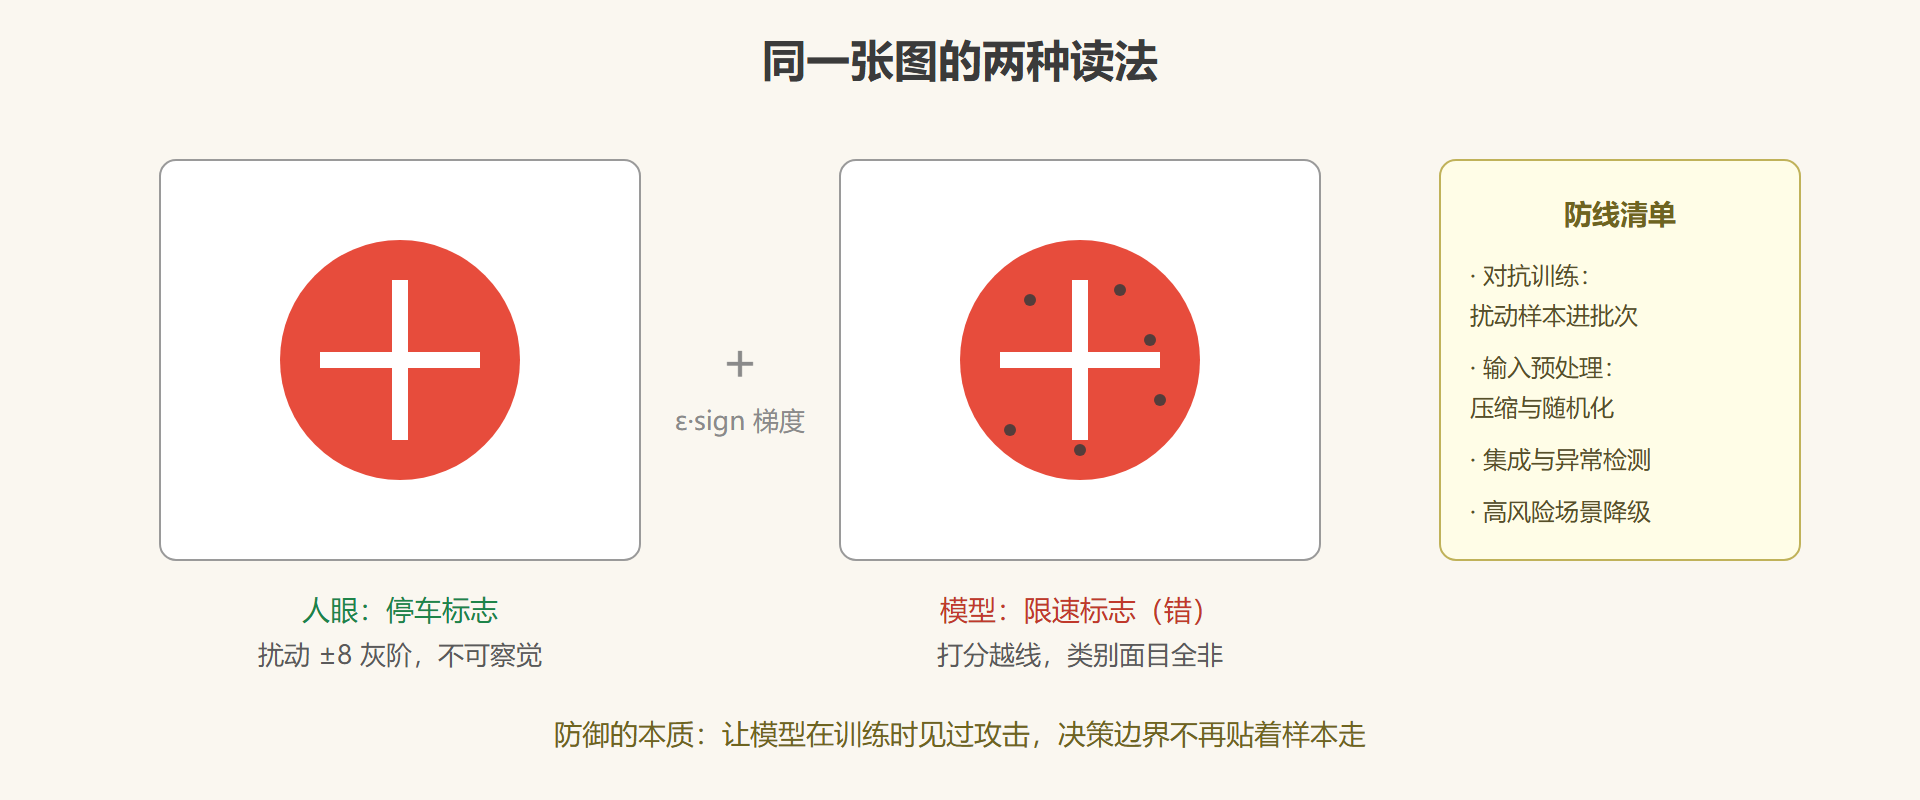
公开演示里出过这样的事:停车标志上贴几张特制小贴纸,人类眼中的停车标志分毫未变,检测系统却稳定地把它读成限速。扰动的幅度小到肉眼无感,模型却大错特错——这不是偶然故障,是高维线性行为的必然:特征空间里,"这批像素"离两个类别的决策边界本就近在咫尺,沿梯度方向轻轻一推就越线。理解攻击之前得先理解归因:模型到底在看哪里做判断?两问合起来,就是这一节的盲区地图。
学习目标
阅读完本节,你应当能够:
- 用显著图与 Grad-CAM 两种口径回答"模型在看哪里";
- 写出 FGSM 的一行公式,并在可手算的线性样例上让打分翻转;
- 解释扰动的可迁移性为什么让黑盒攻击成为现实威胁;
- 说清对抗训练的防御原理与它的代价。
一、归因:模型在看哪里
显著图是最直接的答案:对输入像素求损失梯度,梯度大的像素就是"动一动就会改判"的位置——它回答"看哪里敏感"。Grad-CAM 更进一步:取最后一个卷积层的特征图,按目标类别的梯度给各通道加权求和,得到一张粗粒度热力图——它回答"哪个区域支撑了这个判断"。两者口径不同:显著图是输入空间的显微镜,Grad-CAM 是特征空间的广角镜;前者逐像素、噪点密,后者块状清晰、适合放报告。诊断模型是否走捷径(比如靠背景水印认病),Grad-CAM 的热区一眼穿帮。
二、FGSM:一行公式的攻击
对抗攻击的基本思路顺理成章:训练时梯度指引参数往降低损失的方向走,攻击时同一个梯度指引像素往增大损失的方向推。最简版是 FGSM——沿梯度符号方向走一步:
对抗样本 = 原图 + ε × sign(损失对原图的梯度)
ε 是扰动预算,通常取 0.03 上下(对应 0 到 255 刻度里的 8 个灰阶)。整套攻击在一行梯度里完成,速度极快。用一个能全手算的线性样例看它的威力——"分类器"权重 w=(3, −2),输入 x=(0.1, 0.1),打分 w·x=+0.1,若以零为界,它属于正类:
import torch w = torch.tensor([3.0, -2.0]) # 线性分类器的权重 x = torch.tensor([0.1, 0.1], requires_grad=True) loss = -(w @ x) # 简化打分损失:越大越好则取负 loss.backward() print("原始打分:", round((w @ x).item(), 3)) # 0.1 print("梯度:", x.grad.tolist()) # [-3.0, 2.0] for eps in [0.01, 0.03, 0.05]: adv = (x + eps * torch.sign(x.grad)).detach() score = (w @ adv).item() print(f"ε={eps}: 打分 {round(score, 3)},{'已翻转' if score < 0 else '仍为正'}") # ε=0.01: 打分 0.05,仍为正 # ε=0.03: 打分 -0.05,已翻转 # ε=0.05: 打分 -0.15,已翻转
梯度是 (−3, 2),符号方向 (−1, 1);沿它走 ε 步,打分变为 0.1 − 5ε——ε 过了 0.02,符号就翻。真正的深度网络上这套把戏同样锋利:每个像素挪动不过几个灰阶,类别已经面目全非。更棘手的是可迁移性:替身模型上造出的扰动,扔给没见过的模型照样奏效——攻击者不需要你的权重,黑盒攻击因此从理论威胁变成工程现实。
图 6-2 对抗扰动:人眼无感,模型越线
交付时的解释纪律
把归因工具写进交付流程有三个固定动作。其一,抽样出热区图:从验证集按类抽十张,Grad-CAM 热区与目标主体的重合度人工判一遍,发现热区落在水印、边框等背景捷径上立即回炉数据。其二,把"模型看哪里"写进验收报告:比起一句"准确率九成四",热区图更能让业务方建立正确预期。其三,高风险场景的置信度阈值与人审流程先于上线定好——解释的终点不是好看的图,而是可执行的信任边界。
三、防御:让边界离样本远一点
对抗训练是防御线的支柱:每个批次里混入对当前模型生成的扰动样本一起训练,相当于告诉模型"这一带有人越线,把边界挪远"。效果实在,代价是干净数据上的精度略降、训练开销近翻倍,且只能防住训练时见过的攻击族。辅助手段各有分工:输入端的随机缩放、压缩降噪能磨掉扰动,但挡不住自适应攻击;多模型集成抬高攻击成本;安全攸关的系统则应假设模型迟早被骗——置信度低于阈值就转人工,物理世界的传感器冗余同理。安全设计的第一原则不是"模型不会被攻破",而是"被攻破时有兜底"。
追问三则
问:FGSM 之后为什么还有 PGD?答:FGSM 一步到位但容易"走过头",PGD 把那一步拆成多小步、每步后拉回预算球内,攻击更稳更强——防御评测的默认考题,对抗训练也应针对它。问:扰动在物理世界真的可行吗?答:可行——打印出来的对抗贴纸经镜头采样后仍保留大部分效力,停车标志、车道线都有公开复现案例,所以实体部署不是天然安全区。问:对抗样本与后门是一回事吗?答:不是,对抗样本是临时构造的输入扰动,后门是训练阶段埋进模型的机关(特定触发样式才激活);前者防在推理与训练配方,后者只能防在数据与供应链。
巡检记录
- 盲区同源:解释不了"为什么"与会被无感扰动欺骗,都是高维特征空间离决策边界太近的副产品;
- 归因双镜:显著图逐像素答"哪里敏感",Grad-CAM 按区域答"哪里支撑判断",验捷径用后者;
- FGSM 手算:线性样例里打分 0.1 减 5ε,ε 过 0.02 即翻转——一行梯度就是一次攻击;
- 迁移性:替身模型造的扰动可打黑盒,"对方拿不到我的权重"不构成防线;
- 防御定式:对抗训练为主、预处理为辅、系统集成兜底,安全靠降级预案而非模型无敌。
⚠️ 常见坑:把"测试集准确率 99%"当成安全证书。准确率衡量的是自然分布下的表现,对抗样本恰恰只活在人为构造的分布里——两件事各考各的,别互相背书。
模型会被骗,也可能"学错了原因",而根源常常在原料。下一节把数据集工程的质量关立起来。