6.4 CNN 之后:注意力时代的位次
6.4 CNN 之后:注意力时代的位次
本节摘要:视觉 Transformer(ViT)把图像切成图块当作词句,用全局注意力处理,在大数据上超越了 CNN 的精度天花板;但它吃数据、算力贵、缺归纳偏置,小数据与端侧场景 CNN 依然坚挺。本节讲清两者分水岭的一笔感受野账,用代码对出"图块化"的形状语言,最后给出一份务实的选型判断清单。
一场换地基的改造
2017 年 Transformer 在语言领域登顶后,研究者自然想问:视觉能不能也不再用卷积?2020 年 ViT 给出肯定答案,做法大胆得近乎粗暴:把 224×224 的图切成 14×14 份的 16×16 图块,每块拉平成一个向量当作一个"词",整张图变成一句 196 个词的"句子",交给标准的多头注意力处理。卷积的两条家传先验——局部连接与权值共享(1.2 节的立身之本)——被整体放弃,换来的能力也干脆利落:第一层就能让任意两个图块直接交换信息。
学习目标
阅读完本节,你应当能够:
- 用代码对出 ViT 的"图块化"形状语言:224 的图变成 196 个 384 维 token;
- 说清注意力与卷积的分水岭:感受野全局对局部,先验换数据;
- 复述 CNN 反击的三张牌(归纳偏置、算力效率、部署成熟度);
- 用一份判断清单决定自己的任务该站哪边。
一、分水岭:感受野的那笔账
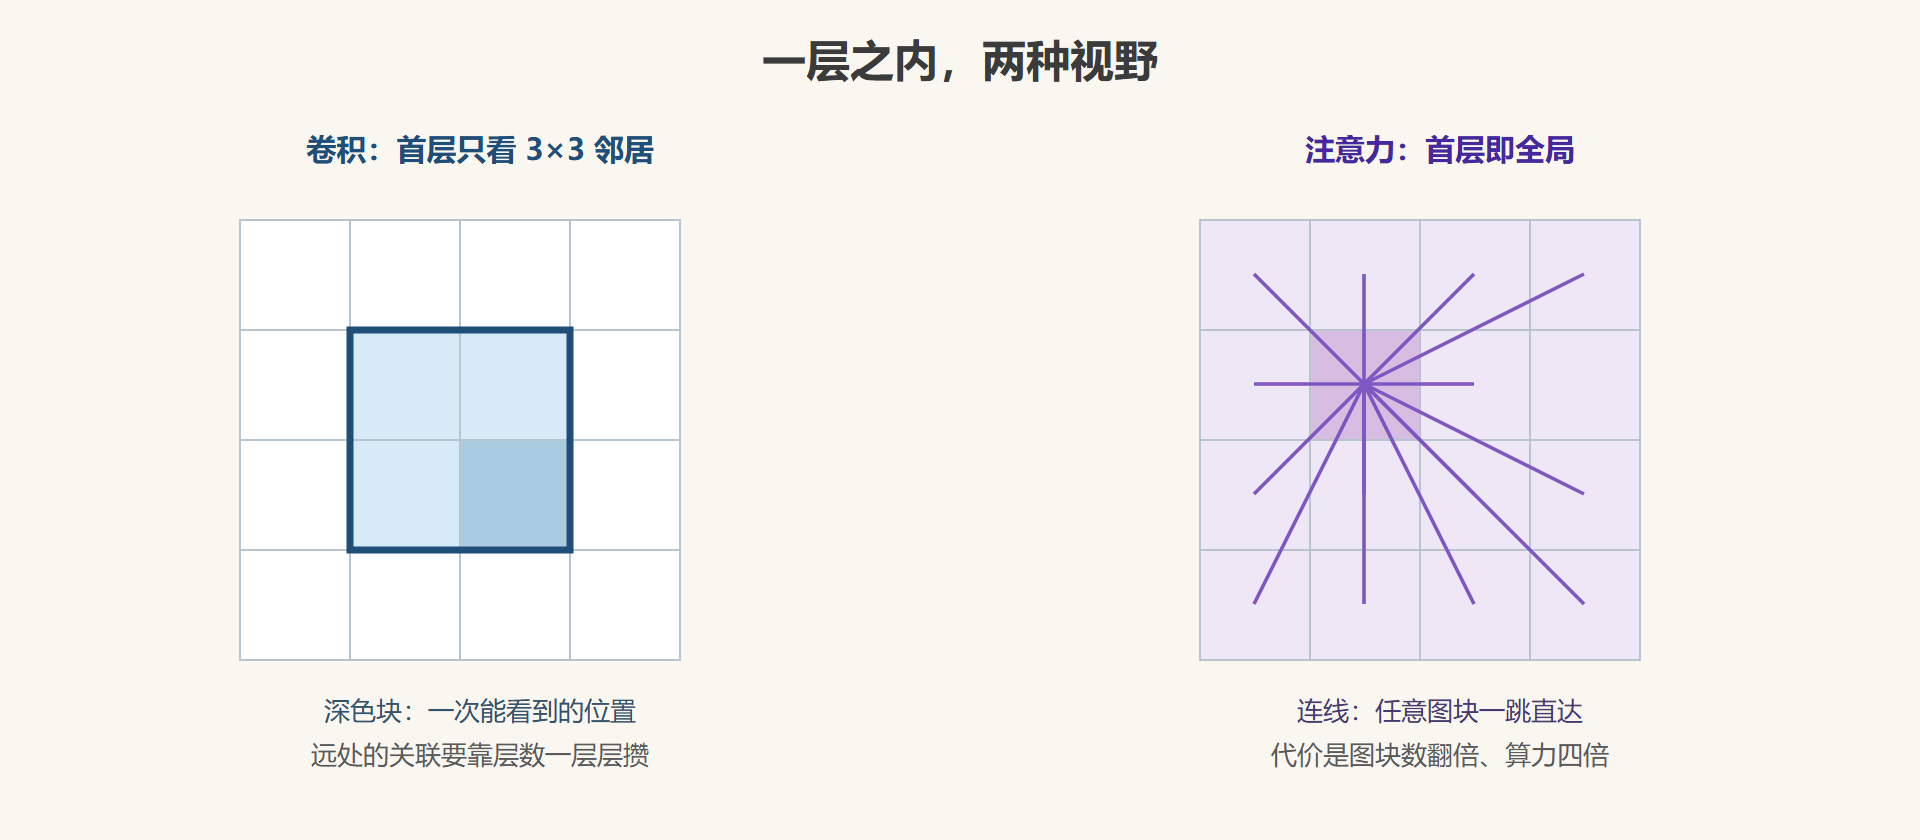
卷积的感受野要靠层深累积(2.2 节的累加账),ViT 的注意力一步到位:每个图块对全部 195 个同伴打分,任意两点的关联都是一跳直达。这笔感受野账的另一面是代价——没有"邻近相关"的先验,空间结构得全靠数据里学。ViT 在三百万张图的预训练量级才反超 CNN,数据少时反而不如 ResNet,原因正是归纳偏置的缺失;后续的 DeiT 用知识蒸馏把所需数据压了下来,也让"训练视觉大模型"的门槛下降了一截。
import torch import torch.nn as nn x = torch.randn(1, 3, 224, 224) patch = nn.Conv2d(3, 384, kernel_size=16, stride=16) # 图块化 = 步幅16卷积 tokens = patch(x).flatten(2).transpose(1, 2) print(tuple(tokens.shape)) # (1, 196, 384):196 个图块,每个 384 维 attn = torch.randn(1, 196, 196) # 注意力矩阵:每个图块对全体打分 print("每图块连接数:", attn.shape[2], "——卷积 3×3 核只有 9 个邻居") # 196
有个常被会心一笑的细节:图块化本身用的就是一次卷积(步幅 16、核 16 的Conv2d)。换地基没有拆掉所有旧砖——卷积仍是最高效的"切块工",只是不再承担全部的理解工作。两种视野的差别值得一图画清:
图 6-3 局部感受野对全局注意力
二、CNN 的反击与共处
ViT 登场没有让 CNN 出局,反而逼它进化。ConvNeXt 把 ResNet 逐项对照 Transformer 的设计翻新(更大的核、更少的激活层、分层的归一化),纯卷积的精度重新追平同级 ViT——证明那些家传先验本身没有过时。轻量化端侧战场上,注意力的平方复杂度(图块数翻倍,算力四倍)更是硬伤,MobileNet 一族的深度可分离卷积依旧是手机上的默认答案。现实格局是共处而非取代:云端大数据的精细识别与多模态基座用 ViT 系,端侧实时与小数据任务用 CNN 系,混血架构(浅层卷积加高层注意力)两头占便宜。
| 维度 | CNN | ViT |
|---|---|---|
| 感受野 | 逐层累积、局部先行 | 首层即全局 |
| 归纳偏置 | 局部性与平移等变内置 | 几乎没有,靠数据学 |
| 数据饥渴 | 中等(ImageNet 量级起步友好) | 大(需大规模预训练或蒸馏) |
| 复杂度 | 随像素数线性 | 随图块数平方 |
| 端侧生态 | 成熟(量化、加速器全面支持) | 追赶中 |
| 适合 | 小数据、实时、边缘设备 | 大数据、全局关系、多模态基座 |
三、选型清单与本册收束
给出一份可执行的判断清单。选 CNN 的信号:数据千到万级、要求端侧实时、部署目标是手机或嵌入式、任务以局部纹理为主(质检、门禁、美颜)。选 ViT 系的信号:有大规模预训练可用或数据百万级、任务依赖长程关系(文档版面、场景图)、要与语言模型做多模态融合。拿不准时:从 4.7 节的迁移学习起步,先 CNN 骨干打基线,再评估换 ViT 的收益是否值得翻倍的算力账。
回到本册的主线收束。全册跟着一张 32×32 的图走完了整条流水线:入线检查把它读成张量,主车间用卷积、激活、池化把它提炼成特征,六代机型档案给了你排布工位的六种哲学,质检回炉教会流水线"看对",出厂之后它学会定位、阅卷与生成,收尾站把工具、风险、数据与趋势收进工具箱。无论架构的地基换成什么,那两条对账公式与巡检的习惯——先算形状、再算参数、后算算力——会一直是工程师的乘法口诀。
追问两则
问:多模态大模型为什么清一色用注意力?答:文字、图像、音频的 token 都要放进同一个序列里交互,注意力的全局配对是天然接口,卷积的局部滑窗反而别扭——这不是卷积退步,是任务换到了它不占优的场地。问:ConvNeXt 到底改了哪些细节?答:把 ResNet 的大核化(7×7 深度卷积)、激活减层(每块一个 GELU)、归一化换位(LayerNorm 系)、通道倒置(倒瓶颈)逐项对齐 Transformer 的做法——纯卷积追平同级 ViT,说明先验的价值仍在,输的只是当年的细节配方。
巡检记录
- 分水岭一笔账:卷积首层 9 个邻居、靠深度攒视野;注意力首层 196 个全连接、视野直达全图;
- 代价换先验:放弃归纳偏置换全局能力,数据饥渴是 ViT 的入场费,蒸馏与大规模预训练是通行证;
- CNN 三张牌:先验、线性复杂度、成熟端侧生态——小数据与实时场景仍是默认答案;
- 图块化的幽默:ViT 的第一步是一次步幅 16 的卷积,旧砖没拆完,只是换了岗位。
💡 关键直觉:架构之争的实质是"先验换数据"的汇率问题。数据便宜时,买全局能力划算;数据昂贵时,内置先验的卷积依然是性价比之王——看清自己手里的数据与算力,比追逐架构名号重要。