7.2 CI/CD 流水线中的 Docker
7.2 CI/CD 流水线中的 Docker
本节摘要:让箱子自己排队进港——镜像在流水线里的完整旅程:构建、测试、扫描、推送、部署。本节讲各环节的容器化实践与缓存提速,并解释为什么"环境随镜像走"是 CI/CD 的最大红利。
流水线在解决什么
第二关:进流水线。没有流水线的团队,交付流程大致是:开发机上手工构建镜像、手工打标签、手工推送、登录服务器手工拉取重启——每一步都依赖人的记忆与自觉,且只在某个人的电脑上可复现。流水线的使命是把这条链变成机器执行的、每次提交自动触发的、结果可审计的标准作业。
Docker 与流水线是天生一对,原因一句话就能说透:交付物从"代码加安装步骤"变成"一只自包含的镜像"。流水线不再操心"测试环境的依赖装齐没有",它只搬运箱子——箱子在哪跑起来都一样,这正是全教程反复出现的主题第一次真正兑换成工程价值。
镜像的流水线旅程
一次典型交付中,镜像走五站。用一段通用的流水线配置描述(各平台的语法不同,阶段结构是相通的):
# 流水线阶段示意(伪语法,通用结构) stages: - build: # 第一站:构建 script: - docker build -t registry.example.com/team/myapp:${GIT_SHA} . - docker build -t registry.example.com/team/myapp:latest . - test: # 第二站:测试(在容器里测容器) script: - docker run --rm registry.example.com/team/myapp:${GIT_SHA} npm test - scan: # 第三站:安检(上一节的纪律) script: - trivy image --exit-code 1 --severity HIGH,CRITICAL \ registry.example.com/team/myapp:${GIT_SHA} - push: # 第四站:推送上堆场 script: - docker push registry.example.com/team/myapp:${GIT_SHA} - docker push registry.example.com/team/myapp:latest - deploy: # 第五站:部署(下一节展开) script: - ssh deploy@staging "cd /srv/myapp && docker compose pull && docker compose up -d"
五个关键设计决策藏在里面,逐个说透。先把五站的闸口关系画出来:
图 7-3:流水线五站——镜像的进港通道
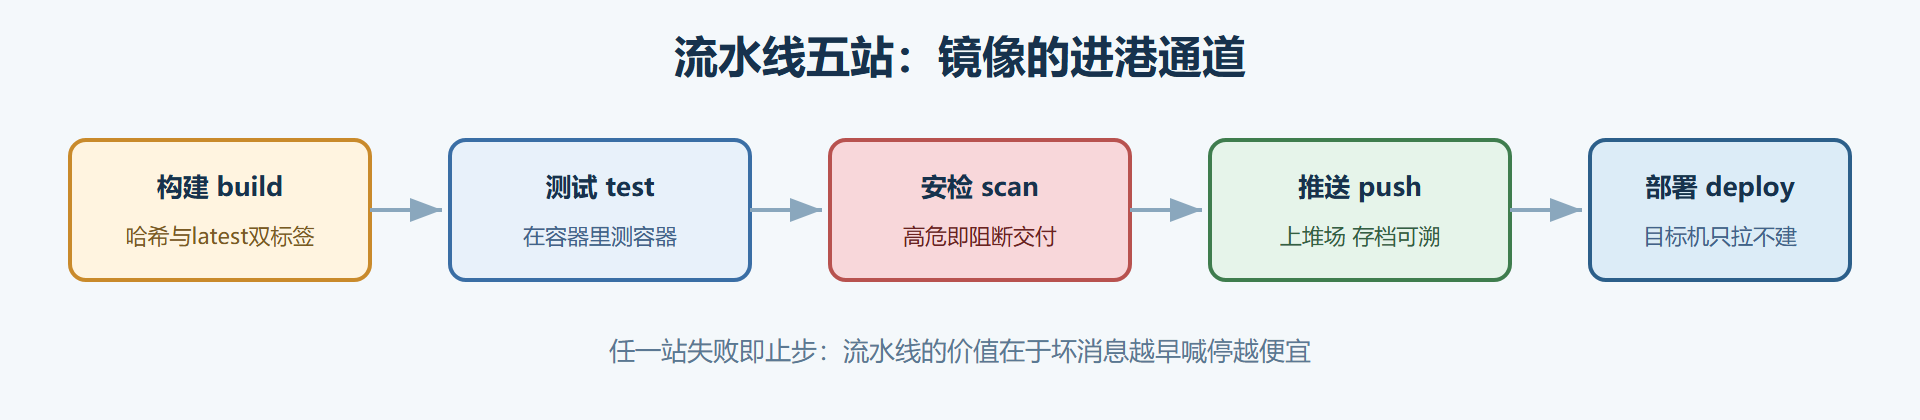
五个关键设计决策逐个说透。
标签用提交哈希(GIT_SHA):每个构建产物有唯一可追溯的版本号,任何线上箱子都能反查到确切代码版本——7.3 节版本管理的基石。测试在容器里跑:用刚构建的镜像直接跑测试,测的就是要交付的东西,不存在"测的装的不是一个环境"。扫描是硬关卡(--exit-code 1):高危漏洞让流水线直接失败,7.1 的安检纪律落成机器执行。双标签推送:哈希标签永久指向本次构建,latest 指向最新——latest 只是便利别名,部署永远可以钉在哈希上。部署是拉取加重建:目标机器只做"拉新货、换箱子",不在生产环境构建(生产构建是纪律红线,原因见下)。
构建缓存:流水线的速度密码
流水线每几十分钟跑一次,构建缓存的价值被成倍放大。好消息:第 3.3 节的层缓存在流水线里依然有效,但需要显式管理——流水线执行器通常是干净环境,本地层缓存不存在。解法是把缓存外挂:
# 流水线中的缓存化构建:用上一轮的镜像当缓存源 docker build \ --cache-from registry.example.com/team/myapp:latest \ -t registry.example.com/team/myapp:${GIT_SHA} . # 上一轮推送的镜像被当作缓存源:依赖层命中,只有新代码层真正重建 # 或者用引擎的缓存挂载( BuildKit 特性,适合同机执行器) docker buildx build \ --cache-to type=local,dest=/cache/myapp \ --cache-from type=local,src=/cache/myapp \ -t registry.example.com/team/myapp:${GIT_SHA} .
缓存从分钟级构建到秒级命中,取决于装箱单的顺序纪律——第 3.3 节"稳定指令在上、易变指令在下"在流水线场景的收益最大,因为它直接兑换成每次提交的等待时间。
流水线里的引擎安全也顺带交代一句:流水线执行器持有的是"能起吊任何箱子"的强权限,因此构建机本身要当作高价值资产对待——不跑来源不明的镜像、不开放执行器接口、定期轮换堆场推送凭证。流水线提速与加固的手感,等你接入真实的持续集成平台后自然会长出来,本节先立好结构认知。
生产不构建:一条纪律红线
流水线设计有一条反直觉红线值得单独立牌:生产服务器不构建镜像。原因有三:构建过程吃资源(编译是宿主机的重负载,与线上业务抢配额);构建不可控(生产机器上的构建上下文、缓存状态都是变量,产物不可追溯);安全面扩大(源码、密钥、构建工具链出现在生产机上)。正确分工:流水线(或专用构建机)造货、堆场存货、生产只拉货起吊。三.5 节自建的私有堆场,就是这条流水线的中转枢纽——交付物经由堆场单向流动,每个环节可审计。
# 部署端的标准动作就两条(compose 场景) docker compose pull # 从堆场拉新版本 docker compose up -d # 重建有变化的箱子(6.3 节的差异计算自动完成)
顺带把五站与值班视角连起来:每次提交后的流水线日志,就是这批货的随船单据——哪个哈希、过了哪几站、何时放行,全部落档。线上出事回溯时,"这箱货当初怎么进来的"不再靠谁的记忆,调日志便是。
本节要点回顾
- 流水线五站:构建、测试(在容器里测)、扫描(硬关卡)、推送(双标签)、部署(只拉不建)。
- 环境随镜像走是 CI/CD 最大红利:测的就是要交付的,环境差异从根上消失。
- 标签用提交哈希保证可追溯;latest 只是别名,部署可钉在哈希上。
- 流水线缓存要显式管理:cache-from 或本地缓存挂载;装箱单顺序纪律收益最大。
- 红线:生产不构建——流水线造货、堆场存货、生产拉货起吊,单向可审计。
箱子自动进港了。下一节定班期:部署节奏、环境晋升与出事后的退路。