7.4 故障排查与性能优化
7.4 故障排查与性能优化
本节摘要:第四关:应急预案。从告警到定位的分诊五步法、容器场景的特有故障模式(OOM 循环、可写层膨胀、泊位冲突)、性能优化的优先级排序。本节是前六章排障知识的总演习。
排障要的是路径,不是运气
告警响了,值班员的差别不在知识量,在有没有固定路径。乱翻一气的人靠运气,按分诊流程走的人靠体系。本节先把五步法立起来,再用它实战演练三个容器特有的故障模式,最后谈性能优化的优先级。
图 7-2:故障分诊五步法
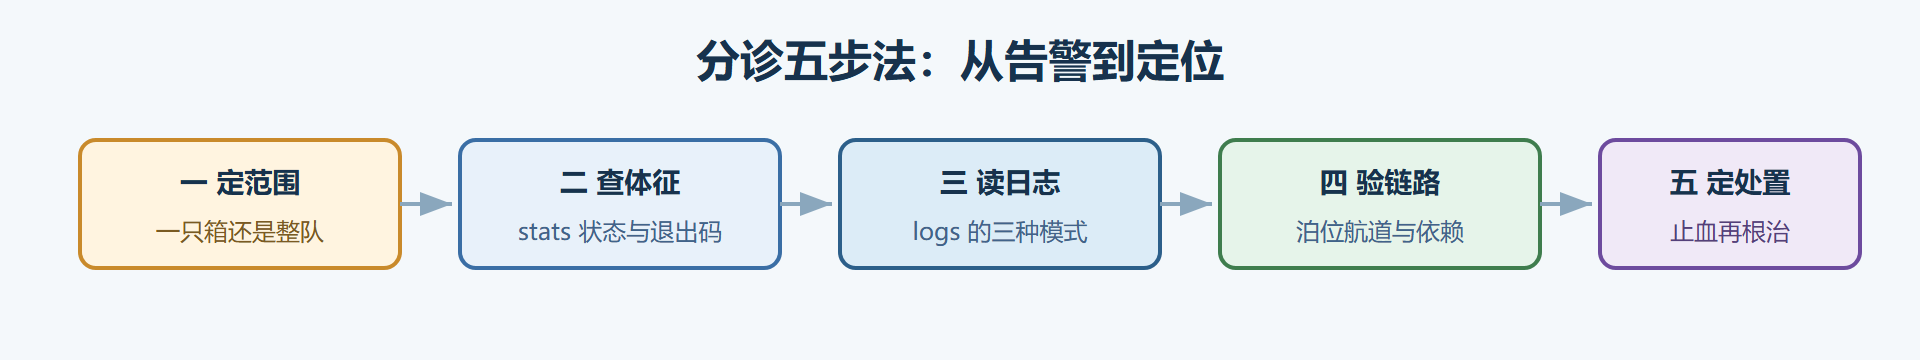
五步法演练:应用无响应
拿值班最常见的告警实战——"接口超时"。第一步定范围:是单箱还是整队?编队名册先看一眼:
# 第一步:编队与容器状态总览 docker compose ps # SERVICE STATUS # web Up 2 hours # db Restarting (1) 3 seconds ago <- 异常信号:数据库在重启循环! # cache Up 2 hours # 第二步:查异常箱子的体征与死因(重启循环必看退出码) docker inspect web-fleet-db-1 --format "OOMKilled: {{.State.OOMKilled}} ExitCode: {{.State.ExitCode}} 重启次数: {{.RestartCount}}" # OOMKilled: true ExitCode: 137 重启次数: 27 # 数据库内存超限被内核反复终结 -> 重启策略反复拉起 -> 重启循环
第三步读日志找超限原因:
# 第三步:数据库箱子的最后日志(找超限前的行为) docker compose logs --tail 30 db # 输出(节选): # db-1 | LOG: duration: 8213.412 ms statement: SELECT ... 全表扫描查询 # db-1 | WARNING: out of memory ... (频繁出现) # 全表扫描叠加连接堆积,工作内存撑破了 512m 的配额
第四步验链路确认影响面(应用本身健康,只是连不上数据库),第五步定处置:先止血——临时调大配额让服务恢复;再根治——那条全表扫描查询加索引或限流。处置代码各就各位:
# 止血:在线调大配额(4.5 节的 update 手法) docker update --memory 1g --memory-swap 1g web-fleet-db-1 # 根治在应用侧:优化查询、限制连接数;配额回退到合理值 # 事后补一笔运维账:stats 的内存告警阈值(八成)本可以提前一小时预警
五步走完,从告警到处置闭环。注意这套打法全部由前六章的零件组装:状态与退出码(第 4 章)、配额与 update(第 4 章)、编队日志(第 6 章)、stats 阈值(第 4 章)——排障能力是体系化学习的直接产出。
容器特有故障三模式
模式一:OOM 循环。 症状是 Restarting 状态与递增的重启次数,死因一律查 137。根因通常两类:配额拍脑袋设小了(对照压测核定),或应用内存泄漏(曲线持续爬坡不回落)。区分两者看 stats 的曲线形态。
模式二:可写层膨胀。 症状是宿主机磁盘悄悄吃满、写入越来越慢。根因是把高频写入(日志、缓存、临时文件)留在了可写层。验证与处置:
# 查看容器的可写层体积(几乎为 0 才健康) docker ps -s # NAMES SIZE ... # log-hog 8.4GB (virtual 8.5GB) <- 可写层 8.4GB:病入膏肓 # 处置:日志与缓存目录外挂卷或 tmpfs,重建箱子 docker rm -f log-hog docker run -d --name log-hog --tmpfs /tmp -v logdata:/var/log/app log-hog:1.0
模式三:泊位冲突。 症状是起吊直接失败,报端口占用。根因是宿主机端口已被别的进程(或忘了清理的旧箱子)占用:
# 起吊失败现场(错误示例) docker run -d -p 8080:80 nginx:1.25-alpine # Error ... port is already allocated # 查泊位占用:先看引擎的箱子们,再查宿主机进程 docker ps --format "{{.Names}}\t{{.Ports}}" | grep 8080 docker ps -a --filter status=exited --format "{{.Names}}" # 惯犯常是没清理的旧箱
三个模式之外,把"现场保护"单独立一条值班纪律:止血之前先留证。重启能恢复的故障,先花一分钟把关键现场抓下来——容器日志导出、inspect 快照、events 时间窗——再动手止血。现场没了,根因分析就成了盲猜,同一故障大概率会再来一遍。导出动作两条命令的事:
# 止血前抓现场:日志落盘 + 状态快照 docker logs --since 1h order-api > order-api-$(date +%H%M).log docker inspect order-api > order-api-inspect-$(date +%H%M).json # 然后放心重启、回滚、扩容——证据在手,事后可查
性能优化的优先级
优化按投入产出排序,容器场景的顺序通常固定:第一,资源配额是否合理(配额虚高浪费宿主、虚低频繁 OOM,用 stats 曲线校准);第二,日志与 I/O 落点(高频写必须外挂,禁写可写层);第三,镜像体积与启动速度(小镜像拉取快、起吊快,弹性场景直接兑换扩容速度);第四,才是应用内部优化——那是语言与框架的课题,不是容器的。顺序背后的逻辑:容器层的优化是"结构调整",一次到位长期受益;应用层优化是"持续工程",两者别互相替代。给一个省事的自检口径:stats 曲线、ps -s 的可写层体积、images 的尺寸清单,三张表每周扫一眼——数值都在合理区间(阈值对照 4.5 的配额核定与 3.4 的体积基线),容器层就不必再动手。
本节要点回顾
- 分诊五步法:定范围、查体征、读日志、验链路、定处置;先止血再根治。
- OOM 循环查 137 与重启次数;配额虚低与内存泄漏靠 stats 曲线形态区分。
- 可写层膨胀查 ps -s 的 SIZE 列;高频写外挂卷或 tmpfs 是处方。
- 泊位冲突先查引擎箱子再查宿主进程;惯犯常是没清理的停止容器。
- 优化顺序:配额、I/O 落点、镜像体积,最后才是应用内部——结构优于局部。
应急预案齐了。最后一站,眺望航线尽头:自动化港区之门。