5.1 数据工程与大数据开源项目
5.1 数据工程与大数据开源项目
本节摘要:2026 年的数据工程正在经历两场变革:表格式层面,Apache Iceberg 正在成为开放标准,挑战 Delta Lake 和 Hudi;处理引擎层面,Flink 的流处理能力被越来越多团队采用,"流批一体"从口号变成现实。与此同时,dbt 引领的"SQL 优先"数据转换范式继续扩张,数据治理和可观测性成为新焦点。
本节地图
阅读完本节,你应当能够:
- 对比 Iceberg/Delta Lake/Hudi 三大表格式
- 理解"流批一体"的实际含义和 Flink 的角色
- 评估 dbt 在数据团队中的价值
- 设计一条现代数据处理管线
一、问题与直觉
传统数据架构有一条清晰的管线:数据源 → ETL → 数据仓库 → BI 报表。简单、可控、但慢。
2026 年的数据架构更像一张网:数据从几十个来源实时流入数据湖,流处理引擎同时做清洗、转换和特征计算,dbt 在数据仓库里做进一步的聚合,BI 工具和 AI 模型同时消费处理后的数据。
复杂性上去了,但灵活性也上去了。关键是选对工具。
二、核心原理
开放表格式对比
| 维度 | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
| 发起方 | Netflix | Databricks | Uber |
| 核心优势 | 开放中立、Schema 演进、时间旅行 | Spark 深度集成、ACID | 增量处理、Upsert 高效 |
| 引擎兼容 | Spark/Flink/Trino/Presto | 主要 Spark | 主要 Spark |
| 社区治理 | Apache 基金会 | Linux Foundation | Apache 基金会 |
| 2026 趋势 | 成为事实标准 | 仍广泛但中立性受质疑 | 特定场景优势 |
💡 关键直觉:Iceberg 的崛起不是因为技术最好,而是因为治理最中立。Databricks 把 Delta Lake 放在 Linux Foundation 试图挽回信任,但 Iceberg 已经获得了 Snowflake、Apple、Netflix 等巨头的背书。
处理引擎选型
| 引擎 | 定位 | 适合 |
|---|---|---|
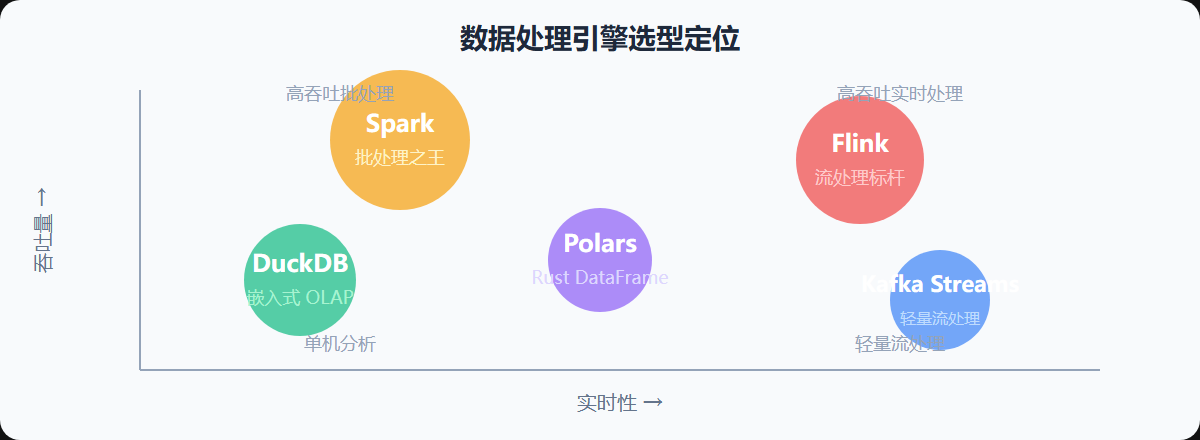
| Apache Spark | 批处理为主,微批流处理 | 大规模 ETL、数据转换 |
| Apache Flink | 真正的流处理 | 实时管线、事件驱动、CDC |
| Apache Kafka Streams | 轻量流处理 | 基于 Kafka 的简单流处理 |
| DuckDB | 嵌入式 OLAP | 本地分析、数据工程个人工具 |
| Polars | Rust DataFrame 库 | 单机高性能数据处理 |
dbt:SQL 优先的数据转换
dbt(Data Build Tool)让数据分析师用 SQL 就能完成数据转换工作,不需要写 Python/Java ETL 代码。它在 2026 年已经成为数据团队的标配。
| 特性 | 说明 |
|---|---|
| SQL 转换 | 用 SELECT 语句定义转换逻辑 |
| 依赖管理 | 自动解析模型间的依赖关系 |
| 数据测试 | 内置数据质量测试框架 |
| 文档生成 | 自动从 SQL 生成数据目录 |
| 血缘追踪 | 端到端的数据血缘可视化 |
数据可观测性
2026 年的新焦点。数据管线越来越复杂,"数据质量"不再是"跑个 SQL 检查一下"就能保证的。
| 项目 | 定位 |
|---|---|
| Great Expectations | 数据质量验证框架 |
| Monte Carlo | 数据可观测性平台 |
| OpenMetadata | 开源数据治理平台 |
| DataHub (LinkedIn) | 元数据管理平台 |
图:数据处理引擎选型定位图
三、工程实践要点
现代数据栈推荐组合
| 层次 | 推荐 |
|---|---|
| 数据湖 | Iceberg + S3/MinIO |
| 流处理 | Flink |
| 批处理 | Spark |
| 数据转换 | dbt |
| 编排 | Airflow / Dagster |
| 数据质量 | Great Expectations |
| 元数据管理 | DataHub |
⚠️ 常见坑:不要同时引入太多工具。数据栈的复杂度是真实成本。从核心需求出发:Spark + dbt + Airflow 就能覆盖 80% 的场景。
Iceberg 时间旅行:一段 SQL 看懂表格式的价值
湖仓一体不是营销词,核心是表格式带来的能力。Iceberg 把表拆成元数据层和数据层:每次写入生成新的元数据快照,老快照保留,因此天然支持时间旅行和快照隔离。用一段 SQL 感受一下:
-- 看某个时间点的数据 SELECT * FROM orders FOR SYSTEM_TIME AS OF '2026-06-01 00:00:00'; -- 回滚到某个快照 CALL iceberg.system.rollback_to_snapshot('orders', 1234567890); -- 增量读取,供下游增量消费 SELECT * FROM orders WHERE _snapshot_id IN (SELECT * FROM orders.snapshots ORDER BY committed_at DESC LIMIT 2);
这三段查询在传统数据湖上要么做不到、要么极其昂贵。时间旅行让"数据出错了可以回到过去修",增量读取让流批一体的"批"也能被流式消费。这也是 Iceberg 在 2026 年成为开放表格式事实标准的原因——能力是具体的,不是概念。
流处理的三个关键概念
Flink 让流处理走向主流,但"流"的心智模型和批完全不同。三个概念必须先建立。事件时间(Event Time)指数据真正发生的时间,而不是到达系统的时间,乱序数据要靠 Watermark 声明"到此为止,等不到更晚的数据了";恰好一次(Exactly-once)语义保证故障恢复后不重不漏,代价是状态存储和事务协调;状态(State)让流算子记住历史,但状态规模要监控,无界增长会拖垮任务。初学流处理最常见的错误,是把批处理的窗口概念直接搬过来,结果聚合结果永远对不上数。
CDC:让数据库变更变成流
数据要实时,第一个问题是"数据库的变更怎么出来"。CDC(变更数据捕获)工具监听数据库日志,把 INSERT、UPDATE、DELETE 变成消息流。Debezium 是这个领域的事实标准,配合 Kafka 把数据库变更接入下游——数仓增量同步、缓存刷新、搜索引擎索引更新都能实时化。落地注意三点:表必须开启相应日志配置;DDL 变更会导致流结构变化,需要订阅机制处理;回放旧数据要做初始快照,别让新订阅的消费组从空状态开始。CDC 不是银弹,但"实时数仓"几乎都从它开始。
向量数据库与 AI 数据管线
数据工程的下游多了一个新消费者:AI 模型。RAG 应用需要把文档切成块、算成向量、存进向量库,这给数据团队带来两个新任务:一是嵌入管线的调度与版本管理(文档更新后要重算向量,模型换版本要全量重嵌);二是向量库的运维(Milvus、Chroma、pgvector 各有取舍,见第二章)。数据团队和 AI 团队在 2026 年边界越来越模糊,建议把"文档→切块→嵌入→入库"当成一条标准数据管线来建设,用现成的编排器调度,而不是在应用代码里临时拼装。
数据工程的常见翻车点
最后集中列几个高频事故。一是"源表结构变了,下游全崩":元数据管理和表结构评审要前置,Iceberg 的 Schema 演进能缓解但不能代替流程。二是"重复跑任务把事实表刷脏":任务要设计成幂等,dbt 模型用增量物化加唯一键去重。三是"数据质量检查形同虚设":质量规则要绑定到发布流程,失败即阻断,而不是只发告警。四是"时间分区用错时区":分区字段必须统一用 UTC 或明确时区,跨时区团队最容易在这里翻车。五是"小文件爆炸":频繁的小任务写入会生成海量小文件,压缩(Compaction)策略要配置好,否则查询性能断崖下跌。每一条都是真实生产环境反复出现过的教训。
一节小结
- Iceberg 正在成为开放表格式标准:中立治理是关键优势
- Flink 让流处理走向主流:实时管线选 Flink,大规模批处理选 Spark
- dbt 改变了数据转换范式:SQL 优先,数据分析师也能做 ETL
- 数据可观测性是新焦点:Great Expectations + DataHub 组合
- 克制引入工具的冲动:Spark + dbt + Airflow 覆盖 80% 场景
数据工程讲完了,下一节看区块链——剥离投机泡沫后,真正有技术价值的部分。