3.1 并发模型概述:CSP 与调度台哲学
3.1 并发模型概述:CSP 与调度台哲学
本节摘要:并发是程序结构,并行是执行方式;Go 站在 CSP 一边,主张"通过通信共享内存"。本节厘清这两组概念,并用同一任务的两版实现对比锁式与传话式写法。它是本章的世界观底座,后面每一节都是这个立场的具体化。
本章开工。开工前先回答一个反问:夜班的活,凭什么要拆给几个人干?因为单人串行时,一段等待就是整条线的空转;拆开之后,等待与计算可以交叠,吞吐才上得来。但拆开只是起点——拆开的人怎么协作、怎么不互相踩脚,才是并发编程的真问题。本节把"怎么协作"的两大流派摆上台面,Go 选了其中一边,并把它做成了语法。
并发与并行:设计图与施工现场
这两个词经常被混用,工程上必须分清:并发是结构概念——程序被组织成多个可独立推进的执行流,哪怕单核上它们也只是交错执行;并行是执行概念——多个执行流在同一时刻真的跑在不同的核心上。Go 的官方口吻很精辟:并发关乎结构,并行关乎执行。你设计出并发的结构,运行时自会利用多核把它跑成并行,写代码的人不必操心核数。
对排班而言:把夜班拆成收货、质检、入库三个岗位是"并发设计";当晚恰好有三台机器同时开动是"并行执行"。设计正确的岗位划分,才能在任何规模的场地里都跑得顺。
两种世界观:抢钥匙还是递纸条
任务拆开后,协作方式只有两大流派。
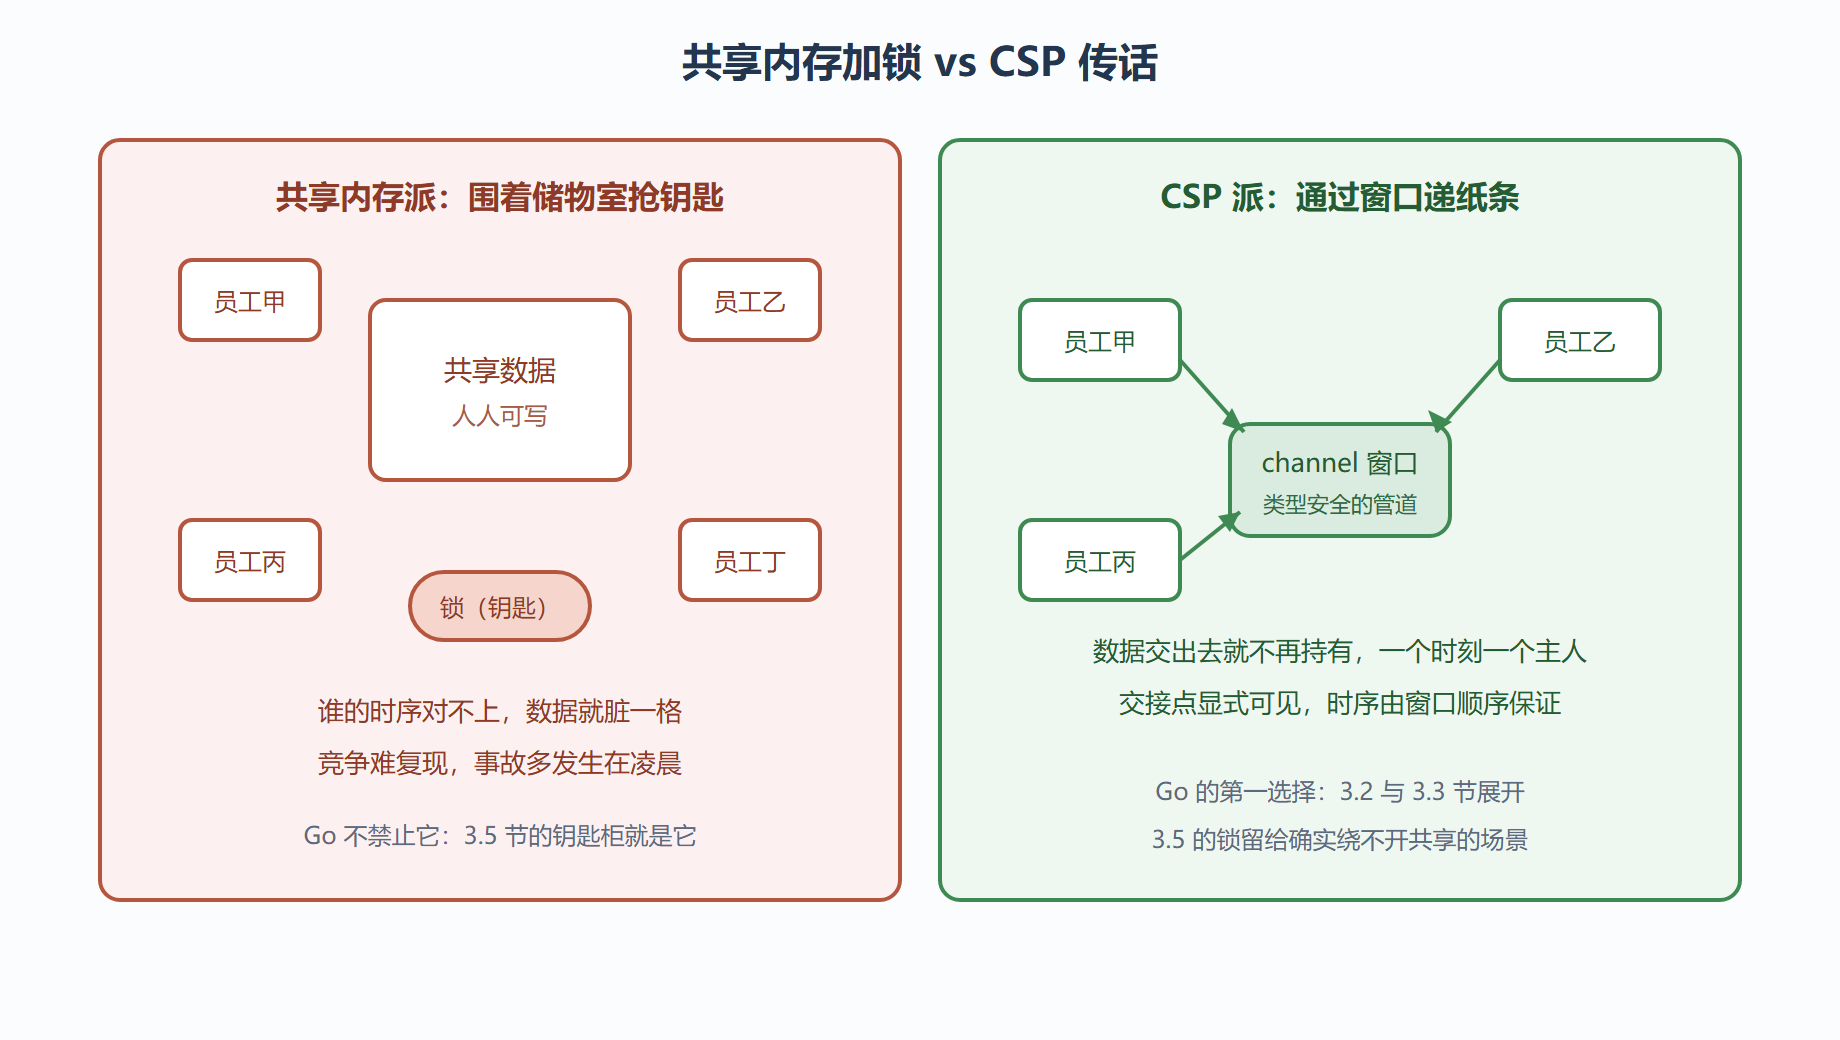
共享内存派:所有员工围着一间储物室干活,进出要先领钥匙(锁)。它直接、性能好,但钥匙管多了吞吐垮,管漏了就是数据竞争——错误往往藏在千分之一的交错里。
CSP 派(通信顺序进程):员工各干各的,需要交接时通过窗口递纸条(channel)。数据在任一时刻只有一个持有人,交接即转移所有权,抢都没得抢。Go 的官方立场一句话:不要通过共享内存来通信,而要通过通信来共享内存。
图 3-1:两种协作模型的对照
同一任务的两版实现
用"汇总多个员工的上报数值"这个任务,把两大流派写出来对比:
package main import ( "fmt" "sync" ) // 版本一:共享内存派。计数器被所有员工抢着改,必须上锁 func countWithLock(reports []int) int { total := 0 var mu sync.Mutex var wg sync.WaitGroup for _, r := range reports { wg.Add(1) go func(val int) { defer wg.Done() mu.Lock() // 没有这把锁,累计结果就会出错 total += val // 临界区:同一时刻只允许一人改 mu.Unlock() }(r) } wg.Wait() return total } func main() { reports := []int{3, 5, 7, 9} fmt.Println("锁式汇总:", countWithLock(reports)) } // 运行输出: // 锁式汇总: 24
package main import ( "fmt" "sync" ) // 版本二:CSP 派。员工只向窗口交纸条,total 只属于主 goroutine func countWithChannel(reports []int) int { results := make(chan int) // 无缓冲窗口,后面细讲 var wg sync.WaitGroup for _, r := range reports { wg.Add(1) go func(val int) { defer wg.Done() results <- val // 交完纸条即收工 }(r) } go func() { wg.Wait() // 等所有人交完 close(results) // 再关窗口,range 循环才能自然结束 }() total := 0 for v := range results { // 主 goroutine 独自累计,天然无竞争 total += v } return total } func main() { reports := []int{3, 5, 7, 9} fmt.Println("传话式汇总:", countWithChannel(reports)) } // 运行输出: // 传话式汇总: 24
两版结果一致,结构气质迥异。锁版的关键正确性藏在 mu.Lock() 那一行,漏掉就是数据竞争,且肉眼难查;传话版的正确性写在结构里——累计变量只被主 goroutine 碰,根本没有竞争可言。Go 鼓励第二版的理由正在于此:把正确性做进数据流方向,而不是做进纪律。
顺序从哪里来:给并发一点可见性常识
并发程序里,"谁先谁后"不再由代码行序直接决定。两条基本事实够用很久:同一 goroutine 内,语句按书写顺序执行;跨 goroutine 的可见性,必须靠同步原语建立——channel 的发送发生在对应的接收完成之前,WaitGroup 的 Done 发生在 Wait 返回之前。换句话说,没有经过窗口的共享,双方看到的值互相不作保证。这是 3.3 节阻塞规则的另一种读法,也是第 4 章竞态调查的理论底。
完整案例:统计多个文件的行数
背景:值班交接要统计几十个日志文件的行数,串行扫描要几十秒,交接会迟到。
操作:为每个文件派一个 goroutine 并行扫描,各自把结果发进结果窗口;主 goroutine 只负责收纸条汇总。
package main import ( "fmt" "strings" ) // countLines 模拟扫描:真实场景换成按行读取文件即可 func countLines(name, content string, out chan<- int) { out <- len(strings.Split(content, "\n")) // 只发结果,不碰共享变量 } func main() { logs := map[string]string{ "app.log": "a\nb\nc", "sys.log": "x\ny", "audit.log": "z", } out := make(chan int, len(logs)) // 缓冲恰好装下全部结果 for name, content := range logs { go countLines(name, content, out) } total := 0 for range logs { total += <-out // 收满 n 张纸条 } fmt.Println("总行数:", total) } // 运行输出: // 总行数: 6
结果:总行数与串行版一致,耗时从"文件数乘以单文件耗时"降到接近"最慢单文件的耗时"。
解读:注意结构里没有任何锁——每个 goroutine 只读自己的入参、只写窗口,汇总权归主 goroutine 独享。单向窗口类型 chan<- int 还在签名里约束了员工只能发不能收,权限表达进参数,误用编译不过。这正是 3.1 的哲学在 3.3 的语法落地。
变式:文件数涨到几千时,无节制开 goroutine 会把句柄与内存打爆——正确做法是固定数量的员工循环领活(工作池模式),它是 4.1 节的第一个主角。带着这个问题进入下一节最合适不过:goroutine 到底便宜到什么程度,开多少才算"无节制"?
收班要点
- 并发是结构,并行是执行;Go 让你只管设计结构,运行时负责多核并行。
- 共享内存靠锁维护纪律,CSP 把正确性做进数据流;Go 的第一选择是后者。
- 同一 goroutine 内按序执行;跨 goroutine 可见性必须由 channel、锁等同步原语建立。
- 传话式结构里,"一个时刻一个主人"消灭了竞争而非压制了竞争。
- 单向窗口类型把收发权限写进函数签名,约束力来自编译器。
观念立住了。下一节把员工本体请上场:goroutine 怎么启动、怎么死、为什么敢开几万个。