4.2 刻在石头上的字:String与StringBuilder
4.2 刻在石头上的字:String 与 StringBuilder
本节摘要:String 是不可变对象——一旦创建内容终身不改,所有"修改"方法都返回新串;字符串常量池让相同字面量共享一份对象。== 比引用、equals 比内容,字面量与 new 出来的对象在两种比较下结果不同。循环拼接要用 StringBuilder,它内部是可扩容的字符数组,避免每次拼接都产生新串。本节实测三种拼接方式的耗时差异。
修改一个字符串,到底修改了什么
先做一个小实验,看 String 的"修改"背后发生了什么:
public class ImmutableDemo { public static void main(String[] args) { String s = "登记"; s.toUpperCase(); // 看似把 s 改成大写 System.out.println(s); // 输出:登记 —— s 纹丝没动 s = s + "完成"; // 看似给 s 追加内容 System.out.println(s); // 输出:登记完成 String t = "abc"; String t2 = t.replace('a', 'X'); System.out.println(t); // 输出:abc 原串不变 System.out.println(t2); // 输出:Xbc 返回的是新串 } }
第一组:toUpperCase 返回了新串,但没人接住,白算一遍,s 还是原样。第二组:s = s + "完成" 之所以"看起来改了",是因为 s 这个引用改指向了一个新建的串,旧串"登记"还躺在内存里。String 的任何"修改"操作——拼接、替换、截取、转大小写——一律返回新对象,原对象终身不变。这就是不可变(immutable),第 1 章 1.4 节提过的 final 类围墙在这里兑现:String 是 final 类,不能被继承,内部字符数组也不对外暴露,谁都无法从外部篡改内容。
为什么要这么设计?三个硬理由。安全:类加载的类名、网络连接的路径、文件路径大量用 String 传递,内容若能被改,安全防线形同虚设。共享:不可变对象可以放心共享——常量池正是建立在这个前提上。哈希稳定:String 常被用作 Map 的键(第 5 章),内容不变则哈希值可以缓存起来一次计算反复用。
常量池:同一句话只刻一块碑
public class PoolDemo { public static void main(String[] args) { String a = "户籍"; // 字面量 进常量池 String b = "户籍"; // 同一字面量 命中池中同一块碑 String c = new String("户籍"); // 显式 new 强制在堆里新建对象 System.out.println(a == b); // 输出:true 池中同一对象 System.out.println(a == c); // 输出:false 堆里另起的对象 System.out.println(a.equals(c)); // 输出:true 内容相同 String d = "户籍" + "科"; // 编译期常量折叠 直接得到池里的 户籍科 String e = "户籍科"; System.out.println(d == e); // 输出:true 折叠后与字面量同源 String f = a + "科"; // 含变量的拼接 运行期生成新对象 System.out.println(f == e); // 输出:false 新对象不进池 System.out.println(f.intern() == e); // 输出:true intern 把串登记进池再返回池内对象 } }
图 4-2 字符串常量池与堆上的对象
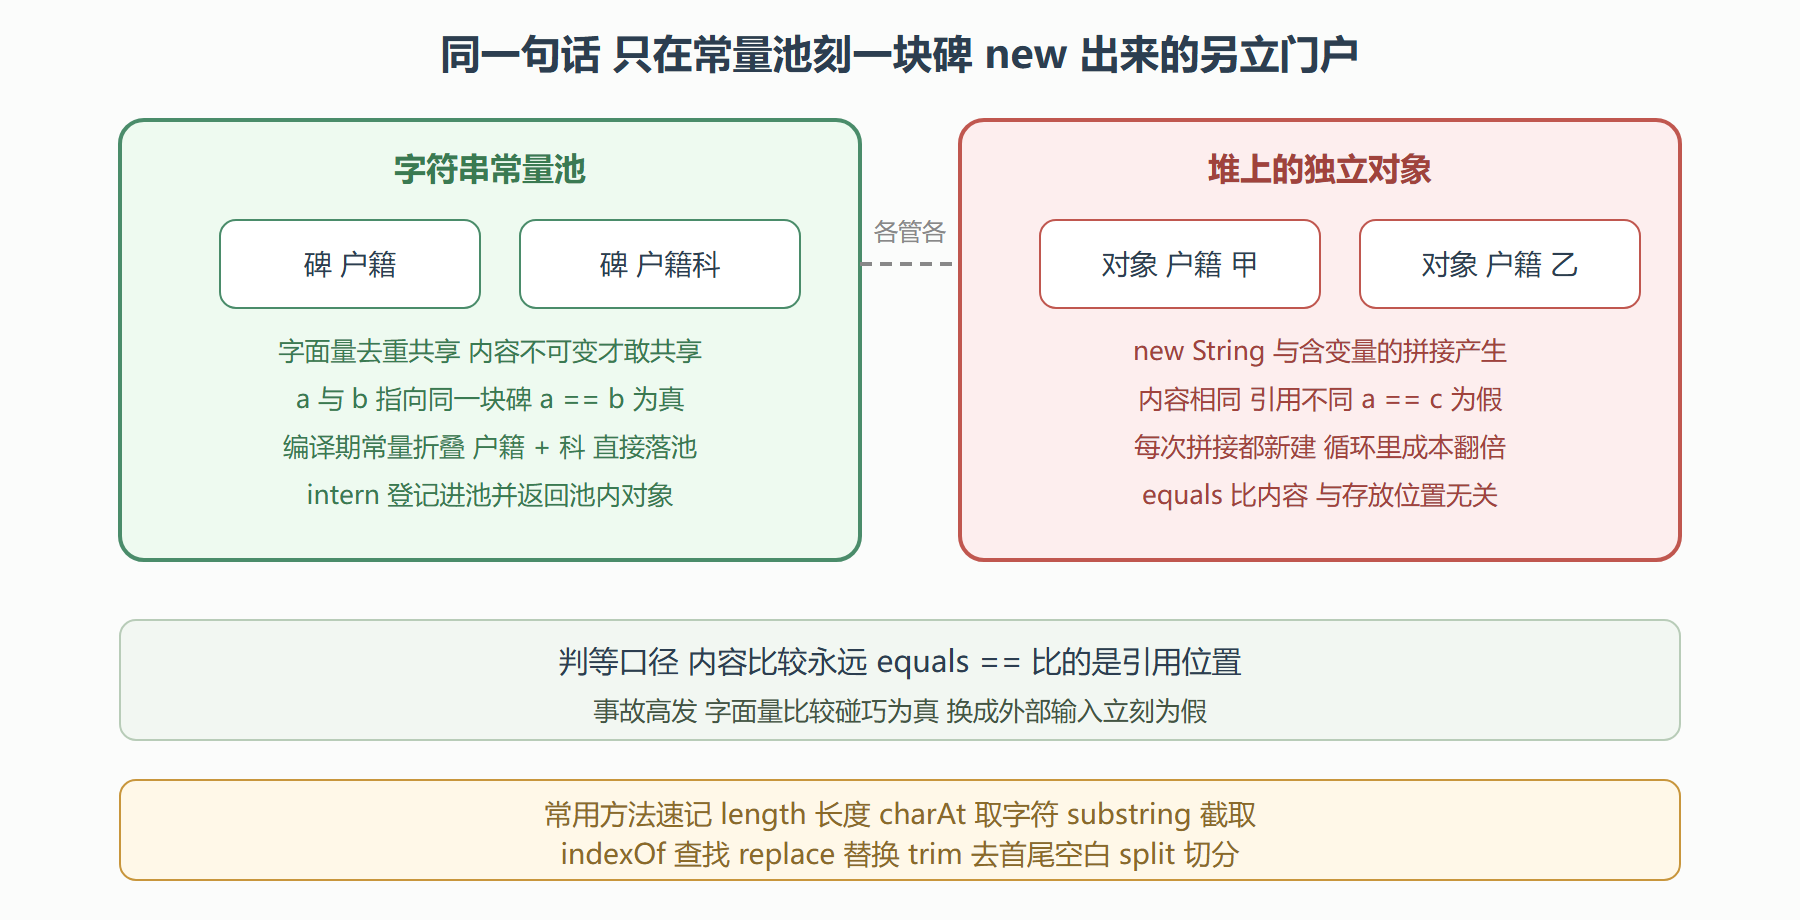
这张图配上 PoolDemo 的七行输出,== 的行为规律就齐了:两个字面量比引用通常为真(同一块碑);字面量与 new 出来的比必为假;含变量的拼接结果不进池。工程结论只有一条:判内容用 equals,== 的结果依赖对象存放位置,那是编译器与池的私事,不该写进业务逻辑。.trim、isEmpty、startsWith 这些常用方法见图下方速记行。
循环拼接:石头与草稿纸的耗时账
不可变的代价在拼接上最明显:s = s + x 每次都新建字符串对象,新旧串在内存里堆成一座山。背景:日志模块要把一万条记录拼成一个大串导出。操作:三种写法各跑一遍,统计耗时:
public class ConcatBench { public static void main(String[] args) { int n = 10000; long t1 = System.currentTimeMillis(); String s = ""; for (int i = 0; i < n; i++) s = s + i; // 写法一:String 直接加 long t2 = System.currentTimeMillis(); StringBuilder sb = new StringBuilder(); // 写法二:StringBuilder 草稿纸 for (int i = 0; i < n; i++) sb.append(i); String s2 = sb.toString(); long t3 = System.currentTimeMillis(); StringBuffer sf = new StringBuffer(); // 写法三:StringBuffer 同步版 for (int i = 0; i < n; i++) sf.append(i); long t4 = System.currentTimeMillis(); System.out.println("String 拼接耗时毫秒:" + (t2 - t1)); // 实测量级:数百毫秒 System.out.println("StringBuilder 耗时毫秒:" + (t3 - t2)); // 实测量级:个位数毫秒 System.out.println("StringBuffer 耗时毫秒:" + (t4 - t3)); // 略慢于 StringBuilder System.out.println("结果长度一致:" + (s.length() == s2.length())); // 输出:true } }
结果:三种写法结果完全一致,但 String 直接拼接比 StringBuilder 慢一到两个数量级(机器不同数字不同,量级差稳定)。解读:String 循环拼接每轮新建对象并复制全部旧内容,n 轮的复制总量是平方级;StringBuilder 内部是一个可扩容的字符数组,append 只在数组尾部写入,扩容时按大约翻倍增长,总量接近线性。变式:循环次数只有十来次时,两者差异可忽略,直接加号反而可读性最好——少量拼接用加号、循环拼接用 StringBuilder,这是判断的全部;若能预估总长度,new StringBuilder(预估容量) 传入初始容量可再省掉扩容拷贝。
StringBuffer 与 StringBuilder 的唯一差别是前者给每个方法加了同步、线程安全但单线程白付同步开销,多线程共享同一个拼接缓冲才需要它——实际场景罕见,多数"多线程拼接"其实是各线程各用各的 StringBuilder,最后再合并。
本节要点回顾
- String 不可变:所有修改方法返回新串,原串终身不变;final 类与私有字符数组是围墙,安全性、共享、哈希稳定是三大回报
- 常量池按内容去重:字面量共享一块碑,new 与含变量的拼接另立门户;intern 可把串登记进池
- 判等内容用 equals:== 依赖对象存放位置,字面量场景碰巧为真、换成运行期输入立刻翻车
- 拼接选型一句话:少量用加号、循环用 StringBuilder、预估容量更省、多线程共享缓冲才用 StringBuffer
- 平方级与线性级的差距:String 循环拼接复制总量平方级,StringBuilder 尾部追加接近线性——实测稳定差一到两个数量级
字符串是单个住户的账,下一节看大厅里三个公用窗口:System 计时与数组搬运、Math 取整与随机、Objects 空安全——它们不登记对象、随叫随到。