5.1 货架总览与List登记队列
5.1 货架总览与 List 登记队列
本节摘要:集合框架分两大谱系——Collection 单件货架(List、Set、Queue)与 Map 门牌索引柜,Map 不继承 Collection。List 是有序可重复的登记队列,ArrayList 底层动态数组、随机访问快,LinkedList 底层双向链表、头尾插删快。本节先读谱系图,再实测两种实现的四组操作差异,最后讲 for-each 背后的迭代器与遍历中改结构的禁忌。
先把货架图读对
数组有两条先天短板:长度定死、删中间元素要整体挪动。集合框架就是 JDK 给的成套替代品,但它的谱系常被读错,先把三个层级关系钉死:顶层 Iterable(能被 for-each 遍历的总资格);中层 Collection(单件货架的总规范:增、删、查、大小);底层三大分支——List(有序可重复)、Set(不可重复)、Queue(排队处理)。Map 是独立谱系,存的是键值对而不是单件,所以它不在 Collection 之下——但它与 Set 关系密切(5.3 节展开)。第 3 章的三层设计在这里兑现:List 接口定契约、抽象骨架类装通用实现、ArrayList 与 LinkedList 各管存储结构。
图 5-1 集合框架两级谱系与工具房货架
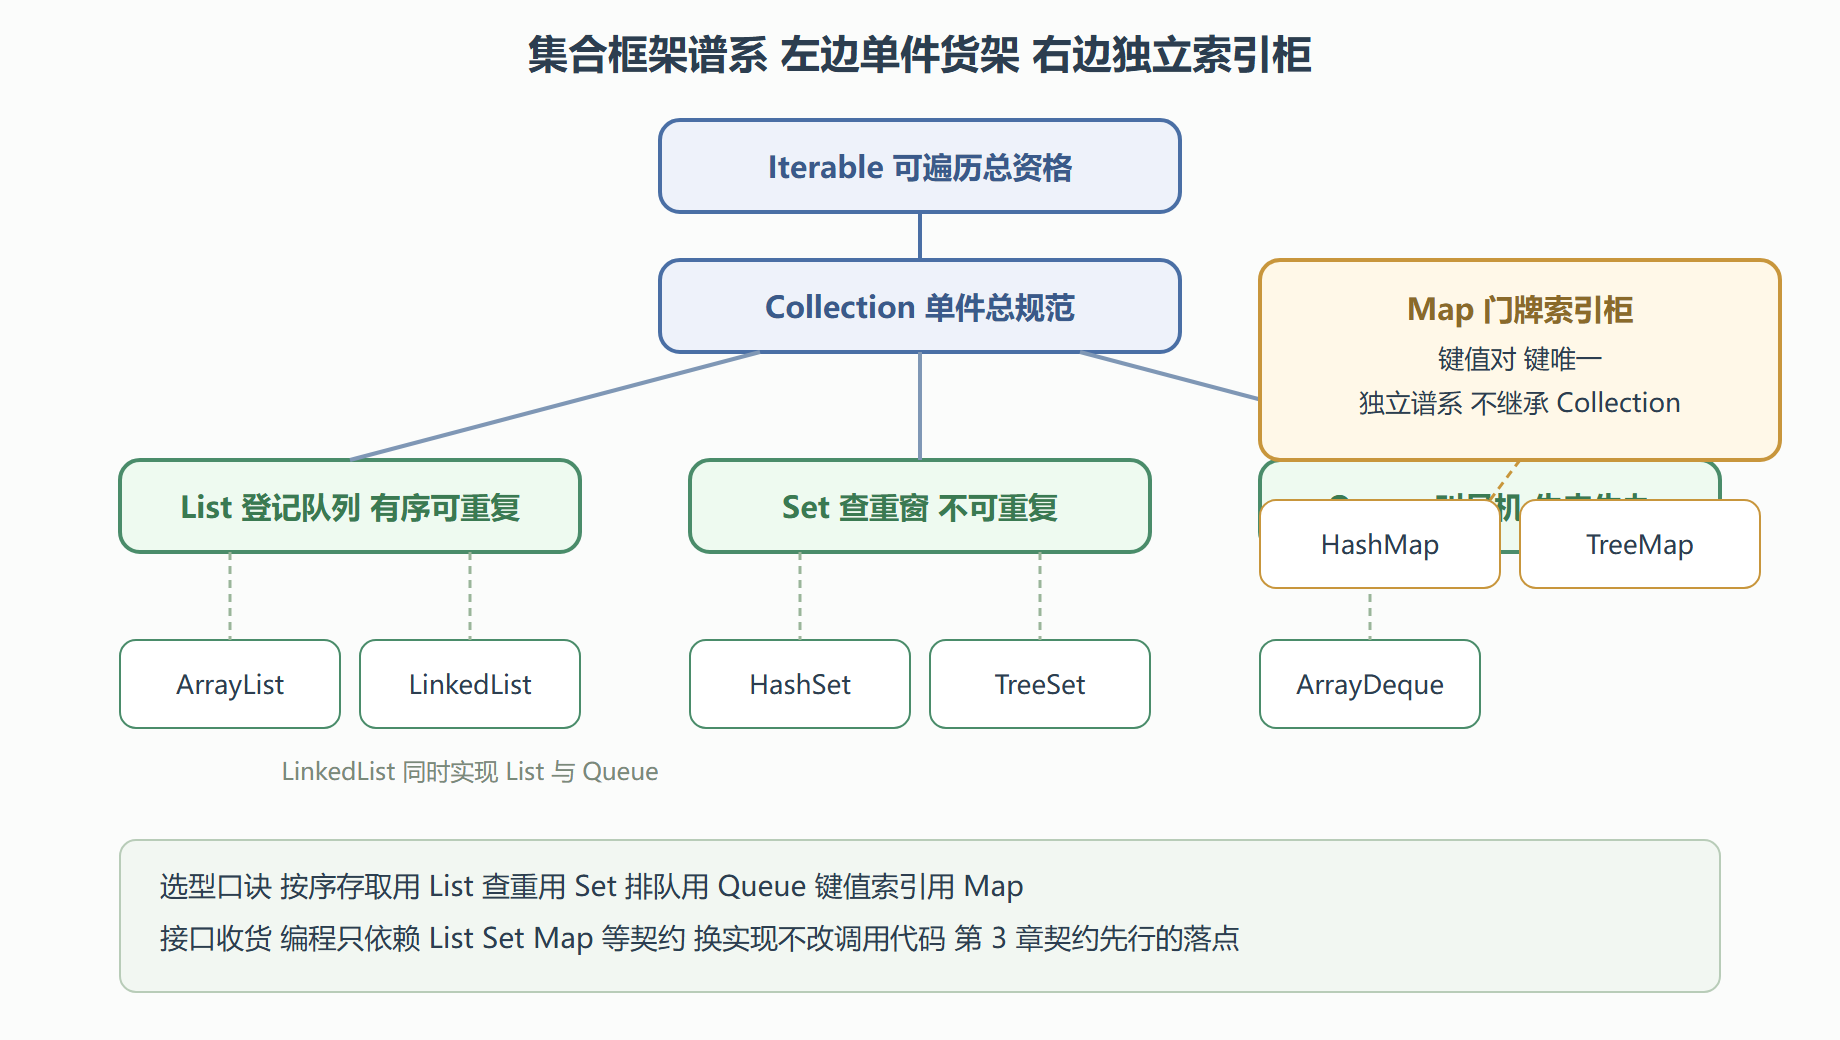
图里还有一处容易被忽视的细节:LinkedList 同时出现在 List 与 Queue 两个分支下——它一个类实现了两份契约(3.2 节多实现的实例),既是队列又是列表。
List 的两种底子:实测见分晓
List 契约保证"按下标存取、有序、可重复"。两种主流实现的差别全在底层结构:ArrayList 是动态数组——元素在内存里连成一片,按下标一步定位,但中间插删要挪后面所有元素,装满了要扩容拷贝;LinkedList 是双向链表——每个节点记着前后邻居,头尾插删只改几个引用,但按下标访问要从头(或尾)一个个数过去。
背景:选型不能靠背结论,动手测。操作:对同样规模的数据各做四组操作并计时:
import java.util.ArrayList; import java.util.LinkedList; import java.util.List; public class ListBench { public static void main(String[] args) { int n = 200000; List<Integer> al = new ArrayList<>(); List<Integer> ll = new LinkedList<>(); long t0 = System.currentTimeMillis(); for (int i = 0; i < n; i++) al.add(i); // 尾部追加 long t1 = System.currentTimeMillis(); for (int i = 0; i < n; i++) ll.add(i); long t2 = System.currentTimeMillis(); System.out.println("尾部追加毫秒 ArrayList:" + (t1 - t0) + " LinkedList:" + (t2 - t1)); // 实测量级:两者都很快 数组略优 long s = 0; for (int k = 0; k < 1000; k++) s += al.get(k * 100); // 随机访问 long t3 = System.currentTimeMillis(); for (int k = 0; k < 1000; k++) s += ll.get(k * 100); long t4 = System.currentTimeMillis(); System.out.println("随机访问毫秒 ArrayList:" + (t3 - t2) + " LinkedList:" + (t4 - t3)); // 实测量级:ArrayList 接近零毫秒 LinkedList 达到秒级 差距悬殊 for (int i = 0; i < 100; i++) al.add(0, i); // 头部插入 long t5 = System.currentTimeMillis(); for (int i = 0; i < 100; i++) ll.add(0, i); long t6 = System.currentTimeMillis(); System.out.println("头部插入毫秒 ArrayList:" + (t5 - t4) + " LinkedList:" + (t6 - t5)); // 实测量级:数量小时都很快 需要放大到十万级才能看出链表占优 System.out.println("哨兵合计:" + s); } }
结果:随机访问一组差距最悬殊——数组接近零、链表秒级;尾部追加两者都快;头部插入要在十万级规模才显出链表优势。解读:ArrayList 的 get 是一次偏移量计算;LinkedList 的 get 要沿链数格子,越靠中间越惨。变式:高频头部插删 + 少量随机访问,考虑双端队列实现(5.4 节);既要随机访问又要中间插删,通常拆成两个结构或重新设计,没有两全的实现。工程默认答案:拿不准就 ArrayList——绝大多数业务是"顺序装、随机读、尾部加",它都是最优或接近最优。
List 的常用方法按"队列"语义记:add 尾部入列、add(下标, 元素) 指定位置插队、get 与 set 按下标读写、remove 按下标或按内容删第一个、size 大小、contains 查内容、indexOf 定位。注意 remove 的重载歧义:list.remove(1) 删的是下标一的元素,想删内容为整数一的对象要写 list.remove(Integer.valueOf(1))。
for-each 的底细与遍历禁忌
for-each 能遍历一切 Iterable 的实现,靠的是迭代器。它有两条纪律:遍历中不能直接用集合自身的增删方法改结构,否则抛并发修改异常——迭代器发现自己的路标和集合对不上,立刻罢工;要边遍历边删,必须走迭代器自己的 remove:
import java.util.ArrayList; import java.util.Iterator; import java.util.List; public class IterateDemo { public static void main(String[] args) { List<String> queue = new ArrayList<>(List.of("登记", "变更", "注销", "变更")); // 错误示范(会抛 ConcurrentModificationException): // for (String s : queue) { if (s.equals("变更")) queue.remove(s); } // 正确姿势:迭代器删除 Iterator<String> it = queue.iterator(); while (it.hasNext()) { if (it.next().equals("变更")) it.remove(); // 删的是刚返回的元素 } System.out.println(queue); // 输出:[登记, 注销] // 按下标遍历 + 手动控制下标 同样安全(仅 List 有下标) List<Integer> nums = new ArrayList<>(List.of(1, 2, 3, 4)); for (int i = nums.size() - 1; i >= 0; i--) { if (nums.get(i) % 2 == 0) nums.remove(i); // 倒序删 避免下标错位 } System.out.println(nums); // 输出:[1, 3] } }
倒序删除那个变式值得记:正序删会让后面的元素前移、下标跳过下一个待查项,倒序删则不受影响。这个异常在多线程共享集合时也会出现——单线程"边遍历边改"只是它的最小复现场景,并发场景的解法在第 8 章之后再说。
本节要点回顾
- 谱系三句话:Collection 下分 List、Set、Queue;Map 独立成系不继承 Collection;LinkedList 一个类持两张证(List 与 Queue)
- 结构决定快慢:ArrayList 动态数组随机访问快、中间插删挪元素;LinkedList 双向链表头尾插删快、随机访问慢——实测差距在随机访问上最悬殊
- 拿不准选 ArrayList:业务主流是顺序装随机读尾部加,它是默认最优解
- remove 有重载歧义:按下标删与按内容删共用一个名字,删整数内容要显式包装
- 遍历中改结构必须走迭代器:直接调集合的增删方法抛并发修改异常;按下标遍历时倒序删除可避开错位
队列看完了,下一节看查重窗口:Set 怎么靠 hashCode 与 equals 两步判重(第 2.3 节的契约在这里被机器强制执行),TreeSet 又怎么让住户排好队。