1.2 手工种菜的崩溃现场:编排要解决的难题
1.2 手工种菜的崩溃现场:编排要解决的难题
本节摘要:当容器从一两只花盆变成一片田,手工管理的账就开始还不清了:故障靠人爬起来、扩容靠手数、地址天天变、配置散落各处、换版本像走钢丝。本节用一个还原度很高的"事故夜"把这些痛点串成完整过程,再归纳出编排系统必须具备的能力清单,为 Kubernetes 的登场铺好需求侧的理由。
还原一个事故夜
想象你是绿荫书屋唯一的运维(其实就是兼职的后端工程师)。业务上了三个月,机器上攒下小二十只花盆:网页盆、接口盆、缓存盆、两盆数据库从库,还有一堆杂活盆。某个周五夜里,值班手机响了。
第一件事,网页打不开。你睡眼惺忪地登机器敲命令:
docker ps # CONTAINER ID IMAGE STATUS # 3f9c2e4a1b8d greenlib/web:0.9.1 Up 4 days # 9a71d0c2e5ff greenlib/web:0.9.1 Restarting (1) 26 seconds ago # 71b0e93ac1d2 greenlib/api:0.7.0 Exited (137) 12 minutes ago # ...(以下省略十几行)
第二只网页盆在无限重启,接口盆干脆退出了。你翻出自己上个月写的抢救脚本:
bash rescue.sh api # rescue.sh 内容节选(当年引以为傲,如今句句打脸): # docker rm -f greenlib-api # docker run -d --name greenlib-api --restart=always \ # -e DB_HOST=10.2.1.17 -e DB_PASS='****' greenlib/api:0.7.0 # 输出:容器起来了,但 DB_HOST 是上个月的内网地址,库里早搬过家了
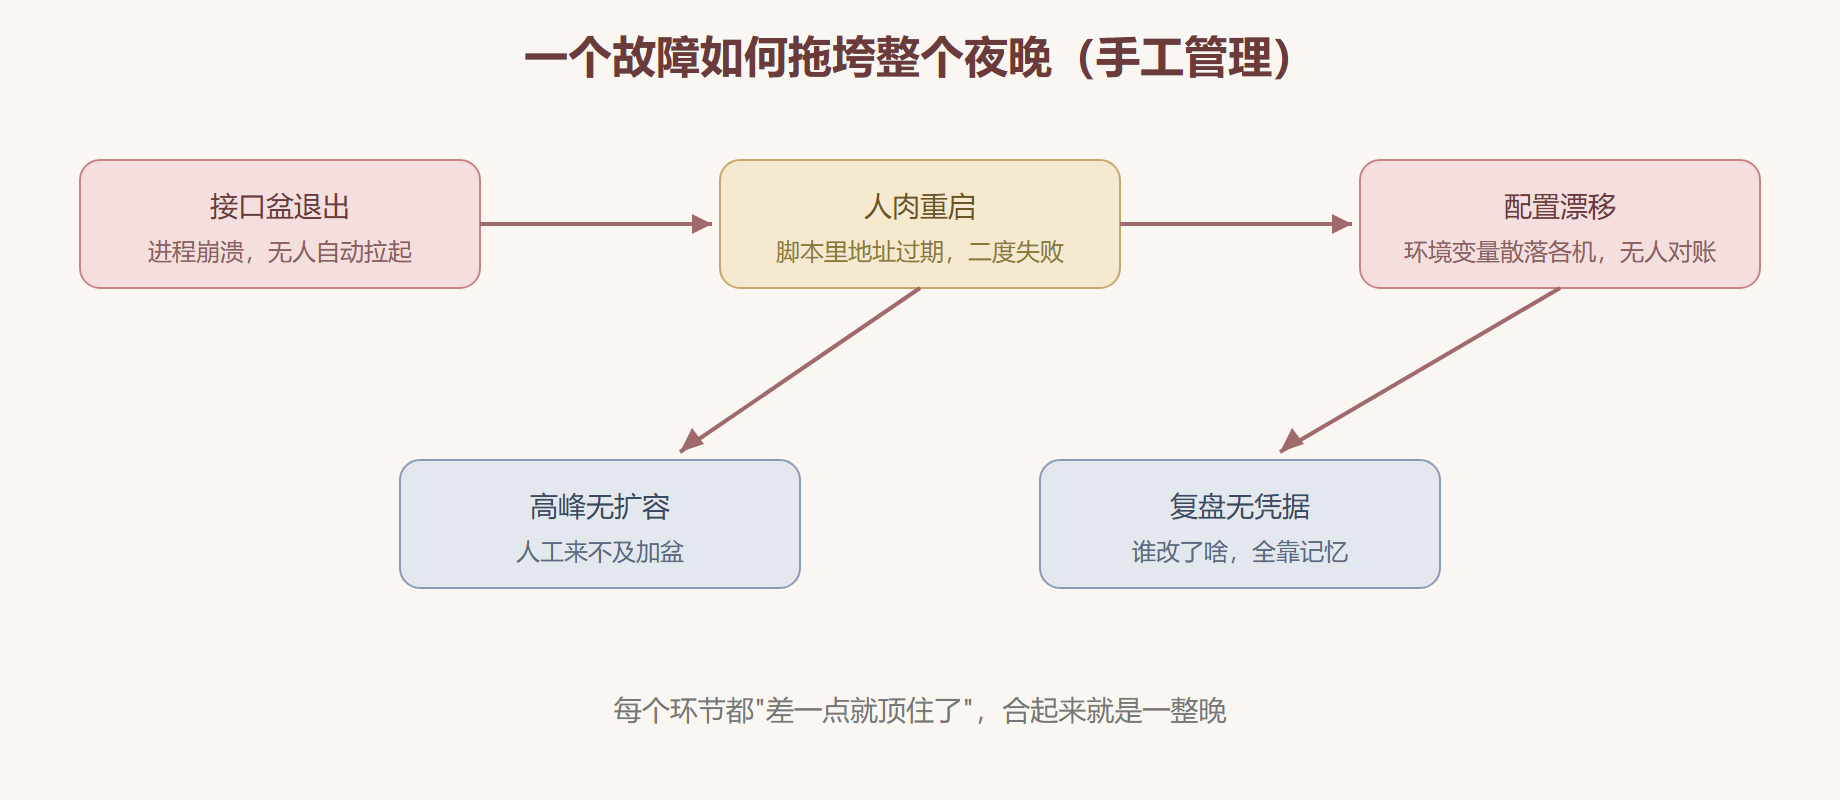
接口盆起来了,却又立刻退出:它拿着过期半个月的数据库地址在连一个不存在的机器。你翻了十分钟聊天记录才找到新地址。等一切平息,天亮了。更糟的是周一复盘时你发现:那晚流量高峰本该加两只网页盆,你根本来不及加。
图:事故夜的雪崩链
把事故拆成需求清单
这个夜晚没有单一"元凶",它暴露的是一批系统性缺口。逐条拆开,正好得到一份编排系统的需求清单:
- 自愈:盆摔了要有东西自动扶。不该由人盯着
docker ps的 STATUS 列。 - 可伸缩:流量来了按需加盆、走了按需减盆,高峰不应该依赖值班工程师的手速。
- 服务发现:盆的地址随起随变,调用方不能靠聊天记录里的旧 IP 活着。
- 负载均衡:多只同种盆之间要均匀分摊流量,不能一只撑死一只闲死。
- 配置与密钥集中:数据库地址、密码这类东西要有一处权威来源,改一处、处处生效。
- 滚动更新与回滚:换版本不许停服,坏了要能一秒回到上一个好版本。
- 存储跟进:数据库盆搬家,数据要跟着走,不能盆毁数据亡。
⚠️ 常见误区:以为编排就是"批量启动容器"。批量启动只是最浅的一层,真正的分水岭在于期望状态由谁维护——人维护,就是脚本运维;系统维护,才是编排。
用一张表给痛点定级
并非所有痛点都同样致命,实际工程里的优先级大致如下:
| 痛点 | 出现频率 | 手工代价 | 编排系统给出的能力 |
|---|---|---|---|
| 故障自愈 | 每周都有 | 夜间爬起,恢复慢 | 健康检查加重启策略 |
| 地址漂移 | 每次重建容器 | 全员改配置 | 稳定服务名加域名解析 |
| 版本更新 | 每个迭代 | 停机窗口 | 滚动更新,逐个换盆 |
| 流量伸缩 | 高峰期 | 手动加机器 | 按指标自动加减盆 |
| 配置漂移 | 每次环境变更 | 逐台对账 | 配置对象统一下发 |
| 数据持久 | 有状态服务 | 冷备脚本 | 卷声明与挂载 |
我个人的判断是:头两行是"要不要上编排"的分水岭。如果你的系统只有几只盆、夜里从不报警,先不编排也活得下去;一旦自愈和服务发现开始吃掉你的睡眠,就该考虑换一种经营方式了。
换一种经营方式的雏形
回看需求清单,会发现它们指向同一个方向:得有一个不睡觉的角色,始终知道"田里应该长什么样",并不停把田的实际状态往那个方向扳。它不等你下命令,它等你交期望。这正是下一节 Kubernetes 的立身之本。此刻绿荫书屋的处境也很清楚:业务在长,盆在变多,兼职运维的模式已经到头,需要一套制度而不是一份更长的抢救脚本。
编排之前,人们用过哪些过渡方案
把时钟拨回编排普及之前,工程师们并非坐以待毙,几套过渡方案各有各的天花板:
- 重启策略加巡检脚本:给容器配自动重启,再写脚本补漏。能扛单盆猝死,扛不住整机宕机与地址漂移,脚本自己还会长成新的故障源。
- 配置管理工具批量改机器:能批量,但本质仍是命令式——剧本重跑的后果难以预料,期望与实际依旧两本账。
- 进程守护加服务注册:每台机器装守护器,起停后注册地址。注册中心成了新的单点与新的运维对象。
这些方案共同的盲区:它们都在管理"动作",没有人持有"期望状态"。动作会失败、会乱序、会被遗忘;期望一旦写下,就不会自己消失——这正是编排系统换赛道的地方。
给自己项目做一次体检
把事故夜拆出的需求补全成一张核对表,拿去给自己在做的项目打钩:
| 需求 | 现在的解法 | 若答案是人,风险等级 |
|---|---|---|
| 故障自愈 | ? | 高:恢复时长等于响应时长 |
| 服务发现 | ? | 高:地址漂移必出事 |
| 负载均衡 | ? | 中:闲忙不均浪费资源 |
| 弹性伸缩 | ? | 中:高峰体验与成本二选一 |
| 配置分发 | ? | 中:环境间漂移与不一致 |
| 滚动更新 | ? | 高:停机窗口越拉越长 |
| 存储跟进 | ? | 视数据重要性而定 |
最右一列是我复盘用的一把尺子:凡是靠"人记得"来保障的条目,都在累积风险。绿荫书屋七条里五条靠人,所以它必须换活法。
常见疑问两则
编排系统会不会比手工更复杂
短期看是,长期看不是。头两周你要学概念、改清单,成本实打实;但从第一次"半夜没被叫醒"开始,收益开始复利。判断点在变更与故障的频率:频率越高,前期投入摊销得越快。
团队就两三个服务,也要编排吗
不必急着上。先把手写脚本沉淀成清单、把配置从镜像里拿出来(第五章的做法不依赖集群规模),等自愈与服务发现的真实痛感出现再迁。工具为问题服务,别反过来。
本节要点回顾
- 事故的本质:手工模式下,期望状态存在人的脑子和脚本里,必然漂移
- 自愈与服务发现是最先咬人的两个缺口,也是编排的入门理由
- 配置、更新、伸缩、存储紧随其后,构成完整的编排需求面
- 编排的分水岭不在"批量启停",而在"期望状态由系统维护"
- 下一节看 Kubernetes 如何把这份需求清单变成一套可落地的田亩制度