4.1 Service:给苗圃装固定水闸
4.1 Service:给苗圃装固定水闸
本节摘要:Service 为一组(通过 Label Selector 选中的)Pod 提供稳定的虚拟 IP 与统一端口,并在成员更替时自动更新转发名单。ClusterIP 型服务集群内可用,NodePort 型在每台节点开闸,LoadBalancer 型联动云上负载均衡。本节为绿荫书屋网页装闸,拆解 Endpoints 的跟踪机制,并给出三种闸型的选型建议。
先问一个问题
第三章末尾留了个悬念:补种的新苗 IP 和死掉的老苗不一样,调用方手里攥着的地址很快作废。哪怕你想到"用 Deployment 的名字去访问"也没用——Deployment 只是份计划书,它自己没有地址。那调用方到底该记住什么?
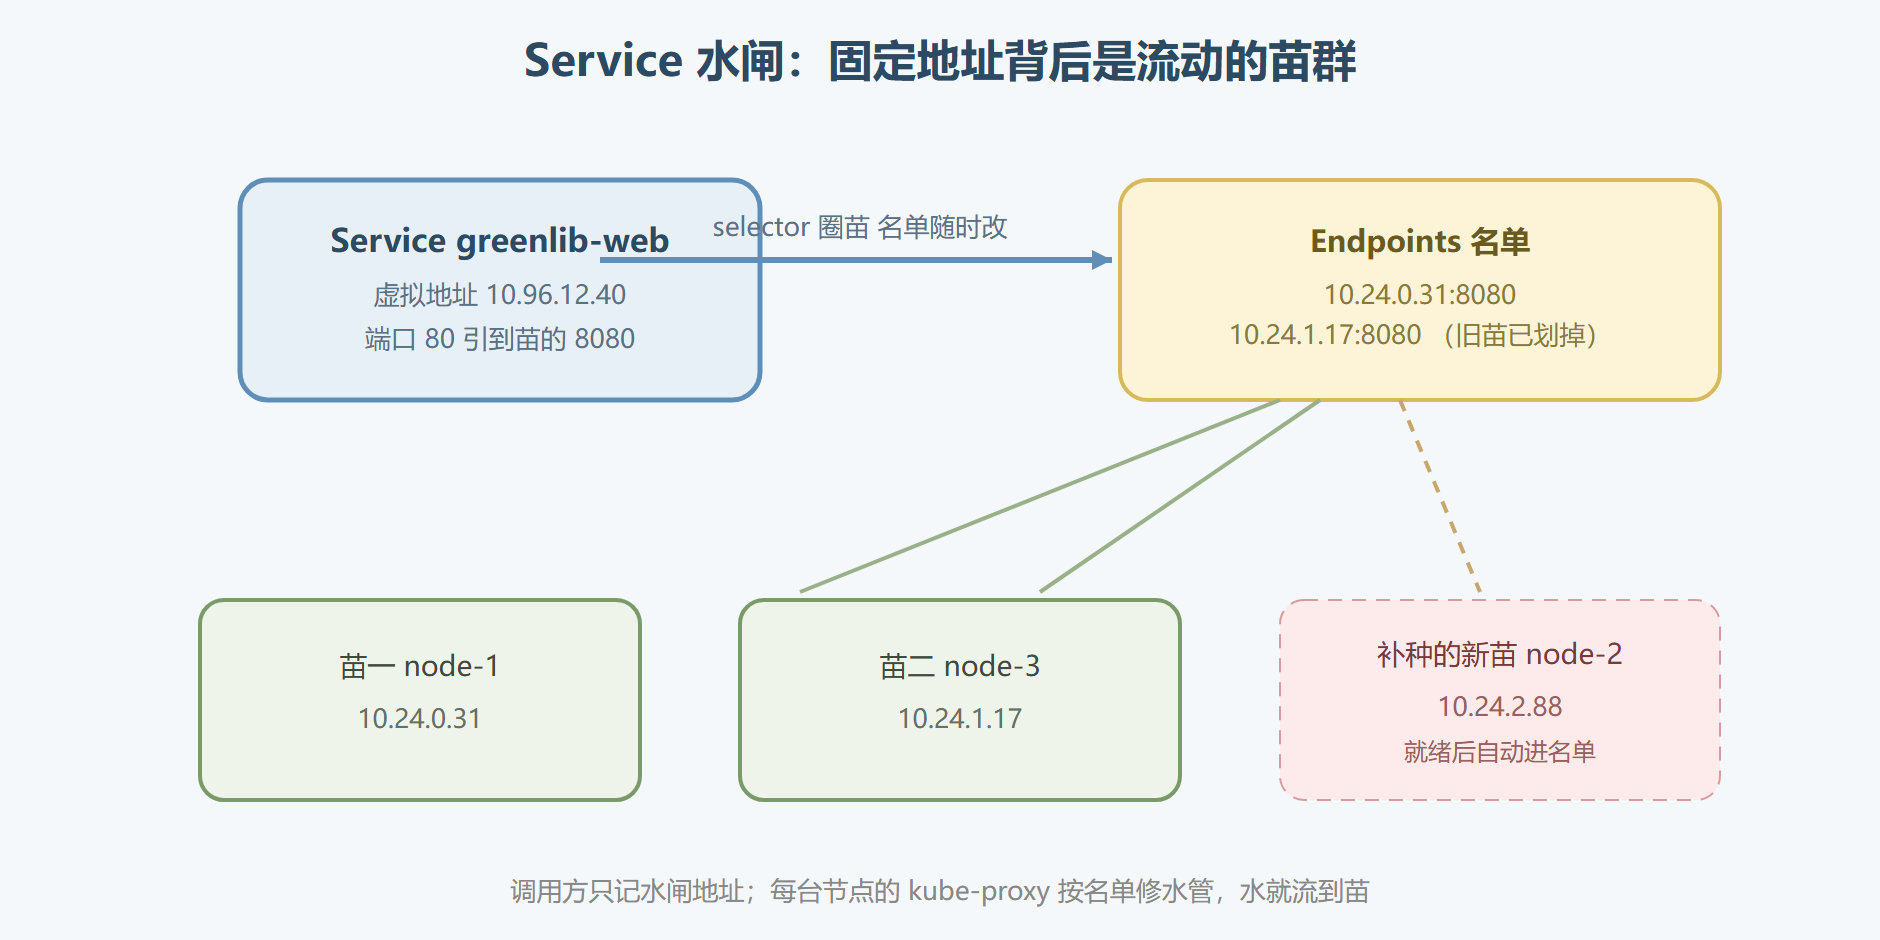
答案是一个新对象:Service。它做一个朴素而关键的动作——给一群苗立一个固定取水口。取水口有稳定的虚拟 IP(ClusterIP)和端口号,水流进来后,按需分给后面那群苗;苗的增减死活,取水口自己跟着改道,调用方毫无感知。手册叫它水闸:渠是固定的,渠后面的苗随便换。
图:水闸与苗群的跟踪关系
给网页苗装闸
清单只需几行,认苗规则又是熟悉的面孔:
# 水闸清单:给网页苗群一个固定取水口 apiVersion: v1 kind: Service metadata: name: greenlib-web # 闸名,也是第四章 DNS 要用的服务名 namespace: greenlib-prod spec: type: ClusterIP # 闸型:集群内可用(默认) selector: app: greenlib-web # 认苗规则:与 Deployment 的苗牌对上 ports: - port: 80 # 闸的对外端口 targetPort: 8080 # 水流到苗身上的端口
kubectl apply -f web-service.yaml -n greenlib-prod # service/greenlib-web created kubectl get svc greenlib-web -n greenlib-prod # NAME TYPE CLUSTER-IP PORT(S) AGE # greenlib-web ClusterIP 10.96.12.40 80/TCP 20s # 水闸背后的名单(Endpoints)才是真相所在 kubectl get endpoints greenlib-web -n greenlib-prod # NAME ENDPOINTS AGE # greenlib-web 10.24.0.31:8080,10.24.1.17:8080 20s # 两株苗就绪 各占一条水路;拔掉一株 名单几秒内就少一行
注意机制上的闭环:Service 与 Deployment 互不认识,它们只通过 app: greenlib-web 这块苗牌产生默契。这又是声明式系统的漂亮之处——两个独立单据靠台账里的标签撮合,谁也不依赖谁的创建顺序。名单的维护者不是 Service 本体,而是一个叫 EndpointSlice 的幕后园丁,它 watch 苗的就绪状态,就绪进名单、失联划掉。
三种闸型怎么选
ClusterIP 只在集群内开闸。要给外部供水,还有两种闸型:
| 闸型 | 开闸方式 | 适用 | 注意 |
|---|---|---|---|
| ClusterIP | 集群内虚拟 IP | 服务互访的默认选择 | 外部不可达 |
| NodePort | 每台节点开一个高位端口 | 无负载均衡器时的快速外露 | 端口范围有限、节点 IP 暴露 |
| LoadBalancer | 云厂商分配负载均衡器 | 云上生产外露的正路 | 产生云费用、依赖云环境 |
NodePort 版清单只改两行:
spec: type: NodePort # 改闸型 ports: - port: 80 targetPort: 8080 nodePort: 30080 # 指定节点上的闸口(不写则自动分配)
kubectl apply -f web-service-nodeport.yaml -n greenlib-prod kubectl get svc greenlib-web -n greenlib-prod # NAME TYPE CLUSTER-IP PORT(S) AGE # greenlib-web NodePort 10.96.12.40 80:30080/TCP 8s # 访问方式:任意节点的 IP 冒号 30080 # 验证水路(在集群内任一苗上执行) kubectl run curl-probe --rm -it --image=curlimages/curl:8.6 --restart=Never -- \ curl -s -o /dev/null -w "%{http_code}\n" http://greenlib-web.greenlib-prod.svc.cluster.local # 200 # pod "curl-probe" deleted # 水闸通了:这个名字能解析、能取水,下一节讲为什么
实践中我的建议:集群内互访一律 ClusterIP;外露入口优先走 4.3 的 Ingress,而不是大量开 NodePort——每个 NodePort 都要在所有节点上开洞,洞多了防火墙策略就管不过来。LoadBalancer 型留给确实需要四层直通的服务(如数据库外露给办公网),书屋入门阶段用不到。
⚠️ 常见坑:水闸建了,Endpoints 却是空的。九成原因是 selector 与苗牌对不上(比如苗牌是 app=greenlib-web,闸上写成了 app=web)。排查口诀:先看 endpoints 名单,再看 selector 拼写,最后看苗是否 Ready——没就绪的苗不进名单。
关于服务代理的一句提醒
水闸本身不搬水,真正分流的是各节点的 kube-proxy 按名单修的本地规则(2.2 埋过伏笔)。由此带来两个实践现象:其一,名单更新有几秒延迟,刚就绪的苗不会瞬间接到流量;其二,若某节点的 kube-proxy 异常,只有落到该节点的访问会受影响。排查"部分请求不通"时,别忘了这位住在每台机器里的水路工。
本节要点回顾
- Service = 固定地址加动态名单:地址记在调用方脑子里,名单由就绪状态驱动
- ClusterIP 集群内用,NodePort 快速外露,LoadBalancer 云上正路,按场景选型
- Service 与 Deployment 只靠苗牌撮合,无创建顺序依赖
- 排查水闸问题先看 Endpoints 名单,空名单查 selector 与就绪状态
- 下一节钻到地下看根系:Pod 网络模型与 DNS,解释那条长名字为何能解析