7.3 Requests与Limits:水肥的度量衡
7.3 Requests 与 Limits:水肥的度量衡
本节摘要:Requests 是苗向调度器申报的最低水肥额度(选地依据),Limits 是单株苗的用水上限(超内存被掐、超 CPU 被压速)。两者的有无组合出三级服务质量等级,直接影响拥挤时的淘汰顺序。配好度量衡之后,水平自动伸缩(HPA)让株数跟着负载走。本节为书屋立度量、装 HPA,并回收 7.1 埋下的内存超限线索。
先立个度量衡
到此为止书屋的苗都没报过饭量。这带来两个问题:调度器选地时只能瞎估(所有苗都报零,节点就被超卖成灾难现场);真挤起来时,系统不知道先掐谁。Requests 与 Limits 就是水肥的度量衡,写进播种单每个容器的 resources 字段:
# 播种单的资源声明(Deployment 模板节选) spec: containers: - name: api image: greenlib/api:2.0.0 resources: requests: # 申报:我至少要这些(调度按它选地) cpu: 100m # 单位 m 是毫核(千分之一核) 100m 即十分之一核 memory: 256Mi # 兆字节 二进制记法 limits: # 上限:最多用这些(超限有处置) cpu: 500m memory: 512Mi
两行语义分清楚:requests 是申购,limits 是配给。调度器只看 requests——它把各节点"申报总和"与家底相减,余粮够才把种子派过去(回顾 2.2 的 describe node 输出,Allocated 那几行就是申购总和)。运行时主要看 limits——内存超限的苗会被直接掐死(7.1 那个 OOMKilled 的接口苗正是死于这行),CPU 超限则是压速不掐死(限流,让苗慢下来)。
图:一块田的水位账
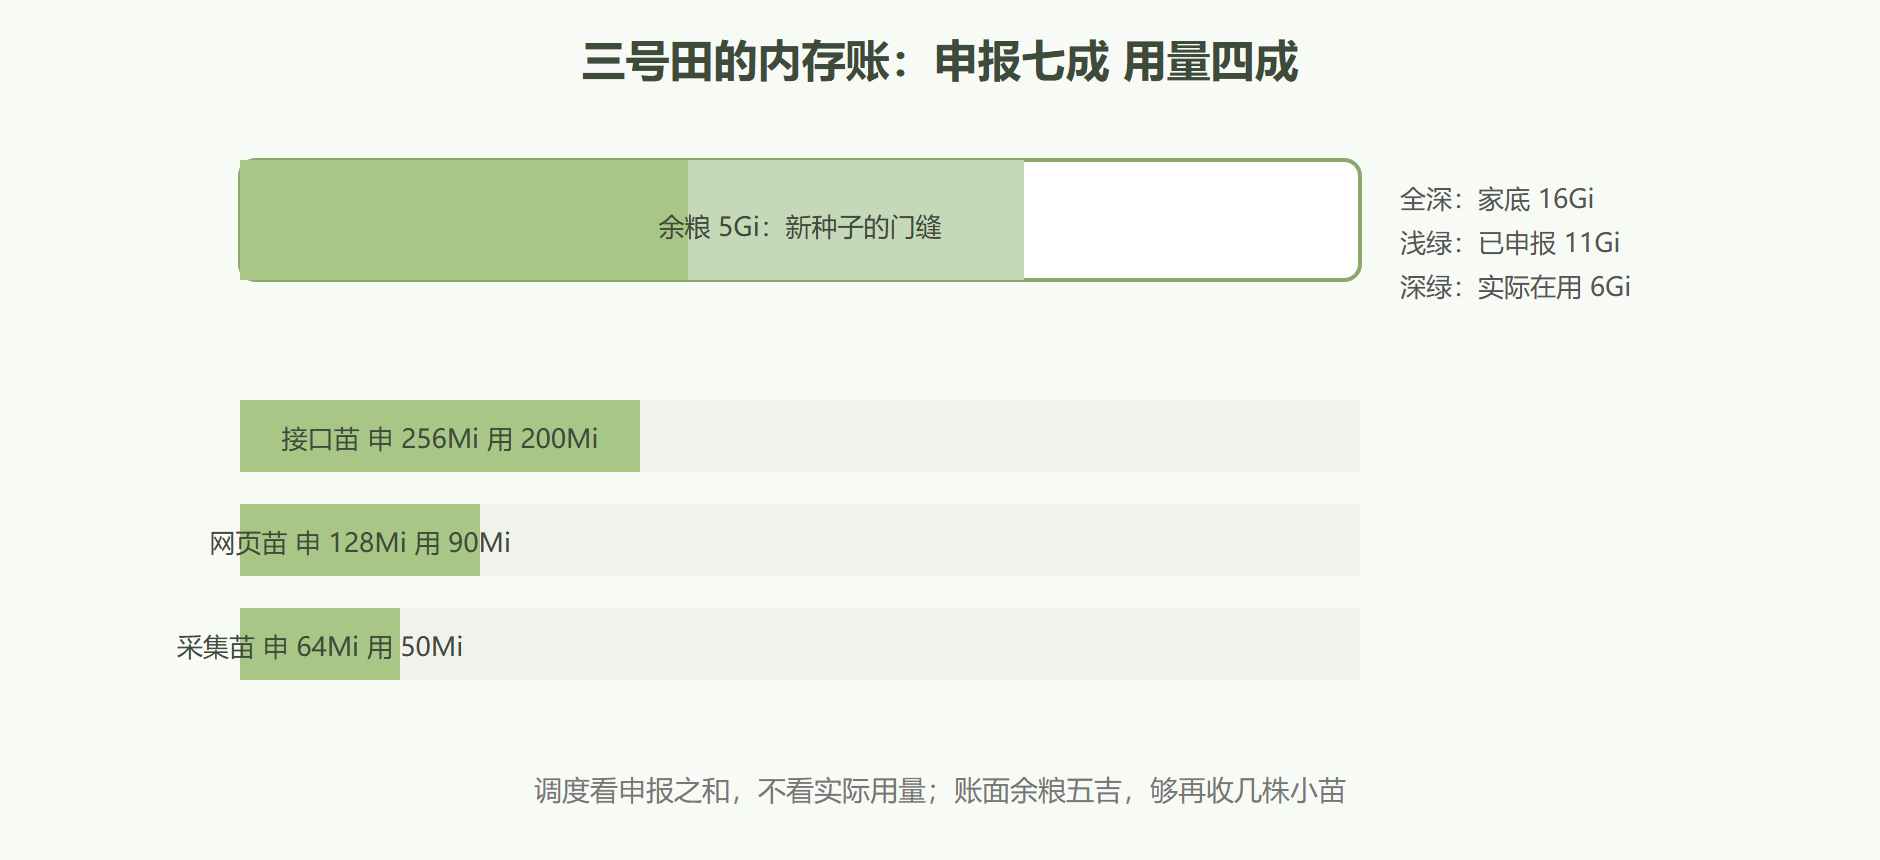
一个必须建立的直觉:调度器看的是申报账,不是用量账。图里实际只用了四成,但只要申报满了,新种子就进不来——这是刻意为之的保守设计,防止全体苗同时开饭时把田吃穿。代价是"账面满了、实际空着"的常见抱怨,解法是校准申报额,而不是拆掉度量衡。
三级服务等级
requests 与 limits 的四种组合(配没配、配多少)会落进三级服务质量等级(QoS),它决定内存饥荒时谁先被牺牲:
| 等级 | 条件 | 拥挤时的命运 |
|---|---|---|
| Guaranteed | requests 与 limits 完全相等 | 最不容易被牺牲 |
| Burstable | 有声明但不相等 | 超出申报越多的越先牺牲 |
| BestEffort | 什么都没写 | 第一个被牺牲,且调度无依据 |
kubectl get pod -o jsonpath 里能看到每株苗的等级。实践建议:业务苗至少写 Burstable,关键苗写 Guaranteed,永远不要交白卷。书屋那个 OOMKilled 的接口苗,事后复盘就是没写 resources 的 BestEffort——被掐时连申诉的申报额都没有。
# 给接口苗立度量后(上文清单已 apply),看它在节点账上的位置 kubectl describe node node-3 | grep -A 3 "Allocated resources" # CPU Requests: 3100m (38%) # Memory Requests: 11264Mi (34%) # CPU Limits: 6000m (75%) # Memory Limits: 12288Mi (37%) # 你的苗的申报额已经汇入这块田的总账
田与田之间还能再立一道总闸:ResourceQuota 限定某块责任田的申报总额(比如开发田最多两核四吉),防一个团队吃光整个集群;LimitRange 则给田里"忘记写 resources 的苗"自动补默认值。这两个对象都是田级别的清单,入门阶段知道它们守的是哪道门即可。
自动伸缩:让株数跟天走
度量立好后,最出彩的应用是水平自动伸缩(HPA):盯着某项指标(常见是 CPU 用量相对申报额的百分比),超线加苗、低线减苗。书屋的接口组每到晚间借阅高峰就吃紧,正适合:
# 自动伸缩规则:接口苗二到六株 CPU 目标六成 apiVersion: autoscaling/v2 kind: HorizontalPodAutoscaler metadata: name: api-scaler namespace: greenlib-prod spec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: greenlib-api # 管辖对象 minReplicas: 2 # 地板:再闲也留两株 maxReplicas: 6 # 天花板:再忙不过六株 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 60 # 平均用量超申报六成就加苗
kubectl apply -f api-hpa.yaml -n greenlib-prod # horizontalpodautoscaler.autoscaling/api-scaler created kubectl get hpa api-scaler -n greenlib-prod -w # NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS # api-scaler Deployment/greenlib-api 78%/60% 2 6 2 # api-scaler Deployment/greenlib-api 78%/60% 2 6 3 # api-scaler Deployment/greenlib-api 91%/60% 2 6 4 # 傍晚高峰:目标线六成 实际近九成 株数从二加到四 kubectl top pods -n greenlib-prod | grep api # greenlib-api-... 148m 389Mi # 摊薄后单株 CPU 降到申报额的一半以下 加苗的目的达成
HPA 能算出百分比,前提正是每株苗都写了 requests——没有度量衡的田装不了自动灌溉。这也是本节标题把两件事绑在一起的原因:度量衡是因,自动伸缩是果。另外注意伸缩的是 Deployment 的 replicas 字段,苗还是那些苗,只是数量随天变;顺带提醒,手动 scale 与 HPA 会打架,装了 HPA 的组别再手 scale。
⚠️ 常见坑:HPA 疯狂加苗却压不下用量。九成是"指标病"——比如应用内存泄漏,加多少苗都是每株都满,CPU 指标下却表现为目标永远达不成,苗加到天花板。看到 REPLICAS 顶到 max 还不见指标回落,别急着调 HPA,先 top 看看是不是苗本身病了。
本节要点回顾
- requests 申购给调度器,limits 配给给运行时:超内存被掐,超 CPU 被压速
- 调度看申报账不看用量账,申报额要校准,宁准勿虚
- QoS 三级:Guaranteed、Burstable、BestEffort——别交白卷
- ResourceQuota 管田总额,LimitRange 补默认值,都是田级闸门
- HPA 靠 requests 算百分比:有度量才有自动伸缩;指标不降反顶格时先查苗病