3.2 核心NLP技术在内容分析中的应用
3.2 核心NLP技术在内容分析中的应用
本节摘要:本节展开内容分析的五件套技术:文本分类(含风险预警)、情感分析(文档级、句子级到方面级三级粒度)、主题模型(潜在狄利克雷分配、非负矩阵分解、基于嵌入的主题三代演进)、文本摘要(抽取式与生成式)、关键词提取(统计法与图排序法),外加关系与事件抽取。每项技术讲清"怎么做、怎么选、坑在哪",主线索是一条被讽刺评论骗过的情感分析系统的修复过程。
学习目标
阅读完本节,你应当能够:
- 为情感分析选择合适的粒度(文档级、句子级、方面级)并说明判断依据;
- 对比三代主题模型的原理差异与适用语料;
- 区分抽取式与生成式摘要的适用条件及评估方式;
- 说出关键词提取两条路线(统计、图排序)的代表算法与场景;
- 描述关系抽取与事件抽取出什么、喂给谁。
一、被讽刺骗过的系统
某产品团队上线了评论情感分析,准确率测试集上百分之八十九,看起来很稳。上线第一周,一条热评被标成"强正面":'这设计真是绝了,单手开不了盖,设计师该拿诺贝尔奖。'模型看到"绝了""诺贝尔奖"就打了高分,没读出这是一句愤怒的反话。同类误判还有:"太开心了,第三次收到碎的""客服态度好到我想报警"。讽刺与反语,是情感分析的头号杀手。
这个案例引出本节的核心观点:情感分析的难度不在分类算法,而在语言现象与粒度选择。算法层面,从词典法到预训练微调已经相当成熟;真正拉开差距的是你怎么定义任务。修复上述系统的动作不是换更大的模型,而是三件事:给训练集补充标注讽刺样本;在预处理保留标点与表情("绝了"带句号和带波浪号情绪相反);把分析粒度从文档级细化到方面级——用户这条评论对设计是负面的,对物流可能是正面的,一锅搅就没法看。
二、文本分类:打标签的机器
内容分析里的分类任务清单很长:新闻按主题归类、评论按问题类型打标(功能缺陷、性能、体验、价格)、内容审核识别违规与敏感、垃圾信息过滤、风险预警(投诉倾向、法律敏感词)。算法谱系第1.4节已铺过:词频加线性模型的统计基线起步,预训练模型微调接高精度需求。这里补内容分析特有的两点。
一是标签体系设计。客服场景的意图体系由业务流程决定,内容分析的标签体系却要自己从数据里长出来——先跑无监督聚类看数据自然分几堆(下文主题模型正是干这个的),再用聚类结果指导人工设计标签,比拍脑袋定的标签体系存活率高得多。二是"打不开的抽屉"问题:分类体系要预留"其他"类并监控其占比,占比超过三成说明体系覆盖不足,该扩类了;没有出口的强制归类,会把所有长尾都挤进错误的抽屉。
三、情感分析:三个粒度三种用途
情感分析按粒度分三级,用途与成本差异明显。
文档级给整条评论打一个分,用于趋势监控与大盘统计——本周负面占比、各产品线满意度对比。它最便宜也最粗,一条"物流很快但质量差评"的评论它只能给出折中的中性,这正是它的死穴。
句子级逐句打分,用于定位问题段落——客服对话里哪几句开始情绪恶化。粒度翻细,标注成本也翻倍。
方面级是精细化的终点:对文本中提到的每个方面(物流、包装、质量、客服)分别判情感。"物流很快(正面)但包装碎了(负面)"会被拆成两条结构化结果。它贵——标注复杂、模型输出是结构化的多对——但对产品团队价值最高:抱怨到底集中在哪个方面,一表看清。方面级也是第3.3节高级洞察的原料。
技术路线上,词典法(情感词典加否定词、程度副词规则)适合冷启动与领域不强的场景;机器学习分类法在标注数据充足后接棒;当前主流是预训练模型微调,讽刺与领域歧义("慢"在赛车语境可能是褒义——追求慢镜头;"声音大"对音响是优点对冰箱是缺点)都要靠领域内标注数据喂给模型。领域适配没有捷径,通用模型直接上业务场景,精度通常掉一截。
| 粒度 | 输出 | 成本 | 典型用途 |
|---|---|---|---|
| 文档级 | 每条文本一个极性 | 低 | 趋势大盘 满意度统计 |
| 句子级 | 每句一个极性 | 中 | 问题定位 对话情绪追踪 |
| 方面级 | 各方面分别的极性 | 高 | 产品改进优先级 竞品对比 |
四、主题模型:让数据自己说它在聊什么
主题模型是无监督的:不预设类别,从语料里自动发现"潜在主题"——每个主题是词的概率分布,每篇文档是主题的混合。三代技术路线如下。
第一代潜在狄利克雷分配是经典统计模型:把文档看成主题的随机混合、主题看成词的随机混合,通过迭代推断还原这两层分布。它可解释、实现成熟,但对短文本(评论、帖子)效果差——每条文本太短,主题混合推断不稳。非负矩阵分解是同代替代:把文档词矩阵分解成两个非负矩阵的乘积,数值上常比前者稳定。第三代基于嵌入的主题方法(如结合预训练向量的聚类式主题)先用预训练模型把文档编码成语义向量,再聚类、再给每簇提炼代表词——语义理解能力显著强于词频统计,能区分"苹果手机"与"苹果水果"这两个主题,这是纯词频方法做不到的。
选型经验:长文档(报告、论文、新闻)用第一代够用且便宜;短文本语料直接上嵌入法;主题数没有解析解,按业务常识起步、用主题一致性指标扫描、最后让业务方读词表验收——人读不懂的主题再多也是废主题。主题质量的评估细节第3.4节展开。
五、摘要与关键词:压缩信息的两条路
文本摘要在内容分析里的用法与客服不同:那里压缩对话供人接手,这里压缩海量文档供人速览。抽取式从原文挑关键句,忠实无捏造,适合财报、法律文书、合规材料;生成式重新组织语言,紧凑流畅,适合资讯速览与内部简报,但需要防"加戏"。评估用面向召回的重叠指标(比对生成与参考摘要的词组、最长公共子序列重合度)加人工抽读,纯指标分数与人的阅读感受常有落差。
关键词提取两条路线。统计路线用词频逆文档频率:在某文档高频、全语料低频的词就是关键词,简单到不需要训练。图排序路线把词当节点、共现关系当边,迭代计算节点权重,代表算法能自然产出多词短语("退货运费"而非"退货运费"三个散词)。实践上短文本用统计法,长文档用图排序,效果与成本的平衡点不同。
五件套技术速查
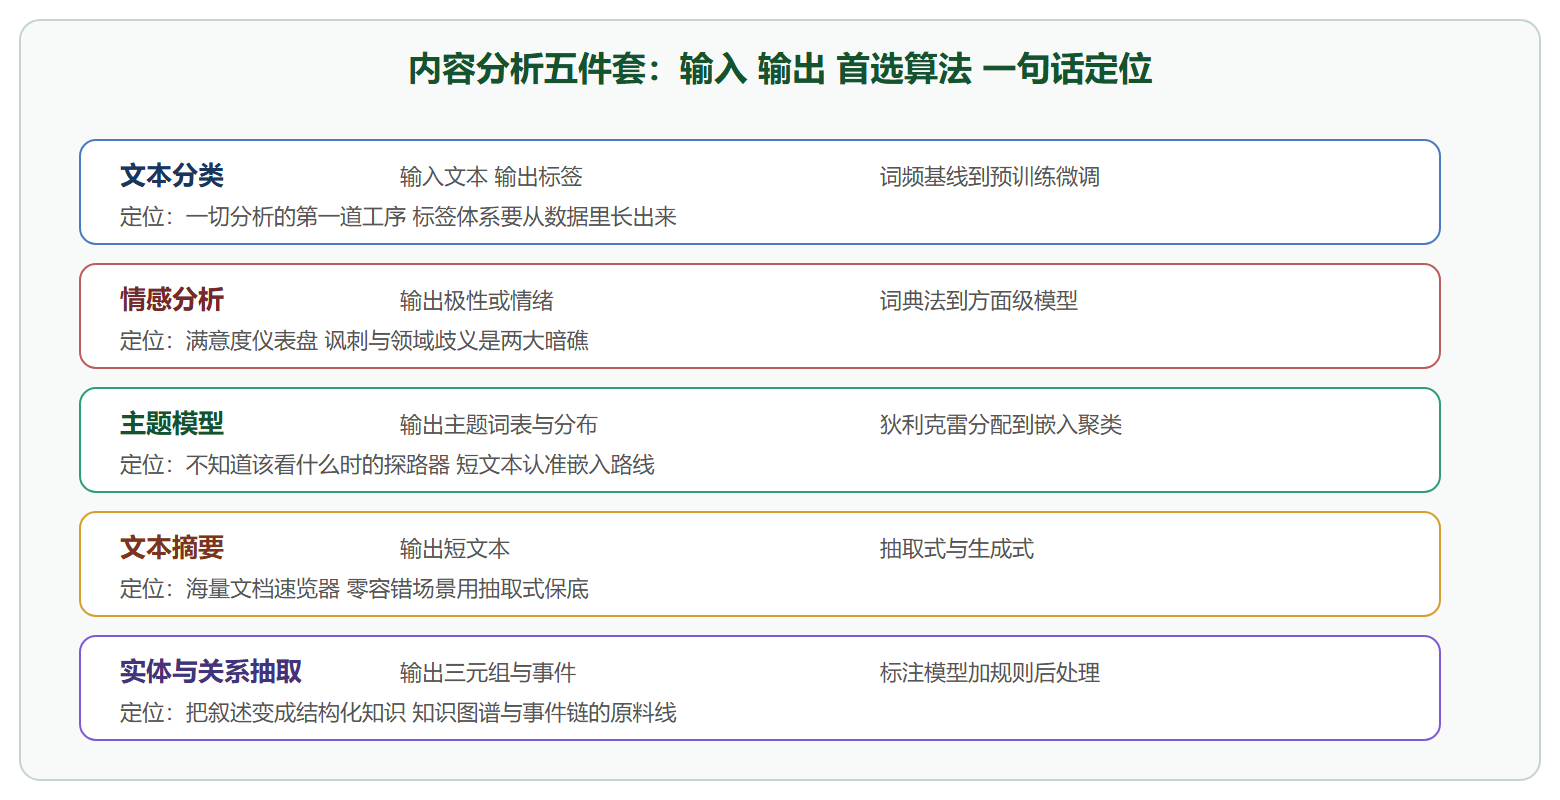
技术选型表的正确打开方式是「先业务后技术」:先问分析结果的消费者是谁(公关要预警速度、市场要趋势精度、运营要标签一致性),再倒推需要哪类方法。同一个情感分析需求,公关场景宁可快而糙(分钟级扫全量),市场场景宁可慢而准(日级抽精样),配置策略完全不同。另一个实战要点是「组合拳优于单打」:分类给出整体倾向,属性抽取定位到具体产品部件,趋势检测确认变化时机,三者拼起来才是一份能进决策会的分析,单靠任何一项都撑不起结论。
六、关系与事件抽取:从句子到结构
命名实体识别抠出"谁",关系抽取回答"谁和谁什么关系"——从"蒂姆·库克任职于苹果公司"抽出"人物—任职—机构"三元组。事件抽取再进一步,把"何时、何地、何人、发生了什么"打包成结构化事件。技术上是序列标注与联合学习的组合,工程难点在消歧(同名实体归一)与远程监督的噪声。
它们的产出直接喂给两条下游:知识图谱(第3.3节详述)与事件链分析——舆情场景把散落的报道串成一条"起因—发酵—高潮—平息"的时间线,金融场景从新闻流中抽取交易与公告事件。结构化之后的文本才好做查询、统计与推理,这是抽取族技术在内容分析里的核心价值。
⚠️ 常见坑:三个。其一,讽刺与领域歧义不设防——通用情感模型直接上业务语料,"声音大""慢"这类领域敏感词全部误判,领域内标注样本是唯一的解。其二,主题模型当成分类模型用——主题是无监督的软聚类,主题含义要人来命名和解读,指望它输出 predefined 类目必然失望。其三,抽取式摘要"复制粘贴"尴尬——关键句直接拼读起来生硬,可以在抽取后加一句轻量改写(或至少句间排序)提升可读性,不必一步跨到纯生成。
💡 关键直觉:五件套不是并列关系,是流水线关系——分类先归堆,情感再分极,主题找盲区,抽取做结构,摘要供速览。多数项目的正确起手式是"分类加情感"两件先上(有明确消费场景),主题探路(发现未知),抽取与摘要按需追加。一次性把五件套全上齐的项目,多半在第三个月烂尾。
本节速览
- 情感分析难度在语言现象与粒度:讽刺、领域歧义靠领域标注数据破解;文档级管大盘、句子级管定位、方面级管产品优先级,按用途选粒度;
- 分类的关键是标签体系:从数据里长出来而非拍脑袋,"其他"类占比是体系健康度的仪表;
- 主题模型三代演进:长文档用经典统计法、短文本认准嵌入路线,主题数靠指标扫描加人工验收;
- 摘要按容错选路线:零容错用抽取式,速览用生成式,评估要指标加人读双保险;
- 关键词两路线:短文本统计法、长文档图排序,成本与效果的平衡点不同;
- 抽取族产出结构化知识:三元组喂图谱、事件喂时间线,结构化之后文本才能被查询与推理。
单项技术到位只是及格线。下一节进入组合拳:时序追踪、跨语言统一、多模态互证、因果发现——把五件套串成真正的洞察引擎。