4.3 大语言模型与生成式AI
4.3 大语言模型与生成式AI
本节摘要:大语言模型是基于 Transformer 架构、在海量文本上预训练的巨型神经网络,通过"预测下一个词"学会语言、知识与推理;生成式人工智能以创造新内容为目标,大模型是其文本领域最成功的形态。训练范式为预训练加微调,近年又叠加基于人类反馈的强化学习实现对齐;生成机制是逐词迭代加采样策略。本节从一次"一本正经地胡说"的客服事故讲起,拆解原理,盘点大模型在客服与内容分析中的落地形态,直面幻觉、偏见、成本、可解释性四大挑战。
本节地图
阅读完本节,你应当能够:
- 解释自注意力机制为什么让模型"一步直达"长距离依赖,以及位置编码补的是什么信息;
- 描述预训练、微调、基于人类反馈的强化学习三阶段各自的目标;
- 说出生成采样的几种策略(贪婪、束搜索、带温度的随机采样)如何权衡稳定与多样;
- 列出大模型在客服与内容分析中的至少五种落地形态;
- 针对幻觉、偏见、成本、可解释性四大挑战各说出一项工程对策。
一、一本正经地胡说
某电商把大模型接进了客服。大部分时间表现惊艳——理解口语化提问、组织流畅回答,测试团队很满意。直到有用户问:"你们的退货运费险能赔到五十块吗?"模型答得斩钉截铁:"可以,最高赔付五十元。"实际上该平台运费险上限是十元。用户截图发到社交平台,配文"官方客服亲口确认",品牌被迫公开致歉。
这就是幻觉:模型生成的内容语法完美、语气自信、事实错误。它不是 bug,而是这类模型工作原理的副产品——模型学的是"什么词接在什么词后面最像样",不是"什么话是真的"。当知识库里没有对应事实时,它不会说不知道,它会按语言习惯把最像答案的话续出来。理解这一点,才能理解后面所有的落地策略为什么都围绕"约束生成"展开。
二、原理一:自注意力与 Transformer
大模型的地基是 Transformer 架构,核心是自注意力机制——第1.3节讲注意力时埋的线,这里收拢。自注意力让序列中每个词直接与所有词计算相关权重:处理"它"这个词时,模型一步算出它与句中"手机"的关联最强,无需信息沿序列逐步传递。这正是它取代循环结构的原因:长距离依赖从"接力传"变成"直连"。
两个配套组件。位置编码:注意力本身不感知顺序("我退货"与"退货我"在纯注意力眼里无差别),位置信息要显式注入词向量。多头注意力:多组注意力并行运行,各组关注不同侧面——一组盯语法关系、一组盯语义关联、一组盯指代,模型的理解因此立体。生成式大模型主流采用解码器堆叠结构:一层层多头注意力加前馈网络叠上去,参数量从数十亿到数千亿。
"大"不是虚指。参数量、训练数据量、算力消耗三者同步放大,能力的涌现与此相关——小模型学不好的推理、指令遵循、少样本学习,规模到某个量级后突然可用。这也是成本问题的源头,后文展开。
三、原理二:三阶段训练范式
预训练:在互联网规模的文本上做自监督学习,任务朴素到可笑——预测下一个词(或补全被挖掉的词)。但正是这个任务,逼着模型学会语法、语义、事实知识乃至推理模式:要预测得准,你必须"懂"上下文在讲什么。预训练产出通用底座,昂贵但一次投入多方复用。
微调:在特定任务的标注数据上继续训练,让底座适配具体场景——用客服对话微调出客服风格,用摘要对子微调出摘要能力。参数高效微调技术让这一步不必更新全部参数,成本大幅下降。
基于人类反馈的强化学习:第三阶段解决"会说话"与"说人话"的差距。人类标注员对模型的多个输出排序,训练一个奖励模型学习人类偏好,再用强化学习方法让大模型朝高奖励方向调整。效果是模型学会遵循指令、拒绝不当请求、给出更符合人类期待的回答——术语叫"对齐"。这一步也是价值观与偏见塑造的关键环节,第4.1节的伦理问题在此接棒。
值得一提的还有上下文学习:在提示词里给几个示例,模型不改一个参数就能照着做新任务。它把"定制"的成本从训练级降到提示级,是大模型快速落地的重要推手——配合检索增强(第2.2节讲过:先检索锁事实、生成管表达),构成了当前企业落地的主流组合。
四、原理三:逐词生成的采样策略
大模型生成文本的机制是逐词迭代:给定已有内容,模型为词表里每个词算一个概率分布,选一个词接上,再把新词纳入输入继续——像接力续写。选词策略分两派。
求稳派:贪婪搜索每步选概率最高者,输出稳定但容易车轱辘话;束搜索同时保留几条最优路径再挑全局最好的,更聪明也更慢。求变派:从概率分布中随机采样,其中截断采样只在概率前几名里抽、温度参数调节分布的陡峭(低温趋于保守、高温趋于奔放),给输出注入多样性。
参数选择是业务决策不是技术决策:客服回复要低温稳定(宁可平淡不可翻车),营销文案要适当高温(要的就是花样),法律与医疗场景直接禁用随机性并配人工审核。
五、落地形态:客服与内容分析各五景
客服侧。动态回复生成:理解口语化复杂提问,结合上下文与知识库生成自然回复,远超模板的表达力。座席辅助:给人工客服实时生成回复草稿、自动总结长对话要点、检索推荐知识——大模型当副驾驶,人握方向盘,这是当前投入产出比最高的形态。情绪预警:细粒度识别情绪及原因,建议升级时机。知识库自动化:从历史对话与文档自动生成与更新常见问题条目。主动服务:基于行为数据预测需求、生成个性化通知。
内容分析侧。智能摘要:长文档、会议记录、评论批量压缩。细粒度情感:识别讽刺、方面级情感(第3.2节任务的大模型解法)。主题与标签:自动归类打标,零样本覆盖新类别。知识抽取:三元组与事件抽取辅助建图谱。研究情报:快速消化报告论文、提炼趋势——分析师的读稿速度被重新定义。
| 落地形态 | 风险等级 | 人工介入 | 成熟度 |
|---|---|---|---|
| 座席辅助草稿 | 低 | 人审后发送 | 高 |
| 对话总结 | 低 | 抽检 | 高 |
| 内容分类打标 | 低 | 抽检 | 高 |
| 知识库生成 | 中 | 审核发布 | 中 |
| 直接面向用户生成 | 高 | 事实校验必备 | 谨慎推进 |
规律清晰可见:风险与"生成内容直接触达用户的程度"正相关。辅助人、服务内部流程的形态先行,直接生成给用户看的形态最后上且必须加闸。
六、四大挑战与工程对策
幻觉:对策三层——检索增强(答案须有出处,检索不到就说不知道)、置信与拒答机制(低置信转人工)、事实校验管线(关键数字与政策类回答过校验器)。开篇案例若有检索约束,模型会答"运费险赔付标准请以订单页展示为准"而不是编一个数。
偏见与安全:训练数据携带社会偏见,模型继承并可能放大;提示注入攻击(用户精心构造输入诱导模型违规)是新攻击面。对策:对齐训练与安全过滤、输入检测、输出审核、红队测试常态化。
成本:训练与推理都烧算力,高并发场景的成本压力最直观。对策:分层调度(简单任务走小模型,复杂任务才调大模型——第2章的意图识别没必要用大模型)、蒸馏与量化(第2.4节三板斧)、批处理与缓存(内容分析的批处理窗口天然省钱)。
可解释性:数十亿参数的决策过程无法逐层解释,高风险领域(金融、医疗)的落地因此受阻。对策:务实路线不追求解释模型内部,而是外置解释——记录"基于哪几条检索材料生成的回答",把可追溯性建立在输入侧而非模型侧。
大模型落地的风险分层
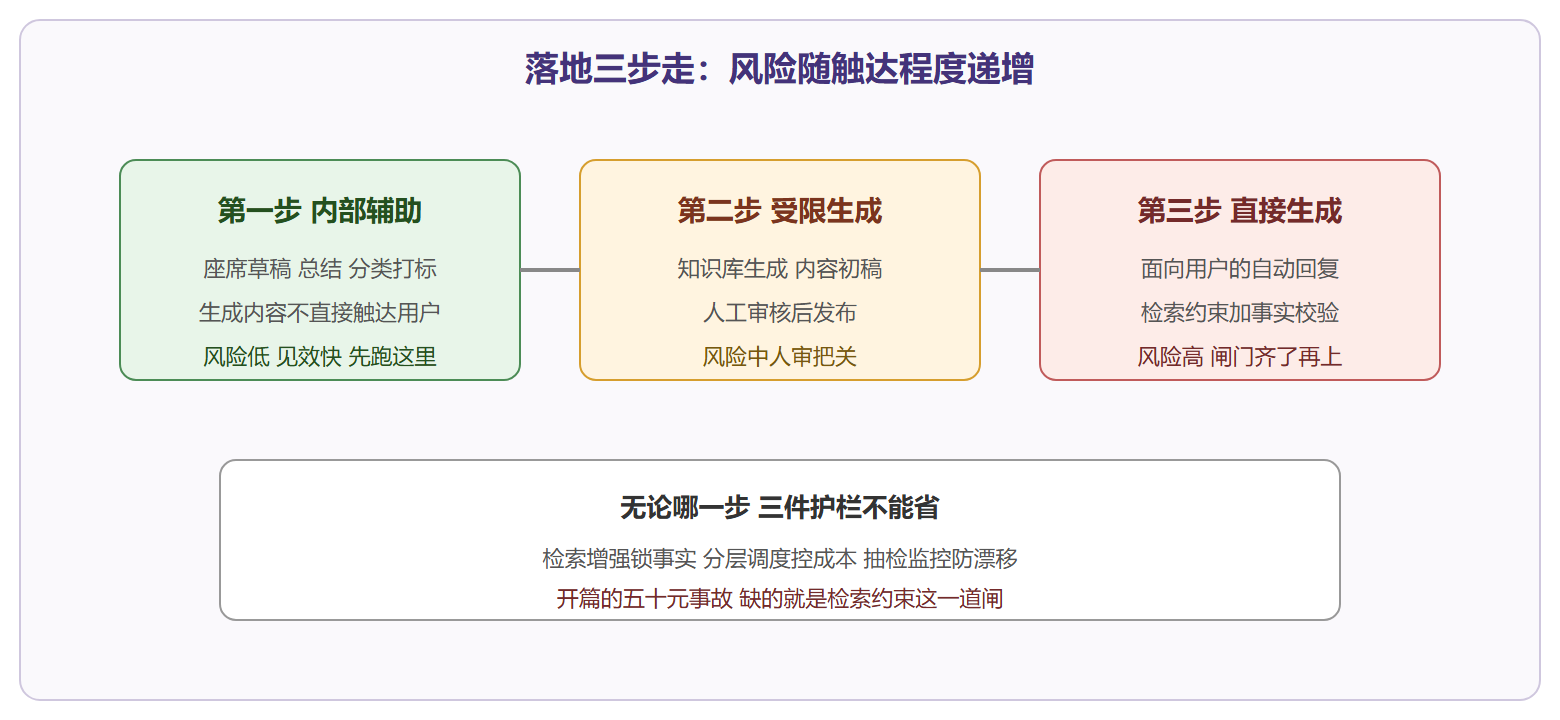
⚠️ 常见坑:三个。其一,裸奔上线——不做检索约束直接让模型自由发挥回答业务问题,开篇事故就是标准剧本。其二,全员大模型——把意图识别、实体抽取这类成熟小任务也换成大模型,延迟、成本、稳定性全线恶化;小任务用小模型是纪律不是保守。其三,拿用户对话微调不问授权——第4.1节的红线在微调场景同样生效,训练数据来源的合规审查要在启动前完成。
💡 关键直觉:大模型改变的是能力的"边际成本"——过去做一个新语种的客服、一个新的分类体系,要标注、要训练、要周期;现在写好提示词加检索库,几天就能跑起来。但边际成本的下降不等于总风险下降,恰恰因为试错变便宜了,不设闸的试错也变多了。便宜的能力更要配严格的护栏。
一节小结
- 自注意力直连长距离依赖,位置编码补顺序信息,多头并行关注多侧面,解码器堆叠构成生成式大模型;
- 三阶段范式:预训练学通用(预测下一词)、微调做适配、人类反馈强化学习对齐偏好;上下文学习与检索增强提供不动参数的轻量定制;
- 采样策略是业务决策:客服低温求稳、创作高温求变、高风险场景禁随机加人审;
- 落地五五开:客服侧座席辅助性价比最高,内容分析侧摘要与细粒度情感最先兑现;风险与生成内容触达用户的程度正相关;
- 四大挑战各配对策:幻觉靠检索增强与拒答、偏见靠对齐与红队、成本靠分层调度与压缩、可解释靠输入侧可追溯;
- 三步走路径:内部辅助、受限生成、直接生成,护栏(检索、调度、抽检)三步都不能拆。
最后一节放眼整个行业:驱动力的来源、技术趋势的方向、产业深化的路径,以及这场变革里机会与责任并存的未来图景。